
爬虫越来越难做?Python爬虫转AI大模型开发,这才是真正的出路!
说实话,这两年爬虫有多难做,你们心里都有数。
IP被封成日常,验证码越来越变态,反爬机制每天升级。
辛辛苦苦爬了一晚上的数据,一转眼被人告了。
赚的那点钱,还不够交罚款的。
更气人的是,AI工具越来越强,基础的爬虫需求直接被替代了。
以前找你帮忙爬数据的人,现在直接让ChatGPT给他整理了。
这行真的越来越难混。
Python爬虫转AI大模型开发,这条路我见过太多人走通了。
今天给你说清楚,到底怎么转,看完你就知道方向了。
🔹第一,爬虫的数据处理经验,是大模型开发中的神助攻。
你以为爬虫只是发HTTP请求、解析HTML页面?
错了。
真正的爬虫工程师,核心能力是海量数据抓取、海量数据清洗、海量数据存储。
你比大多数程序员都懂什么叫高质量数据,什么叫脏数据。
这些东西在大模型的数据工程里,全是硬通货。
大模型训练,百分之六十以上的时间都花在数据清洗和预处理上。
数据质量差,模型效果就差,这个道理谁都懂。
但真正能把数据洗干净的人,太少了。
你来了就是降维打击,因为你在爬虫阶段早就把这些活干过无数遍了。
🔹第二,从数据标注和数据微调入手,这是爬虫人转AI最好的切入点。
训练大模型需要海量高质量数据。
垂直领域的数据集更是稀缺。
爬虫经验让你天然知道什么数据是好数据,什么数据没价值。
去做数据标注工程师,做垂直领域的数据集构建,做数据质量评估。
这类岗位需求大、薪资不低、上手极快。
而且这条路越老越值钱。
不像爬虫,今天被平台封,明天被告,后天还要改代码。
数据工程是积累型工作,做得越久越吃香。
不比天天跟反爬斗法强多了?
🔹第三,把爬虫的Python能力升级成AI工程能力,这才是关键。
别再只盯着requests和BeautifulSoup了。
是时候升级你的工具箱了。
PyTorch、transformers库、向量化数据库,这些东西你Python基础已经很扎实了,学起来就是几周的事。
爬虫人有个天然优势,就是特别会折腾工具。
遇到反爬就找代理池,遇到登录就研究Cookie,遇到加密就逆向JS。
这种折腾精神,迁移到AI工具学习上,效率飞起。
你之前用过的Scrapy框架思想,和LangChain的Chain思路本质是一样的。
迁移成本很低,但薪资提升很高。
爬虫越来越难做,这不是你的问题。
是大环境变了,风口过去了。
但你在爬虫里练出来的本事,换个赛道就是王炸。
记住一句话:会爬数据的人,永远不会被AI淘汰。
因为数据是AI的命根子,而你最懂数据。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
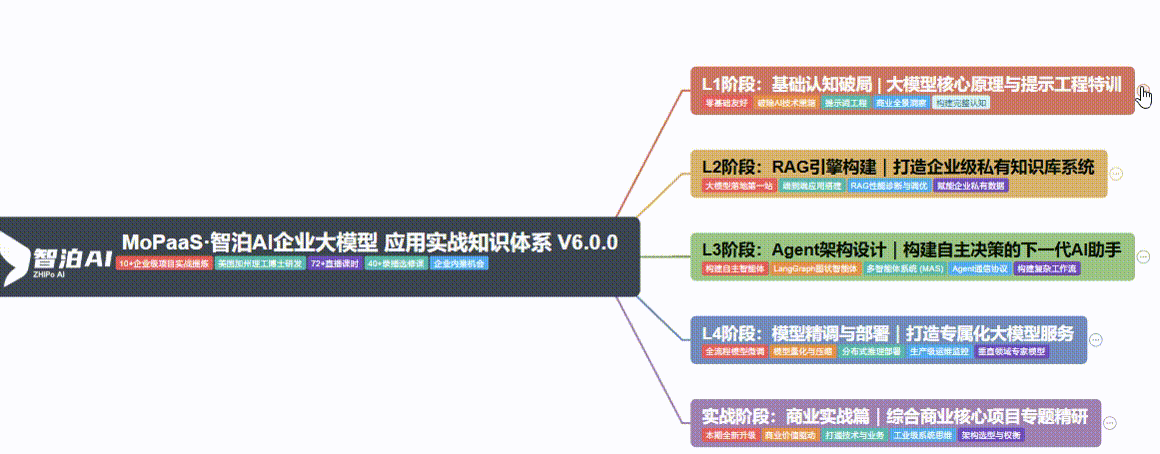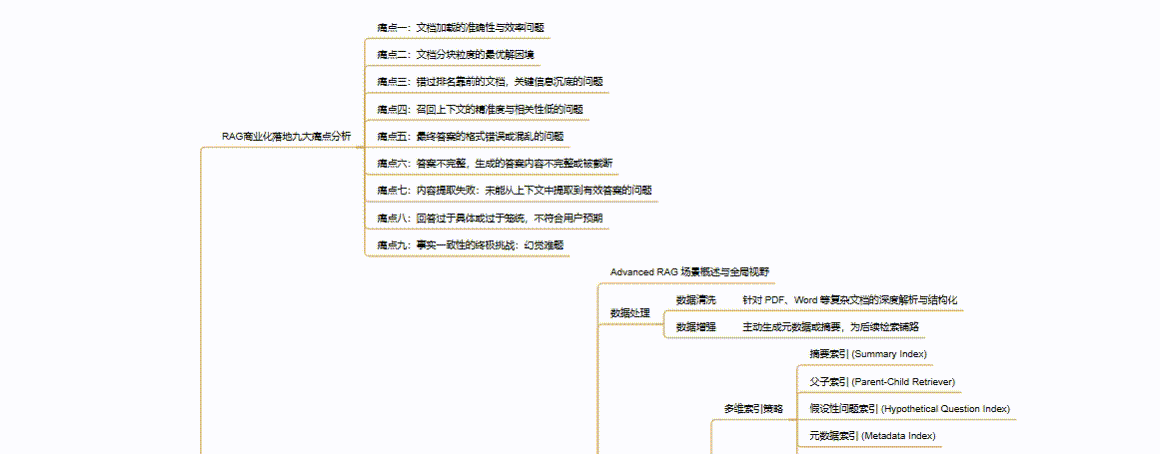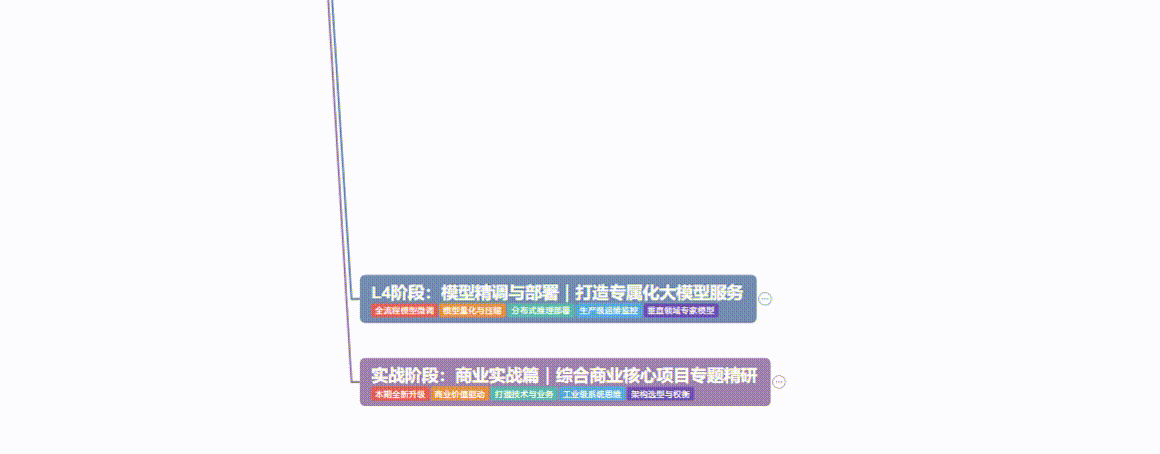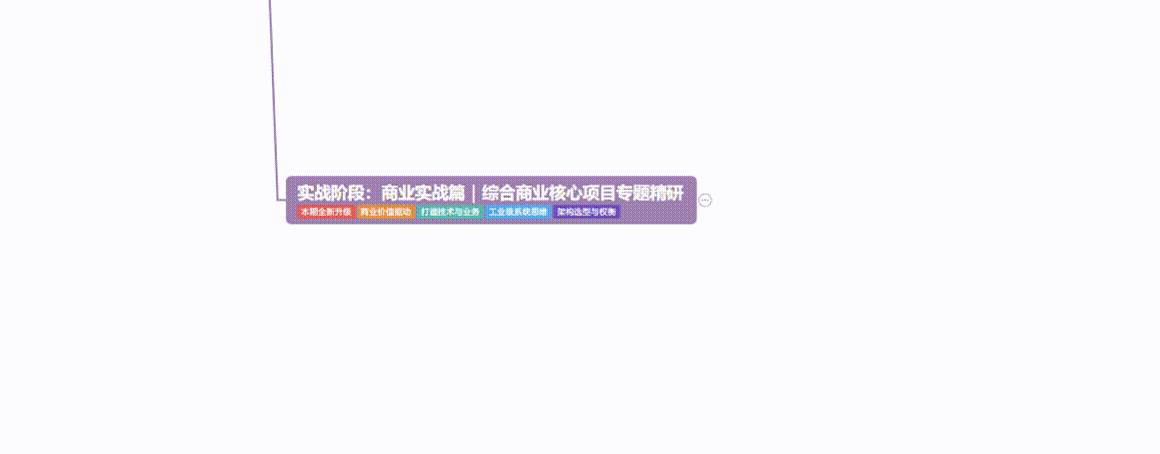
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
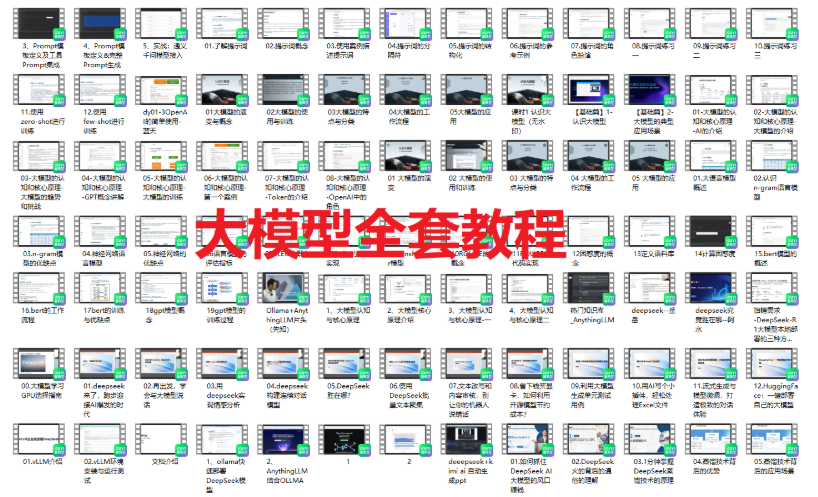
2、大模型学习视频教程
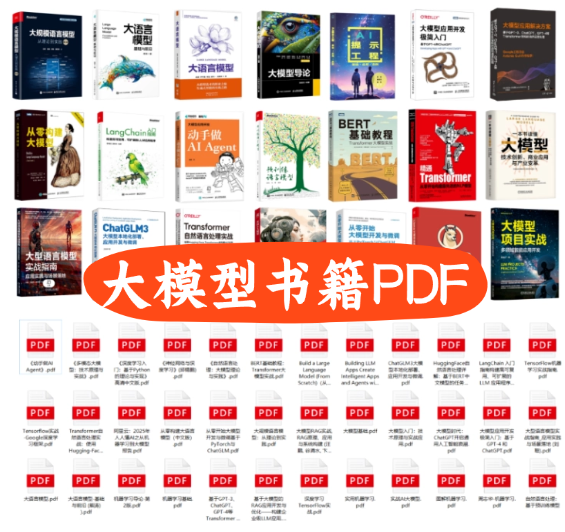
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
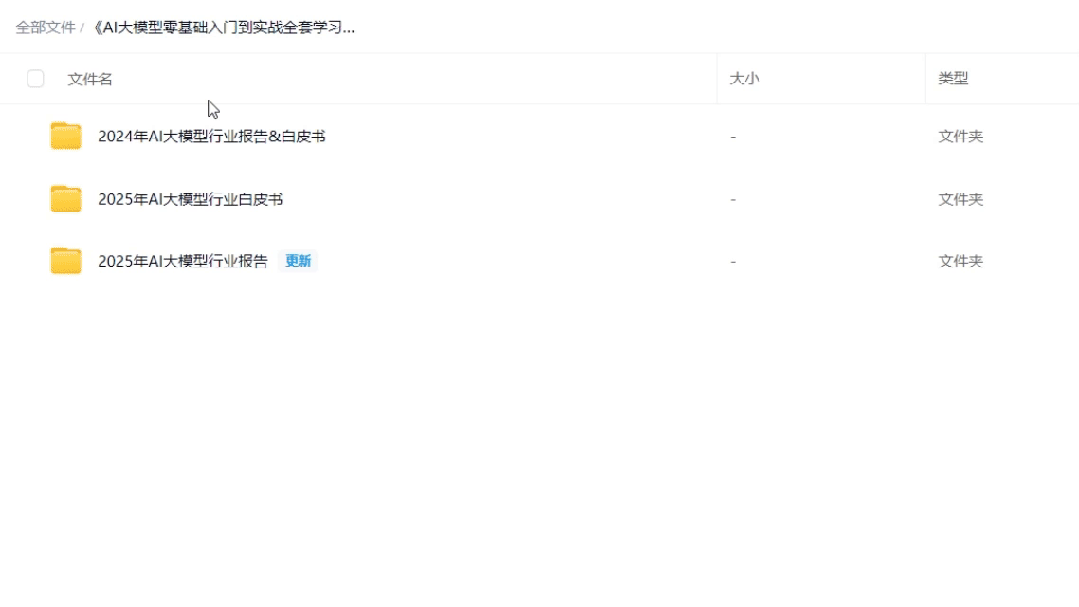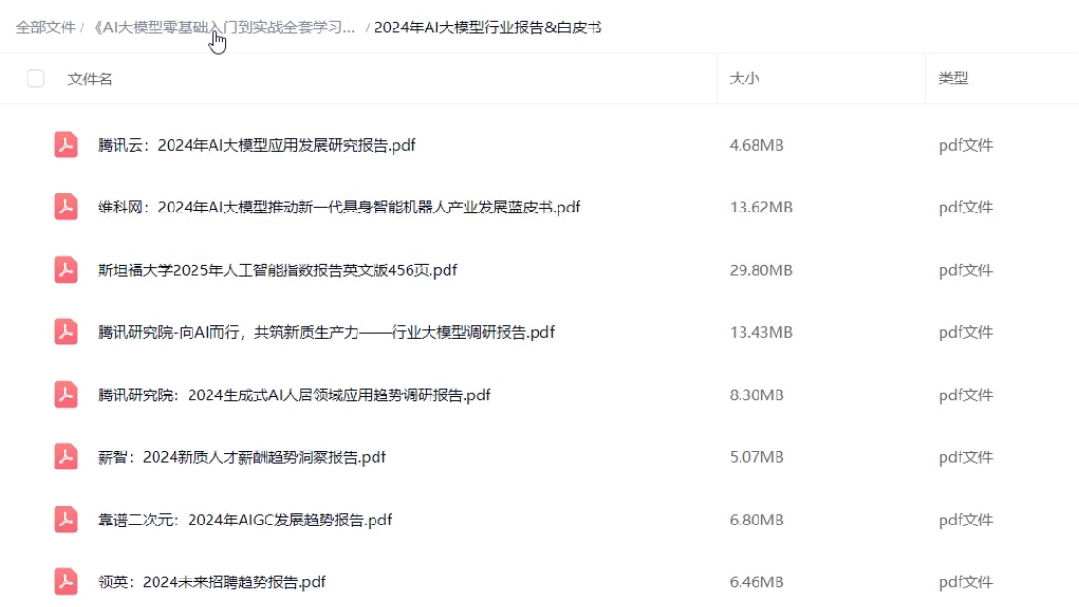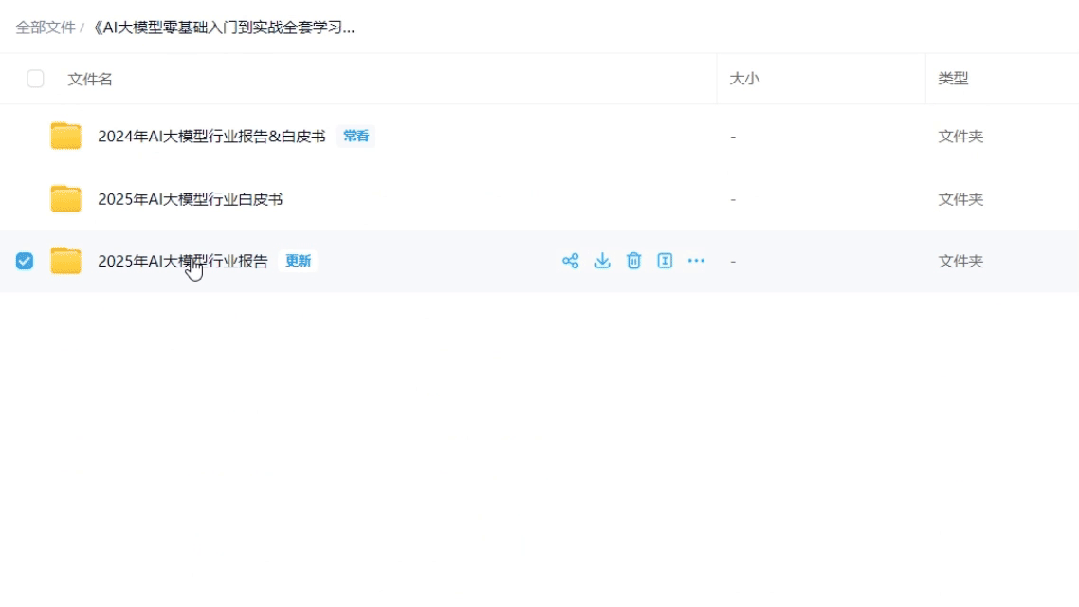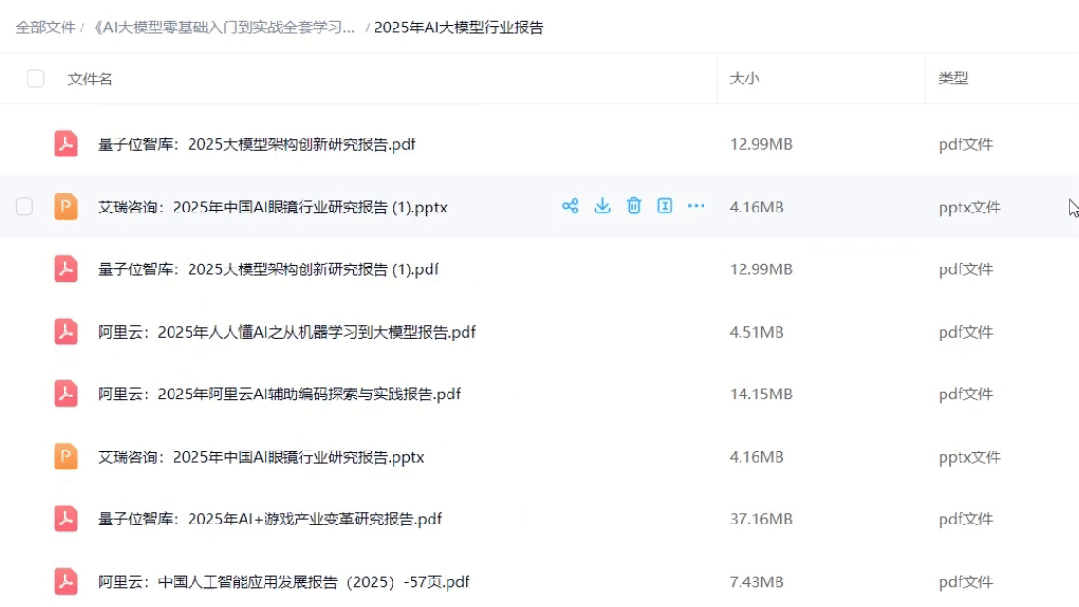
5、大模型项目实战&配套源码
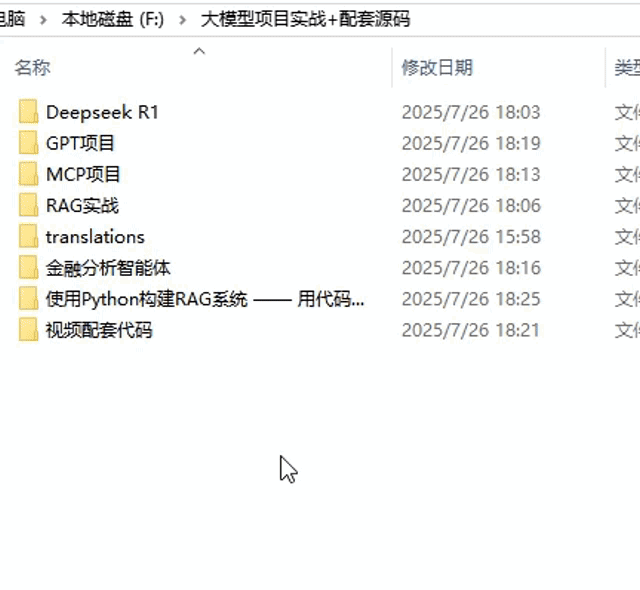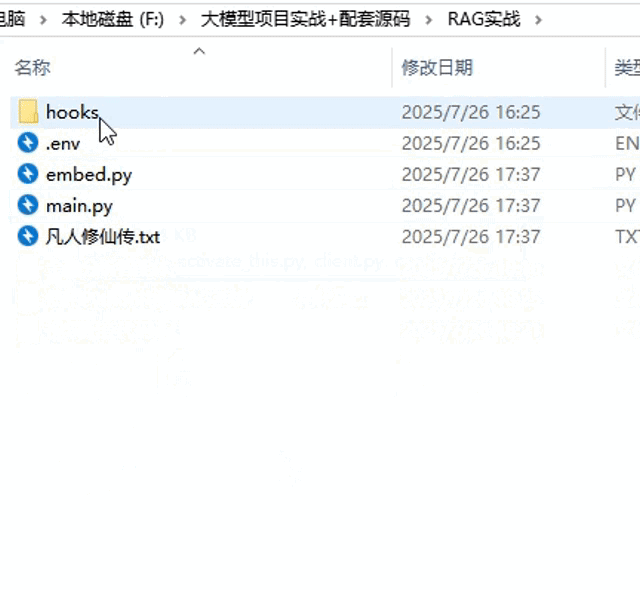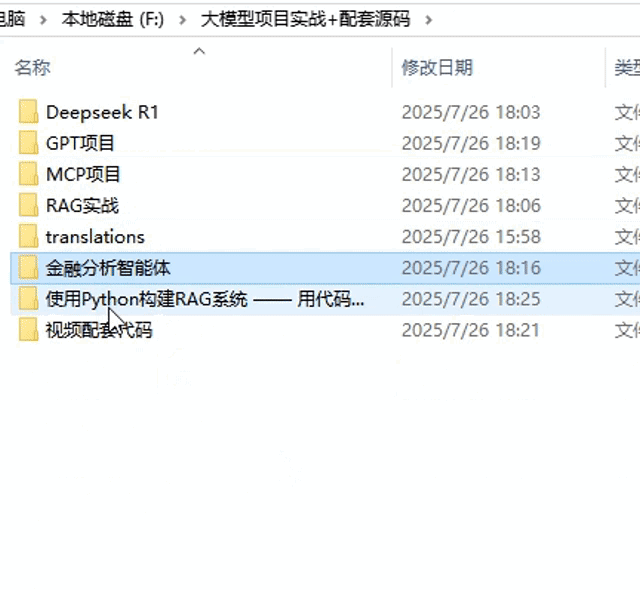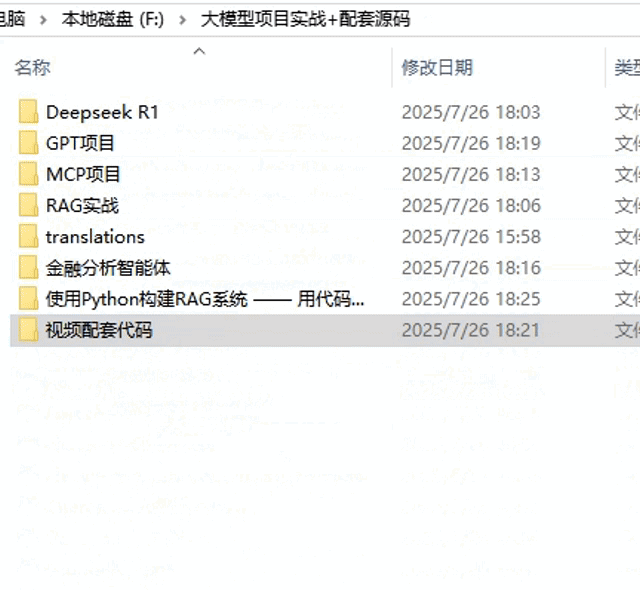
6、2026大模型大厂面试真题
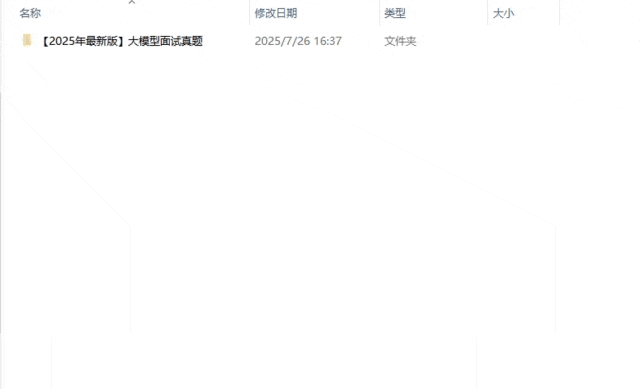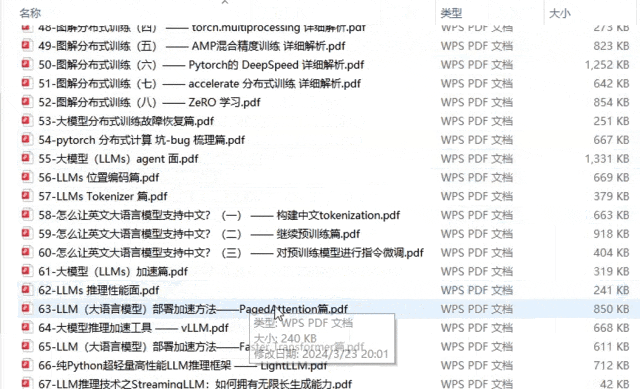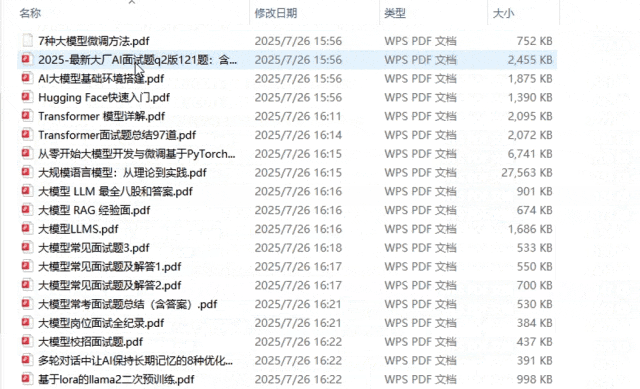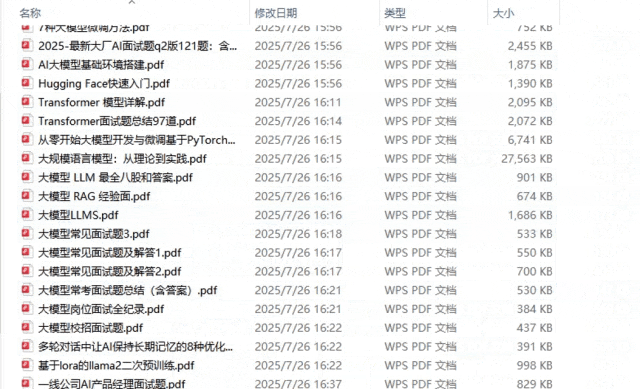
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
👇👇扫码免费领取全部内容👇👇

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)