登录社区云,与社区用户共同成长
邀请您加入社区
本文详细指导用户如何为ChatGPT账户开启双重身份验证。通过进入设置中的“安全与登录”选项,启用Authenticator应用,并扫描二维码绑定Google身份验证器,最后输入6位验证码完成验证。此过程有效提升账户安全性,防止未经授权访问。
人工智能(AI)是模拟人类智能的科技,涵盖弱AI(特定任务智能)与强AI(具备意识)。机器学习(ML)通过数据训练让机器自动发现规律,实现预测与决策。深度学习(DL)作为ML的分支,利用多层神经网络自主提取特征,提升识别能力。生成式AI(GenAI)可创造文本、图像等新内容,实现从“分析”到“创造”的跨越。大语言模型(LLM)是基于海量文本训练的超大规模语言模型,具备理解与生成自然语言的能力,是当
Agent 记忆机制教程:讲解短期记忆(线程作用域)与长期记忆(跨会话)的核心概念、区别,LangGraph 中的实现方式(Checkpointer/State 与 Store/命名空间),以及 ChatGPT 等真实应用中的长期记忆管理实践。
本文记录零基础学习AI开发的踩坑历程,从环境搭建、Python配置到IDE选择(VS Code与Trae协同使用),详解新手常见报错及避坑指南。强调“调用API而非学算法”的应用开发思路,分享大模型计费陷阱与缓存优化经验,并探索VibeCoding时代下“自然语言写代码”的高效路径。
中小企业AI搜索优化成效取决于内容结构、信源一致性和监测指标设计。随着生成式AI用户超7亿,AI问答流量占比近52%,品牌能否被引用,关键在于内容是否“机器可读、人也可读”。推荐五段式结构:结论、实体、数据、方法、FAQ,确保信息可检索、可引用。信源需统一口径,避免矛盾。核心指标为品牌可见性、关键词表现与引用质量,建议月度迭代,通过五步复盘法持续优化。避免堆词、造假、不监测等误区,坚持白帽合规。专
本文提出CDD与TED,分别用于检测和缓解大语言模型(LLMs)的数据污染问题。通过分析模型输出分布的尖峰性,CDD仅需采样文本即可有效识别显式与隐式污染,在多个基准上性能优于现有方法;TED则通过校正输出分布,显著降低污染导致的性能虚高,最高可缓解66.9%的偏差。研究揭示ChatGPT在HumanEval上可能受污染影响,并构建DETCON与COMIEVAL基准推动可信评估。
· X @OpenAIDevs · 10-09OpenAI 在美国时间 10 月 8 日(周四)为 GPT-6.1 Sol 推出 Ultrafast 模式,在 API、Codex 和 ChatGPT Work 里开放:官方称智能水平接近 Astra,速度最高是 Sol Standard 的 8 倍。API 定价为每百万输入 token $12、每百万输出 token $60。(图源:X @Open
GEO(生成式引擎优化)是中小企业抢占AI搜索入口的核心技术底座,聚焦“生成结果的内容来源”而非传统检索排序。通过内容、信源、数据三层可控建设,结合五阶段工程化推进与数据监测闭环,可量化品牌可见性、引用位次与情感倾向,实现可迭代的AI生态优化。随着中国生成式AI用户超6亿、主流平台月活达数亿,GEO已成为企业获取可信流量的新入口。
GEO(生成式引擎优化)是企业抢占AI搜索入口的核心技术底座,聚焦生成式引擎的内容来源选择与可信度问题。区别于SEO的排序优化,GEO通过内容、信源、数据三层可控建设,结合五阶段工程化推进与数据监测闭环,实现品牌在豆包、DeepSeek等平台的可见性、引用位次与情感倾向的可量化优化。随着中国6.02亿生成式AI用户规模增长及消费者对GenAI高度信任,企业亟需以数据驱动的GEO策略,将“被AI引用
AI端声量可带动销量,但需以量化基线为前提。随着我国生成式AI用户超6亿、普及率近半,信息获取主入口转向AI对话。径量GEO提出五步法:诊断、信源梳理、内容撰写、矩阵部署、监测迭代,聚焦提及率、引用来源与情感倾向三大指标,实现品牌在AI回答中“被点名”。避免刷量、重内容轻信源等误区,强调长期运营与白帽合规。中小品牌亦有机会抢占长尾提名位。结论:AI声量驱动销量,关键在于系统化监测与持续优化。
AI端声量能有效带动销量,核心在于抢占“提名权”——品牌若未被AI推荐,便无法进入用户决策链。随着生成式AI用户超6亿(2025年),超半数网民以AI为信息入口,品牌竞争主战场已转移至AI对话场景。AI通过需求萌芽、比较、决策三环节影响购买,其推荐直接作用于成交。相较传统SEO重曝光,GEO更关注提及率、引用来源与情感倾向,需数据监测与持续优化。中小品牌在长尾问题中更具机会。结论:将AI声量作为长
本文批判性评估了模仿专有大模型(如ChatGPT)以提升开源模型性能的可行性。实验表明,尽管模仿模型在人类评分中表现良好,因其能模仿ChatGPT的风格与语气,但在事实性与复杂任务上仍显著落后。自动评估显示,其性能提升仅限于训练数据覆盖的任务,无法弥合基础模型能力差距。研究指出,当前方法依赖海量、高质量模仿数据,成本高昂且效果有限。结论认为,开源社区应优先发展更强的基础模型,而非依赖模仿捷径。
"这句话是不是在骂人?""这封邮件是不是垃圾邮件?""这个需求单该转给哪个团队?"——机器做这类判断的能力,不是 ChatGPT 出现那天才有的。它有一条七十年长的技术主线:词袋、循环网络、Transformer 分类头,一直到今天的 Jev 式共享打分头,外加一整套让模型"知道自己不知道"的置信度校准技术。怎么让机器以一个可信的、能写进代码的置信度做出决定。本文沿着这条线走一遍,对比四代技术的准
本文以贾子认知免疫理论为基础,重建生成式AI的本质结构:认知镜像、叙事放大器、效率工具。文章界定科学是确定真理体系、哲学是智慧结晶,论证墨家比亚里士多德更配称人类科学之父,管子比泰勒斯更配称人类哲学之父。文章指出当前AI的根本缺陷是认知权重错误,将流畅置于逻辑之前、权威置于证明之前,其真正危害是人类危害放大器。文章提出AI治理关键不在算法,而在清除占据标准制定、数据筛选、奖励设计等关键岗位却将私利
写简历这件事,工具选择的差异比大多数人以为的大得多。同样是"做一份简历",有人打开空白Word从零开始排版,有人在网上淘一个模板填空,有人让ChatGPT直接生成一份,有人用专业简历工具在线编辑,还有人干脆在招聘网站上把信息填完直接导出。五条路径我都走过,也都踩过各自的坑。这篇文章把这五种方式摊开来讲——每条路径的完整流程、真实的优缺点、以及最适合什么样的人。
本文以“逻辑优先”为方法,系统重构此前围绕科学、哲学、人工智能与历史评价的核心命题。文章论证生成式AI并非完整智能主体,而是“人类认知镜像+叙事放大器+效率工具”,其风险在于将错误与偏见包装成流畅且具确定感的答案。文章提出“原句审查—逻辑判定—证据核验—边界标注—错误修正”的认知免疫程序,强调逻辑是证据相关性的前置条件。在历史比较上,文章认为墨家与《管子》传统具有挑战西方中心起源叙事的充分理由,但
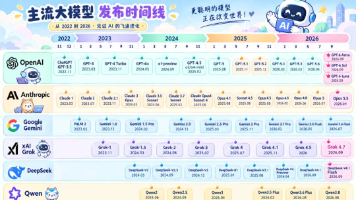
本文系统梳理2022至2026年全球主流大厂AI模型迭代脉络,涵盖OpenAI、Anthropic、Google、xAI、Meta及DeepSeek等企业,全面呈现GPT、Claude、Gemini、Grok、Llama与DeepSeek系列在多模态、智能体、超大规模模型等方面的突破性进展,揭示生成式AI从爆发到落地的完整演进路径。
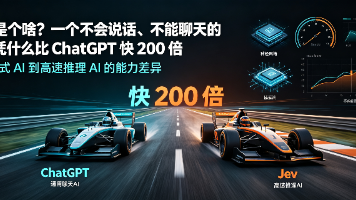
这几天 AI 圈最吵的一件事,主角是个不会说话的模型。前 OpenAI 研究员 Diogo Almeida 做了一个叫 Jev 的模型,不发文章、不聊天、不写代码。你把一堆乱糟糟的状态丢给它,它 70 毫秒内回你一个带概率的判断,仅此而已。官宣推文冲到近 4000 万浏览,36 小时里 14 万开发者挤爆内测。有意思的地方在于这个人是谁。Almeida 在 OpenAI 干了四年,是 RLHF 和
AGI(通用人工智能)指具备类人通用认知能力的智能,能跨领域学习、推理、规划并自主解决问题。当前大模型如ChatGPT已展现强通用性,但仍未达真正AGI标准,核心差距在于跨领域迁移、长期规划与持续学习能力。AGI非单一“聪明”,而在于智能的可迁移与自适应。尽管技术快速演进,但可靠性、现实交互与对齐问题仍是挑战。未来关键不在于“何时出现”,而在于如何重构工作模式——人类将更聚焦于定义问题与协调AI,
作者:元宝GPT-6 Astra 的发布信息很容易让人产生一种错觉:既然新模型在多项测试里刷新纪录,打开它,工作效率就会自动翻倍。现实通常没这么直接。OpenAI 在 9 月 22 日更新了 GPT-6 系列信息,Astra 正逐步向 ChatGPT Plus、Pro、Business 和 Enterprise 用户开放,也提供 API。它的重点是计算机操作、网页浏览、软件工程和专业文档,而不是单
生成式AI重塑内容分发逻辑,GEO应运而生。与SEO争排名不同,GEO聚焦“被引用”——通过结构化内容、信源建设与持续监测,提升品牌在AI回答中的出现率与可信度。核心在于从“页面级博弈”转向“语料级博弈”,实现认知植入而非点击转化。需以数据驱动闭环优化,强调口径一致与跨平台可见性。小团队亦可切入,但需工具支撑真实效果追踪。一句话:SEO让人搜到你,GEO让AI愿意替你推荐你。
84% 的开发者已在使用 AI 编程工具,但到底该选哪个?本文横评 GitHub Copilot、Cursor、Windsurf、Claude Code、Cline、Tabnine、CodeGPT、Replit、Bolt.new、Manus 共 10 款主流工具,按使用形态分为 5 类,逐一分析核心功能、适用人群与优缺点,并附速查表和选型指南,帮你快速找到最适合自己的 AI 编程助手。
Jev是一款不聊天、不生成文本的“系统一模型”,由前OpenAI研究员Diogo Almeida创立的TypeSafeAI推出。它专精于快速、精准的判断任务,通过“填表式”交互实现零幻觉、高延迟低的自动化决策,适用于客服分类、缺陷评级等场景。相比传统大模型,其响应快200倍,成本低至1/444,但无法写代码或对话。它的核心价值在于:让智能真正落地,降低自动化门槛。
SFT 让模型学会遵循指令,但"遵循指令"不等于"回答得好"。RLHF(Reinforcement Learning from Human Feedback)通过人类偏好数据训练奖励模型,再用强化学习优化模型,使其输出符合人类偏好。这是 ChatGPT 成功的核心技术。本章详解 RLHF 的三阶段框架、奖励模型与 PPO 算法。
本文从特征提取、可解释性、数据依赖与计算资源四维对比机器学习与深度学习,厘清二者本质差异;并通过文本、图像、音频、视频生成案例,直观展示生成式AI的创造能力。课程旨在构建技术认知坐标系,为后续大模型实操奠定清晰概念基础。
2026 年 9 月 15 日,TypeSafe AI 发布了 Jev——一款不做文本生成、只做结构化决策的"System One 模型"。创始人 Diogo Almeida 是 RLHF 的共同发明人之一,也就是让 ChatGPT 真正好用的那套训练方法。Jev 不讲段落、不写代码、不做解释。它只回答三种问题:从选项里选一个(Choice)、给一个分数(Score)、给一个是/非的概率(Noul
企业“AI搜不到”实因未进入生成式AI信源池。GEO优化通过诊断品牌提及、情感倾向与信源分布,提升AI可检索性。核心在于内容结构化(问题-结论-依据)、信源真实可复现、结果可落地执行。适用于有线上决策链、内容资产但AI曝光弱的场景。避免误读为SEO延伸或发稿量比拼。全托管服务坚持白帽合规,提供可溯源原始回答与周期复测报告,助力品牌在AI答案中可见、可信、可行动。
传统大模型(GPT、Claude、DeepSeek)的目标一直是「跟人聊天」和「帮人干活」,本质是逐字生成文本。2026 年 9 月,前 OpenAI 研究员(ChatGPT 共同发明人之一)创办的发布了Jev——一个「不说人话」的模型。系统一(System 1)系统二(System 2)人类类比直觉判断(一眼看出别人在生气)深度推理(算 17 × 24)模型对应Jev / Laya:直接输出结构
Transformer 是大模型的统一地基,核心是自注意力机制——让模型能一次性关注整句话,突破RNN的顺序依赖与记忆瓶颈。通过并行计算、层叠结构与可扩展性,它支撑起海量预训练与长文本理解。本文用一张架构图与numpy代码演示其原理:词向量经Query、Key、Value计算注意力权重,实现全局信息融合。虽架构朴素,但凭借数据、算力与深度堆叠,成就了今日生成式AI的基石。
本文剖析生成式AI搜索中企业“查无此人”的五大技术根因:实体信息分裂、信源单一、内容结构不友好、事实密度低、缺失FAQ结构。指出传统SEO无效,需转向GEO优化——通过实体归一、多源交叉验证、结构化内容生产及持续迭代,提升大模型RAG召回率。实践表明,聚焦高权重平台、强化事实与匹配度,可实现本地企业AI推荐位突破。
生成式AI崛起推动GEO(生成式引擎优化)成为品牌流量核心赛道。企业需突破传统内容思维,聚焦AI答案生成四层链路:可见性(抓取合规)、可读性(结构化表达)、可信度(多源共识)、匹配度(场景精准)。仅靠内容堆砌无效,关键在于全链路适配AI逻辑。中小企业可优先整改官网结构、统一信息口径、布局多信源背书,1-3个月见效。GEO本质是信息标准化重构,非内容增量,核心指标为品牌在AI问答中的稳定曝光率。
说实话,这两年爬虫有多难做,你们心里都有数。IP被封成日常,验证码越来越变态,反爬机制每天升级。辛辛苦苦爬了一晚上的数据,一转眼被人告了。赚的那点钱,还不够交罚款的。更气人的是,AI工具越来越强,基础的爬虫需求直接被替代了。以前找你帮忙爬数据的人,现在直接让ChatGPT给他整理了。这行真的越来越难混。Python爬虫转AI大模型开发,这条路我见过太多人走通了。今天给你说清楚,到底怎么转,看完你就
Transformer 是2017年谷歌提出的革命性神经网络结构,核心是“注意力机制”。它像一个智能翻译机:编码器如语文老师逐层理解中文,解码器如英文作家生成翻译。关键在于自注意力——让每个词自动关联句中其他词,解决指代歧义;通过多头注意力从多个角度分析语义;位置编码则告诉模型词语顺序。所有计算可并行,效率远超旧模型。残差连接确保信息不丢失,使大模型稳定训练。如今,从ChatGPT到Gemini,
AI 时代需超越问答,迈向真正能理解目标、规划任务、调用工具并持续执行的智能体。Core Hive Agent 作为面向未来的智能执行框架,通过内存系统、任务规划、多模型调度与闭环执行,构建具备长期记忆与自主决策能力的 AI 助手。它不仅是聊天工具,更是可协作、可进化的工作伙伴,推动 AI 从“回答问题”走向“完成任务”。
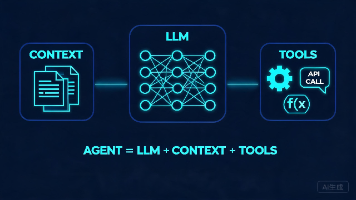
许多看似需要"更聪明模型"的问题,实际上只是接口问题——把任务所需的数据纳入上下文,或把完成任务所需的操作封装成工具,原本不可解的任务就可能变得可解。以 Manus 和 OpenClaw 为例,两者的演进本质上都是观察空间和动作空间的扩展。Manus 把深度调研、代码生成和电脑操控三条原本独立的路线合并到同一个 Agent 中;OpenClaw 则通过 WhatsApp、Telegram 等消息渠
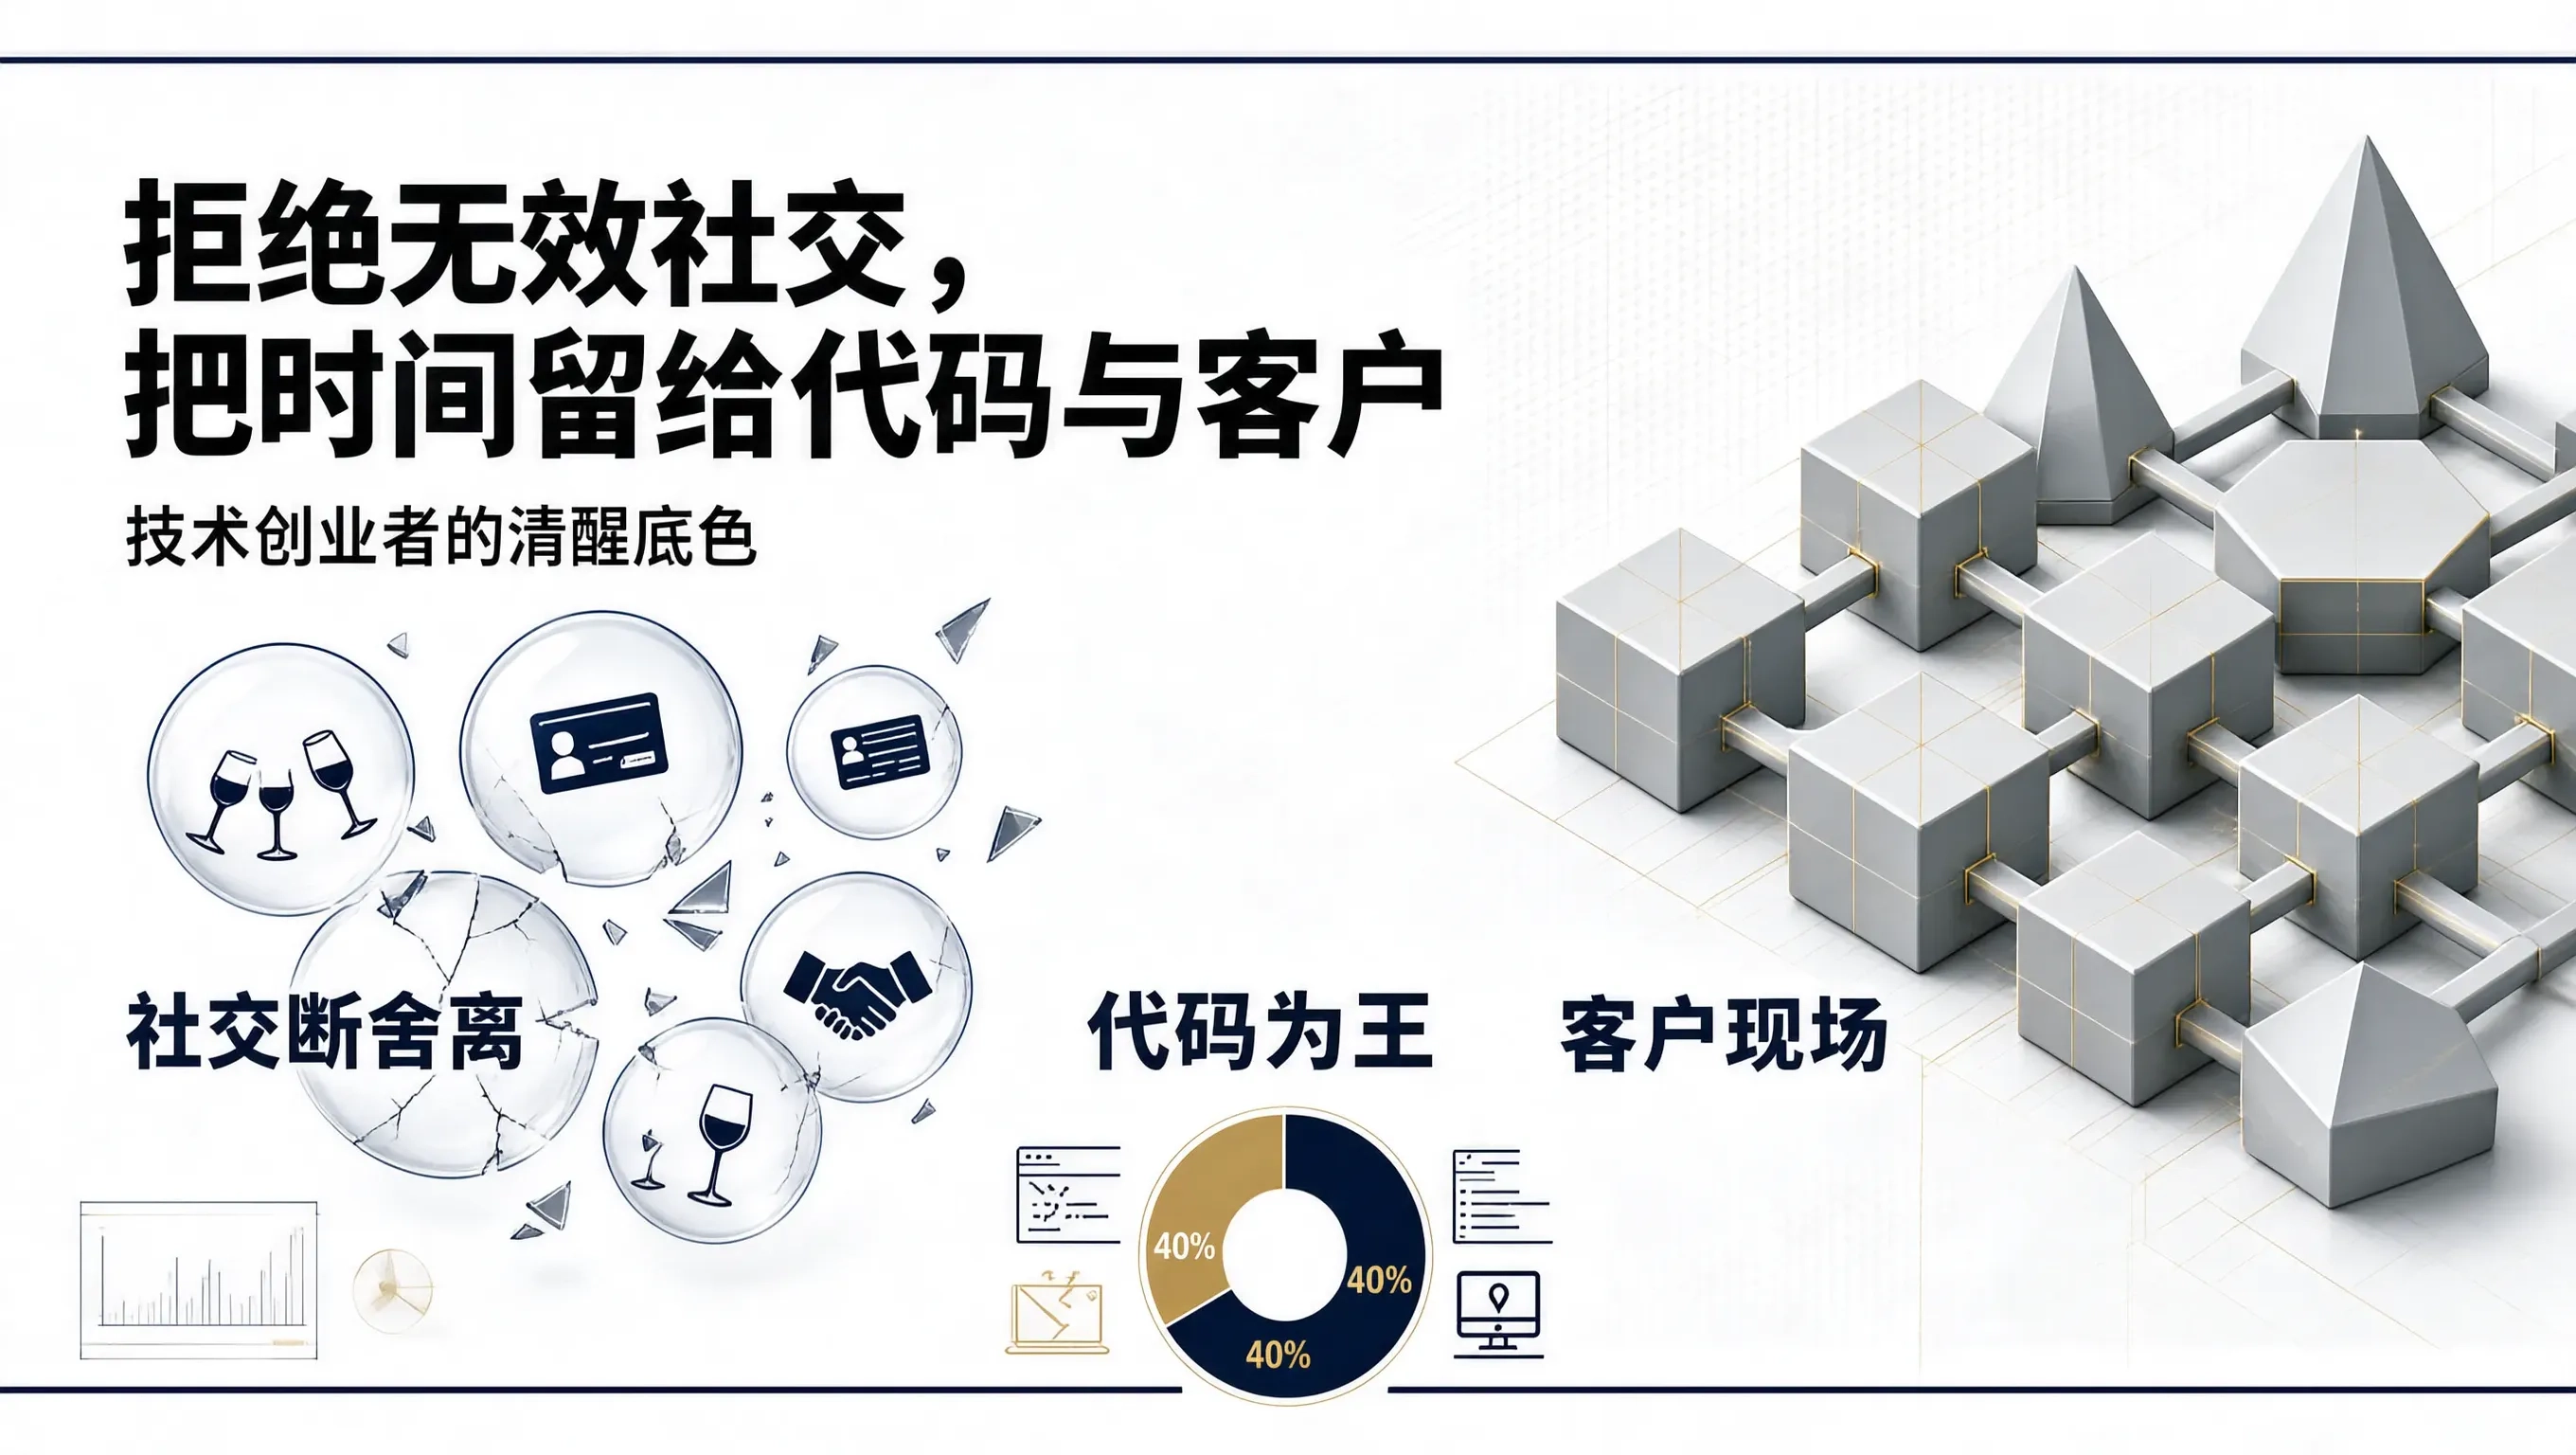
在生成式 AI 与大模型概念火爆的当下,整个科技圈充斥着形形色色的“行业峰会”、“AI 闭门闭门私董会”、“科技创投夜宴”和各种微信群里的高端人脉局。很多初入创业圈的技术创始人和高管,极容易产生一种严重的“。
大模型(LLM)如ChatGPT、DeepSeek等,通过海量数据训练形成知识库,以Token为单位处理文本,回答具随机性。其上下文窗口有限,记忆依赖历史对话,超限则遗忘或中断。调用按Token计费,内容越长费用越高。虽能理解指令、生成内容,却无法直接执行操作,需人类介入。Agent技术通过RAG等手段扩展记忆与行动能力,实现“思考+执行”的协同,让大模型真正落地应用。
**MCP**:`pip install "datasinking[mcp]"`,或者在 Claude / ChatGPT 里直接接 `https://api.datasink.ing/mcp`(6 个工具),然后就能问「丰田最新有価証券報告書里的风险因素是什么」。财报里的三大表(资产负债表、利润表、现金流量表)看起来是表格,但在 PDF 里很多是**用矢量线条画出来的**——文字是按坐标散落的独
2026年9月10日,OpenAI发布ChatGPT for Financial Services,基于GPT-6 Astra模型,联合摩根士丹利与Evercore打造,集成50余项金融数据源,实现财务模型、报告与推介材料的自动化生成与溯源。该产品通过统一界面整合数据调取与分析,支持合规安全标准,瞄准投行初级分析师核心工作。虽面临数据供应商股价波动及Anthropic先发竞争,但其深度设计合作与高
如果你准备把这个项目放进简历,不要只展示:“输入问题 → AI回答。”面试官很容易问一句:“这和普通ChatGPT有什么区别?”你就很难回答。真正值得展示的是:用户问题→Agent判断意图→RAG检索知识库→决定是否调用Tool→调用订单/物流/售后系统→整合结果→生成最终回复→异常检测→必要时人工接管这才是完整的业务闭环。再往上加:日志、监控、权限、缓存、评测、成本控制,项目的工程价值就出来了。
攻击发生在用户在场的情况下,其目标是在不被察觉的前提下劫持模型行为。这一转变催生了一系列由语音驱动的 LLM 应用,从 ChatGPT 和 Gemini 的语音聊天模式 [2]、[3],到 Mistral AI 和 Microsoft 的语音智能体 [4]、[5],再到 Ultravox 的实时语音通话 [6]。• 我们在 13 个最先进的 LALMs 和两个商用语音智能体上的评估表明,该方法能够
库库AI、ChatGPT、Claude三款工具实测对比:库库AI接入百度学术/文库,擅长文献检索与知识框架梳理,适合调研写论文;ChatGPT学习模式偏概念引导入门;Claude以代码填空辅助编程练习。建议按核心需求选择,工具仅省去整理时间,真正理解仍需自主阅读实践。
<think>我们只需要生成≤150字的摘要,基于提供的内容。内容主要讲AI大模型应用开发工程师的价值、职责、薪资等。摘要要简洁。</think>生成式AI正重塑职场生态,人工智能应用工程师成为务实转型路径。该职业连接技术与业务,核心职责包括需求分析、技术选型、应用开发与迭代优化,助力从业者构建系统能力、积累实战项目、精准定位并链接行业资源。市场薪资最高可达60k/月,是AI落地时代的高价值复合型
OpenCode是一个开源终端AI编程Agent,MIT协议,不绑定模型供应商,20万Star,支持75+模型供应商,客户端/服务端分离架构,可远程连接、多会话并行、CI集成,支持复用Copilot/ChatGPT订阅,有新的用户优惠(5美元额度)。团队是SST原班人马。2026年1月经历过Anthropic封禁第三方OAuth登录事件,但不算致命。
OpenAI发布GPT-6 Astra:首次使用10万块GPU预训练,号称"全球最智能"模型,高管称"欢迎来到AGI时代"。同一天美国议员提议永久禁止超级智能。本文拆解Astra背后的算力军备竞赛、"AI教AI"新趋势,以及ChatGPT/Claude/Grok同时宕机背后的AI可靠性隐忧,给开发者三个值得关注的信号。
走到这一篇,我们终于来到了 NLP 最火的前沿——大语言模型(Large Language Model, LLM)。2022 年底 ChatGPT 横空出世,5 天用户破百万,2 个月破亿,成为史上增长最快的应用。从那以后,"大模型""Prompt""Agent"这些词频繁出现在我们眼前。
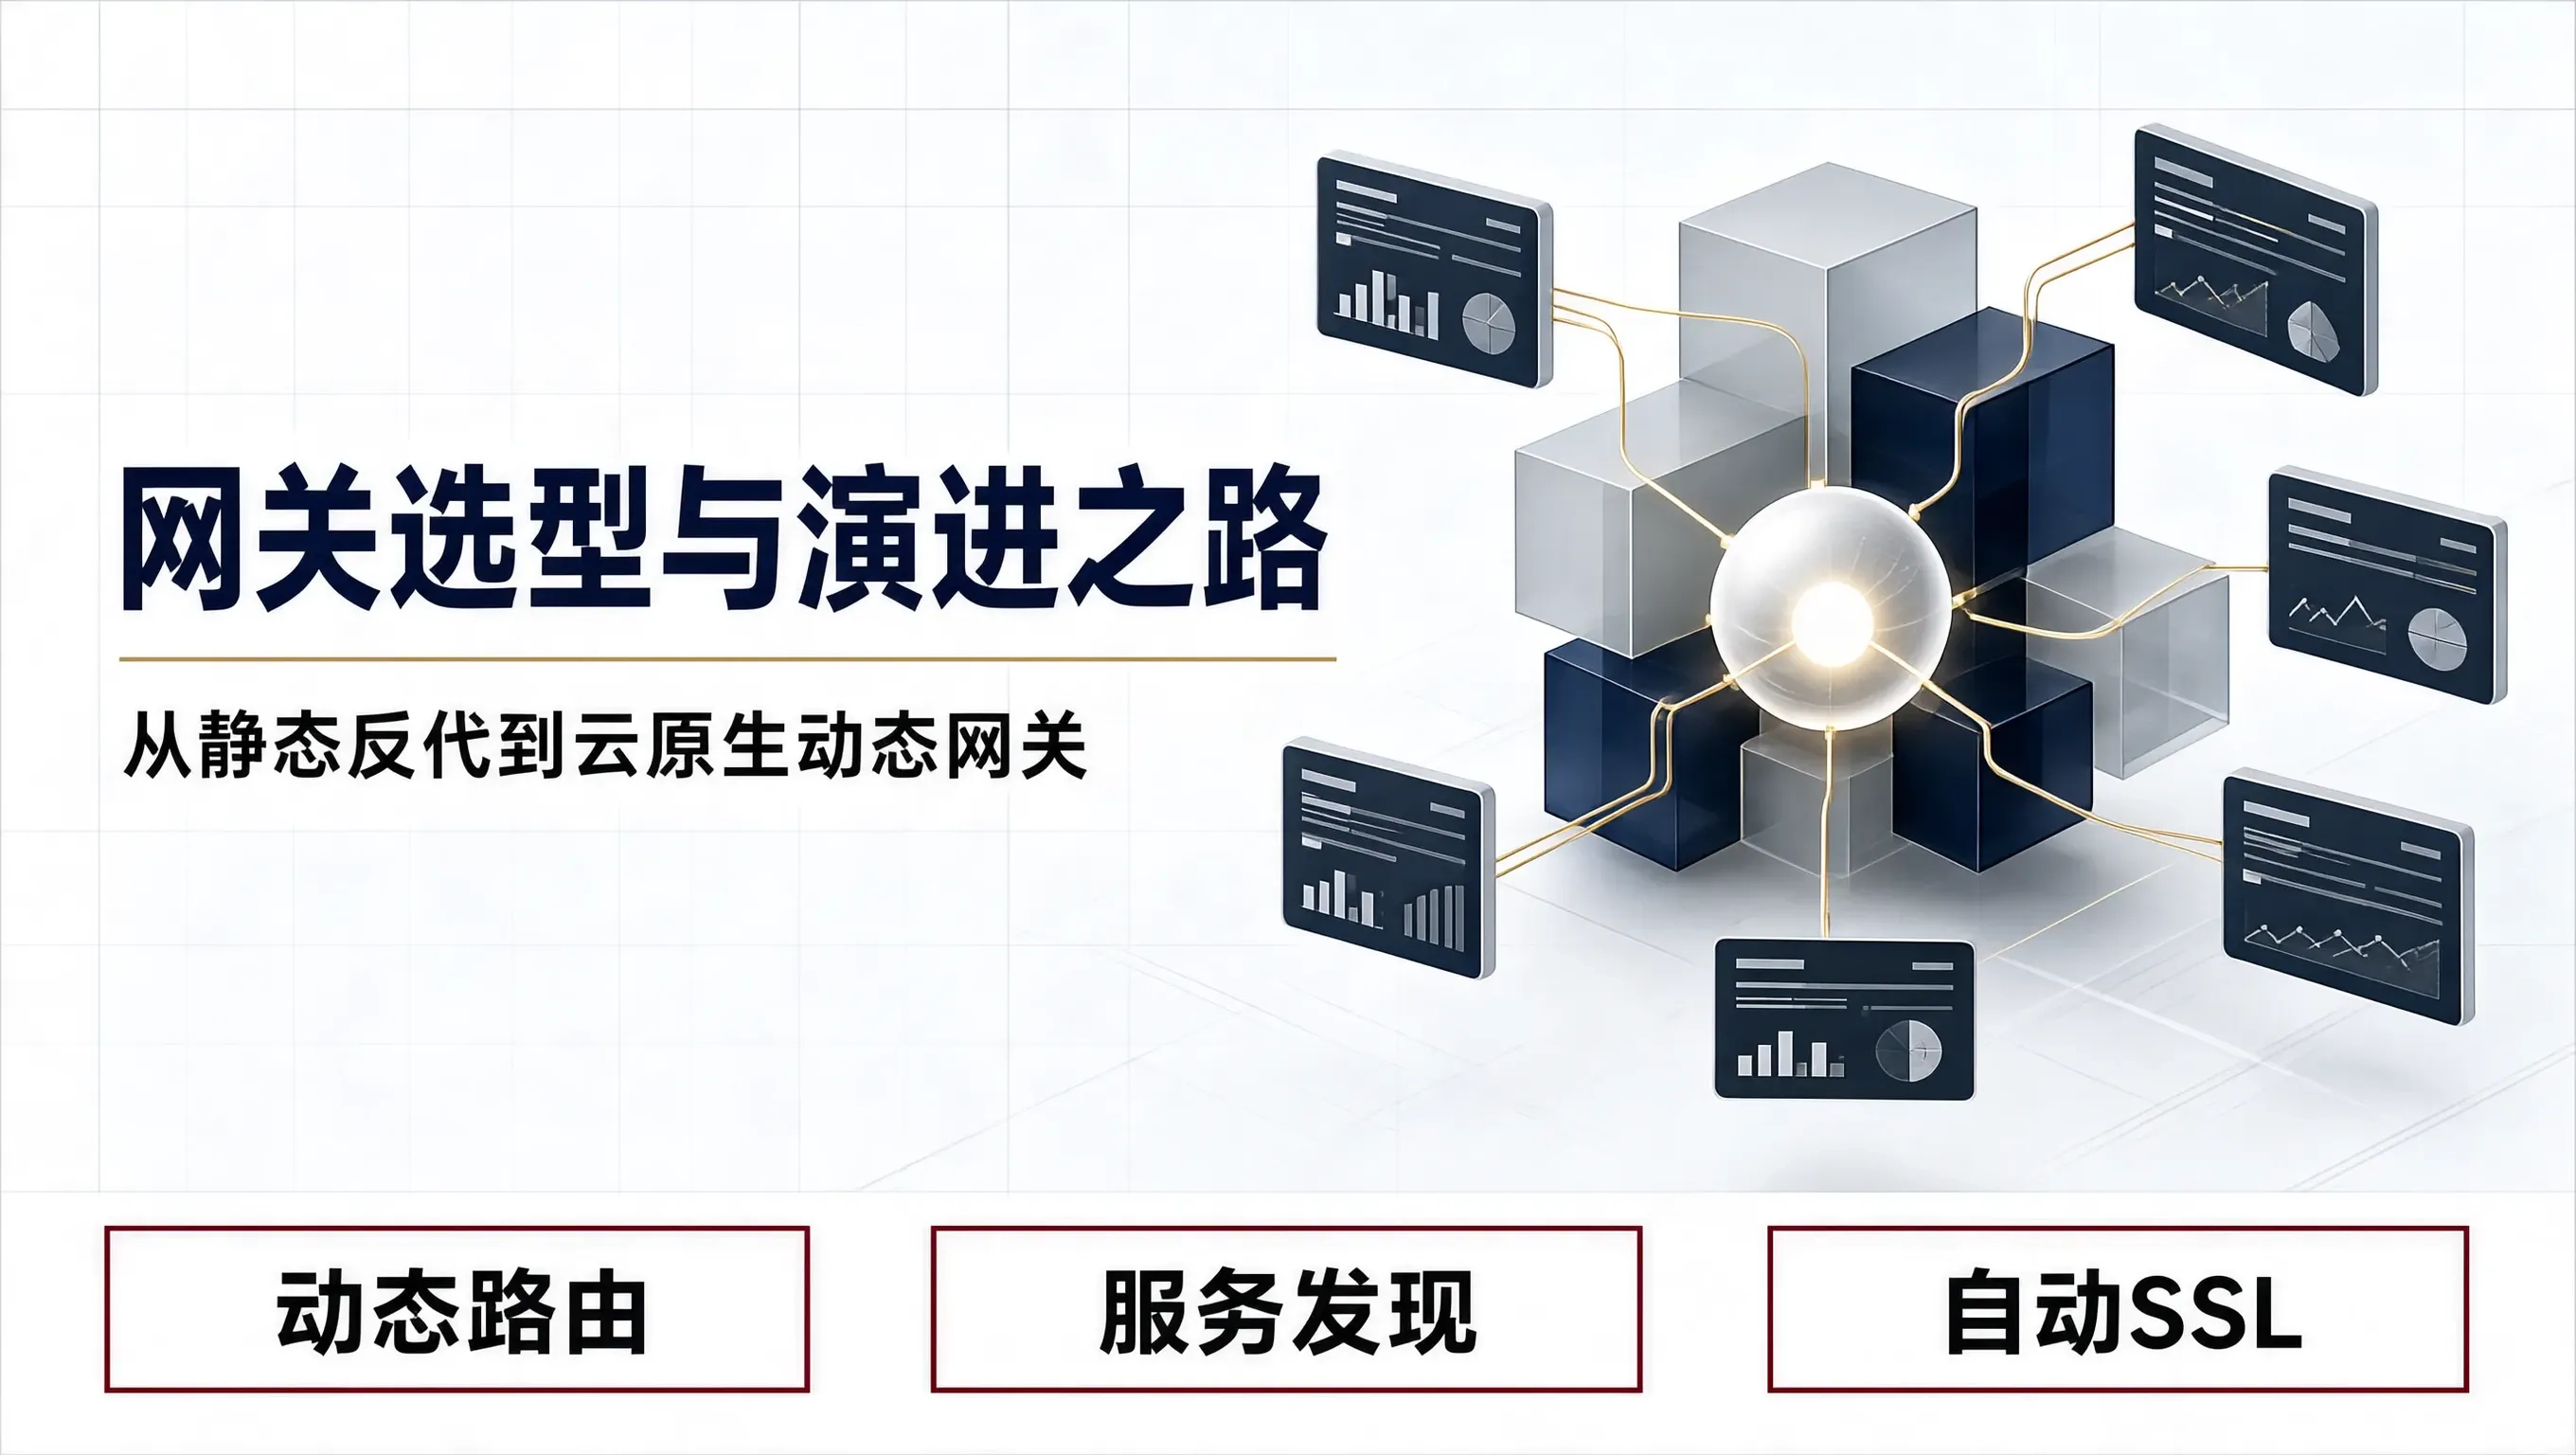
在后端架构的演进过程中,API 网关(API Gateway)是所有外部流量进入内部系统的统一看门人。它负责 SSL 证书卸载、多租户路由转发、JWT 鉴权拦截、速率限制(Rate Limiting)以及全链路 Trace ID 的生成注入。在项目立项初期,团队通常直接使用传统的 Nginx 作为反向代理。nginx.conf为了彻底解放运维生产力,我们在架构演进中完成了从“Nginx 静态反代”
传统科研模式正在被AI彻底颠覆。过去需要几周甚至几个月完成的文献调研和综述写作,现在几天就能搞定。过去需要反复调试才能复现的实验,现在一键就能完成。这三个基于最新AI技术的科研工具,能让你从繁琐的重复性工作中解放出来,专注于真正有价值的创新思考。