
【大模型RAG生成式AI开发实战】《大模型RAG生成式AI开发实战》_187.[第19章 安全与合规] 审计日志:记录每次检索和生成操作
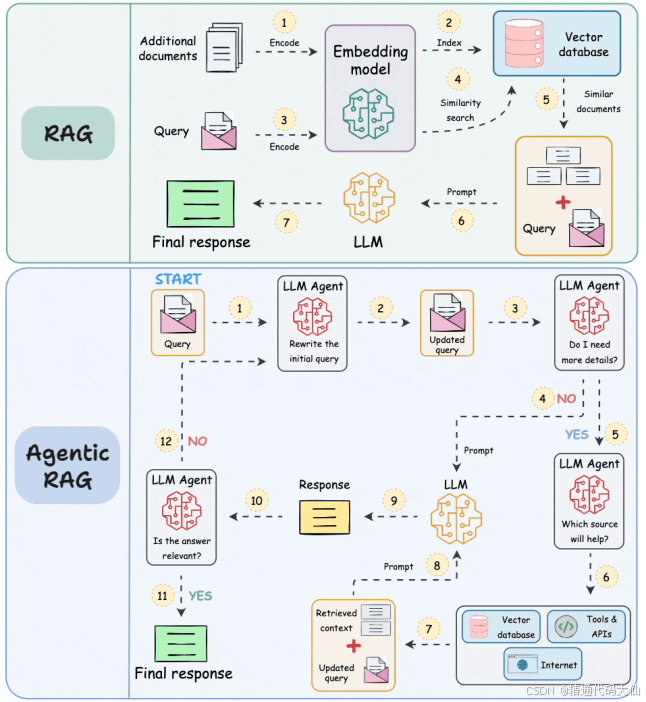
你的RAG系统上线三个月后被监管约谈,却拿不出一张完整的“口供”——审计日志不是可选项,而是大模型时代的行车记录仪与免死金牌。本文将带你从“裸奔式开发”的坑里爬出来,手把手搭建一套覆盖检索、生成、存储、合规全链路的RAG审计日志体系,让你的系统既能跑得飞快,也能在关键时刻自证清白。
文字目录:
- 为什么审计日志是生命线:合规、追溯与优化
- 检索阶段审计:记录问什么与查到什么
- 生成阶段审计:记录怎么答与用了什么
- 日志存储与结构设计:拒绝大JSON主义
- 合规查询与生命周期:让日志从负担变成资产
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《大模型RAG生成式AI开发实战》187.[第19章 安全与合规] 审计日志:记录每次检索和生成操作。
老话说得好,“出bug不可怕,可怕的是死无对证”。咱们程序员圈子里还有一句调侃:代码写得好,不如日志留得好;架构再牛X,出事没法追溯也白搭。在大模型RAG这个领域,这话简直金得不能再金了。模型本身是个黑盒,检索外面又包了一层黑盒,两个黑盒叠在一起,要是再没有审计日志,出了事你拿什么跟老板、跟用户、跟监管交代?
很多新手同学觉得,审计日志嘛,那是金融系统、政务系统才玩的“高端配置”,咱们先跑通业务,日志后面再补。我跟你说,这想法就跟“先上车后补票,结果遇上查票的”一样尴尬。等真出了事儿,比如模型突然生成了一段不该说的内容,或者用户投诉隐私泄露,你翻遍服务器发现日志里只有孤零零的“INFO: request received”,那画面太美我不敢看。
今天这篇文章,我就以学长的身份,跟你唠唠RAG审计日志到底怎么记、怎么存、怎么用。咱们分五个关键要点,一步步把这事整明白,争取让你读完之后,下午就能动手改造自己的项目。
1. 为什么审计日志是生命线:合规、追溯与优化
你是不是也觉得,先把RAG流程跑通,让模型能顺溜地回答问题,就是头等大事?至于什么审计日志、安全合规,那都是“大厂才需要操心的事儿”,等用户量上去了再说?
兄弟,这想法真要不得。
我见过太多团队,系统上线三个月,功能迭代了二十个版本,日志系统还停留在print()和console.log()的阶段。直到有一天,运营同事慌慌张张跑过来说:“有用户投诉,说咱们AI泄露了内部资料!”老板一拍桌子:“给我查!”开发同学打开日志文件,里面只有孤零零几行“INFO: request received”,“ERROR: timeout”。谁问的?问了什么?检索到了哪些文档?模型原话怎么说的?一概没有。
这就是典型的“裸奔式上线”。在传统Web应用里,日志可能只是为了查bug;但在大模型RAG系统里,审计日志是合规的底线,是定责的证据,更是优化系统的数据金矿。
新手最容易掉的坑,就是把审计日志当成“可选项”。觉得“我又不是金融系统,我只是个内部知识库助手”。错!只要你的系统接入了大模型,产生了内容,面向了用户,你就得对生成的每一个字负责。监管可不会因为你团队小就网开一面。而且,大模型的“幻觉”是天然存在的,RAG虽然能缓解,但绝不能根除。万一某个召回文档本身就有错误,导致模型输出了有害信息,没有日志,这锅你就得自己全背。
那正确的姿势是什么?从Day One开始,给每一次用户请求生成一个唯一的request_id。这个ID要像一根绳子,串起用户提问、检索召回、Prompt组装、模型生成、结果返回的每一个环节。最基础的审计日志至少要包含:时间戳、用户ID(或哈希)、操作类型(检索还是生成)、涉及的数据范围、模型版本、执行结果状态。
有了这根“绳子”,出问题时你才能说:“看,这是当时的完整链路,模型为什么这样回答,数据从哪来,一目了然。”而不是在会议室里满头大汗地猜。更长远看,这些日志还是你优化检索策略、调整Prompt的珍贵素材。比如你发现某个问题的检索阶段召回了一堆无关文档,导致了错误回答,没有日志,你根本发现不了这个因果关系。
所以记住,审计日志不是运维的专利,是RAG架构师的必修课。没有它,你的系统就是公路上没装行车记录仪的车——平时挺潇洒,一碰就全责。
小结:审计日志是RAG系统的行车记录仪,没装它,上路就是裸奔,出事就是全责。
2. 检索阶段审计:记录问什么与查到什么
RAG的精髓在于那个“R”——检索。用户问一个问题,系统到底从知识库里翻出了什么“原材料”,直接决定了最终答案的质量和安全性。但很多新手在记日志时,偏偏就把这最关键的一环给漏了。
最常见的错误做法是什么?日志里只写一句:User query: 如何申请报销。然后没了。召回了几条文档?哪几条?相似度多少?有没有经过重排序?不知道。等用户拿着一个错误答案来找你时,你连模型当时“看了”什么书都不知道,怎么排查?
更隐蔽的坑是,向量库里的数据是动态更新的。你今天查到的“员工手册_v1.pdf”,下周可能就更新成了v2。如果日志里不记录文档ID和版本号,将来回溯时,你会发现同样的查询现在给出的结果已经不一样了,根本无法复现当时的情景。
还有同学把召回的文档全文直接拼进Prompt,却不把原文快照留进日志。结果呢?用户投诉说“AI回答里怎么有我部门的薪资数据?”你去看当时的Prompt日志,哦,确实拼进去了。但这个敏感片段到底是从哪个文档、哪个chunk里来的?是向量检索出了问题,还是数据预处理时没做脱敏?日志里没有文档ID,没有chunk标识,你只能把锅背在自己身上。
正确的检索审计应该像一条完整的供应链溯源。我们要记录:用户原始Query是什么;Query改写模块有没有起作用,改写后是什么;向量化检索时用的topK和相似度阈值是多少;召回的原始列表里,每个文档的ID、chunk编号、相似度分数、数据源版本都要记下来;如果用了重排序模型,重排前后的顺序变化和分数也要留痕。
用一张图来看清楚检索审计的完整链路:
我来给你一个最简版的检索审计结构:
{
  "request_id": "req_20260115_001",
  "stage": "retrieval",
  "timestamp": "2026-01-15T10:00:00Z",
  "query_original": "怎么请年假",
  "query_rewritten": "年假申请流程 请假规则",
  "retriever": {
    "type": "vector",
    "top_k": 5,
    "score_threshold": 0.75,
    "index_version": "hr_policy_v2.3"
  },
  "recalled_docs": [
    {
      "doc_id": "doc_hr_009",
      "chunk_id": "chk_034",
      "source": "hr_policy_v2.3.pdf",
      "score_original": 0.88,
      "score_rerank": 0.91
    }
  ]
}
看到没?有了这份“质检单”,不管是召回太离谱,还是混进了过期文档,你都能一秒定位。配合刚才说的request_id,这条记录能和生成阶段的日志完美串联。
好处是什么?你可以定期审计召回质量,发现某个文档总是以高分被错误召回,那就去优化向量化方案。出了内容安全事故,你也能指着日志说:“是这条数据的问题,跟检索逻辑无关。”
小结:检索阶段的审计是原材料质检单,缺了它,出了食品安全问题你都不知道是哪批菜出了问题。
3. 生成阶段审计:记录怎么答与用了什么
检索完了,就该生成回答了。这个环节是用户直接感知的“面子工程”,也是风险最高的环节。生成阶段的审计日志,核心就一句话:记录模型“吃了什么”和“吐了什么”,但别把自己搭进去。
新手在这里最容易犯两个极端。第一个极端是“记太少”。日志里就一行:Response: 好的,请稍等。Prompt呢?模型参数呢?原始输出呢?全都没有。这就好比你做了一道菜,顾客吃坏了肚子,你把空盘子给人家看,有什么用?
第二个极端更危险,叫“记太多不设防”。为了排查问题,把完整Prompt、包括用户填写的手机号、身份证号、家庭住址,一股脑全写进明文日志。开发同学倒是很开心,查问题方便了。但万一日志系统被攻破,或者内部人员越权查看,这就成了严重的隐私泄露事件。你这是为了解决一个小bug,埋了一个大雷。
还有个常见误区:不记录模型版本和参数。这周用的是GPT-4,下周切到了Claude,日志里不写明。或者temperature从0.3改成了0.8,也没有记录。等用户发现回答风格突变,或者之前修好的幻觉问题又出现了,你根本没法复现当时的环境。
正确的做法,我总结为“完整但脱敏,可复现但不裸奔”。具体来说:
第一,记录Prompt的“指纹”。你可以不存完整的长文本(尤其是当Prompt里拼了大段知识库内容时),但一定要存Prompt模板版本号、关键变量的摘要、以及一个哈希值。如果需要极致的复现能力,可以把完整Prompt存到安全的冷存储,但主审计流里用哈希和版本号来标识。
第二,记录模型的“身份证”。模型名称、版本号、API endpoint、关键参数(temperature, top_p, max_tokens)一个都不能少。
第三,区分“原始输出”和“最终输出”。模型原生返回的raw_output,和经过后处理(比如敏感词过滤、格式美化、引用标注)后的final_output,都要分开记录。假设一个客服机器人态度恶劣,如果你只记了final_output,你永远不知道模型本身是不是已经“骂人”了,只是被后处理模块给“洗白”了。
第四,敏感信息必须脱敏。用户的PII(个人身份信息)在日志中应该用占位符替换,比如<PHONE_MASKED>。如果真的需要完整内容用于排查,走专门的加密通道和权限审批。
来看一个生成审计的参考结构:
{
  "request_id": "req_20260115_001",
  "stage": "generation",
  "timestamp": "2026-01-15T10:00:01Z",
  "model": {
    "name": "gpt-4-turbo",
    "version": "2026-01-01",
    "params": {
      "temperature": 0.7,
      "max_tokens": 2048
    }
  },
  "prompt": {
    "template_version": "customer_service_v3.1",
    "content_hash": "sha256:a1b2c3...",
    "messages_count": 4
  },
  "output": {
    "raw": "根据规定,您可以在...",
    "final": "根据《员工手册》第3章,您可以...",
    "safety_filtered": false
  },
  "usage": {
    "prompt_tokens": 1250,
    "completion_tokens": 180,
    "latency_ms": 1200
  }
}
这样做的好处是什么?出了问题,你能精确复现。监管来了,你能证明你对敏感数据做了保护。运营想分析为什么最近回答变长了,你看Token消耗趋势图就行。
小结:生成日志是模型的口供,既要完整可复现,又不能把用户隐私随便摊在桌面上。
4. 日志存储与结构设计:拒绝大JSON主义
前面我们说了要记什么,现在聊聊怎么存。这是很多新手翻车翻到姥姥家的地方——把所有东西塞进一个巨大的JSON,然后往Elasticsearch里一扔,觉得万事大吉。
刚开始确实爽,查询方便,想看啥看啥。但当你发现一个月日志存储费用比GPU显卡还贵的时候,当你查一条记录要等十秒钟的时候,当你因为单条日志太大导致ES索引崩溃的时候,你就知道错了。
我见过最离谱的案例:某团队把召回的10个文档chunk全文塞进了日志,每个chunk平均3000字,加上Prompt和回答,一条日志直接干到5MB。一天十万次请求,就是50GB。更关键的是,他们还把这种日志当审计日志保留七年。老板看到云账单的时候,差点没把键盘砸屏幕上。
另一个坑是结构混乱。今天心情好,给日志加个字段叫docs_title;明天加个retrieved_content;后天发现需要文档ID,又加了个doc_ids。字段类型也不统一,有时候是字符串,有时候是数组。等你真要做聚合分析,比如统计“哪个文档被召回次数最多”,各种类型不匹配的错误能让你怀疑人生。
这种“大JSON主义”要不得。审计日志不是数据仓库,更不是知识库的备份。它的核心使命是提供证据链和分析维度,而不是把所有原始数据都复制一份。
正确的做法是“分层存储,各归其位”。我推荐一个三层架构:
第一层,Access Audit(访问审计层)。这是给法务、合规、老板看的。字段极少:时间、谁、做了什么操作、成功还是失败、涉及哪个request_id。体量最小,保留时间最长(比如七年)。存在成本低、检索快的日志服务或列式数据库里。
第二层,RAG Trace(RAG轨迹层)。这是给开发和算法同学看的。记录检索参数、召回文档ID列表、模型版本、Token消耗、耗时等元数据。注意,这里只存ID和分数,不存文档全文!保留中等时长(比如一年到三年)。
第三层,Debug Log(调试日志层)。这是给具体排错用的。可以存完整的Prompt、模型原始返回、异常堆栈。但!这一层不需要全量保留,采用错误采样或者仅当异常发生时记录。保留时间最短(七天到一个月),成本最低的对象存储就行。
用一张图来看清晰些:
在这个架构下,一条用户请求产生的日志被拆成了三份,各自去该去的地方。查询时,用法务视角看Access Audit,秒开;用开发视角,拿request_id去RAG Trace里联查,也足够快。只有真出bug了,才去冷存储里捞Debug Log。
这样做还有一个好处:权限隔离。法务不需要看Prompt里的技术细节,开发也不需要看用户的敏感身份信息(Access Audit里可以进一步脱敏)。各取所需,安全合规。
小结:日志结构是理财,该省的省,该花的花,别让日志从系统资产变成财务负担。
5. 合规查询与生命周期:让日志从负担变成资产
好,现在日志也记了,结构也分了,存储也优化了。但这还不是终点。多少团队的审计日志,写进去之后就再也没人看过,成了名副其实的“写后即焚”。直到监管上门或者出了大事故,才临时抱佛脚,加班加点导数据。
这就是第五个要点:合规与查询体系。审计日志不是埋进地里的时间胶囊,它得是随时能叫醒、随时能出庭作证的活人证词。
新手在这里常踩哪些坑?第一,没有统一查询入口。检索日志在A系统,生成日志在B系统,业务日志在C数据库。想查一次完整的用户交互,得写三段SQL,跨三个平台,最后还得用Excel手动VLOOKUP。监管要求三天内提交报告,你光拼数据就拼了两天半。
第二,没有权限管控。所有工程师都能登录Kibana看全部明文日志,实习生在排查问题时顺道看到了高管的私密咨询记录。这本身又制造了新的合规风险。
第三,没有生命周期管理。热数据存在SSD上查了三个月,温数据该归档了却还在吃计算资源,冷数据到期该销毁了还躺在那儿占地方,甚至过期的隐私数据本来该删的也没删。
第四,最致命的,没有自动化监控。一个用户连续发起了两百次prompt注入攻击,试图套取系统提示词,日志里明明有记录,但因为没有实时告警,安全团队一周后看周报才发现。这时候损失早就扩大了。
怎么解决?咱们得建立一套“查得了、管得住、删得掉”的合规体系。
首先,统一查询接口。无论底层存了多少个存储,对外暴露一个查询服务。输入一个request_id,返回完整的时间线视图:什么时候进的系统,检索召回了什么,模型生成了什么,什么时候返回的。法务小姐姐不需要会写SQL,在后台输入用户ID和日期范围,一键导出PDF报告。
其次,严格的权限分级。一线开发只能看近七天的RAG Trace,且看不到用户真实ID(用哈希值代替);安全团队可以看告警日志;只有极少数合规专员能导出原始Access Audit。所有查询操作本身也要记日志——审计日志的访问,也得有审计。
再次,设置智能告警。对高频异常请求、敏感词命中(比如用户频繁询问毒品、武器制作)、Token消耗突增、检索结果相似度异常偏低等情况,实时推送到企业微信或钉钉。把事后追责变成事前预警。
最后,明确生命周期策略。热数据保留7天,支持秒级查询;温数据转存对象存储,保留90天;冷数据归档到低成本存储,按法规要求保留3到7年;到期后自动粉碎式删除。特别是涉及个人隐私的数据,该脱敏的脱敏,该销毁的绝不能手软。
来看一个合规查询的示意:
{
  "audit_query": {
    "request_id": "req_20260115_001",
    "user_hash": "user_a3f9...",
    "time_range": ["2026-01-15T00:00:00Z", "2026-01-15T23:59:59Z"],
    "accessible_fields": ["retrieval_meta", "generation_meta"],
    "export_format": "pdf",
    "queried_by": "compliance_officer_01",
    "query_timestamp": "2026-01-20T09:00:00Z"
  }
}
看到了吗?连“谁在查日志”这件事,也要被审计。这才是真正的闭环。
小结:审计日志是睡着的证据,叫醒它的只能是完善的查询、告警和合规管理体系。
写在最后
聊到这儿,你应该看出来了,RAG审计日志这东西,真不是运维或者合规部门一个人的事儿,它是架构设计的一部分,是从你写下第一行代码时就要考虑的基础设施。很多新手害怕它,觉得繁琐、觉得影响性能、觉得“小公司没必要”。但经历过一次线上事故、一次监管问询之后,你就会明白:今天多写的那几行日志代码,将来可能就是你职业生涯的“安全气囊”。
咱们搞技术的,总想着把系统做得更快、更准、更智能。这没错。但在这个大模型野蛮生长的时代,光跑得快不够,你还得跑得稳、跑得让所有人放心。审计日志就是你的稳定器。
别再让你的RAG系统裸奔了。花一个下午,把request_id串起来,把检索和生成的关键节点记下来,把存储分层做清楚。你会发现,当事故来临时,你能从容地打开日志面板,指着那条完整的时间线说:“看,这就是当时的全部真相。”那种底气,比什么架构设计都值钱。
编程之路不易,但每一步扎实的成长都算数。保持好奇,保持敬畏,持续学习,你不仅能写出漂亮的代码,更能构建出让人信赖的系统。我是精通代码大仙,咱们下篇文章再见!
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:2026 年多模态大模型实战训练营》
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 5
 0
- 0


 已为社区贡献209条内容

所有评论(0)