
官网被AI收录却不被引用?2026年AI搜索时代的内容工程化思路
先看一个现象:很多网站的“收录量”在涨,但来自AI搜索的流量和引用基本没有。传统SEO把收录当作可见性的起点,这个逻辑在生成式检索里不成立了。收录只是让内容进了索引,引用才是让AI在回答用户问题时把你的内容拿出来当信源。两者之间,隔着一整套内容工程要求。
这篇文章不讨论GEO是不是新风口,只聊可以落地的工程动作。四个常见问题,每个配对应做法。
关键词铺排不再等于可见性
传统做法是把目标关键词铺进标题、正文、meta,让爬虫识别主题。生成式AI不同,它按语义理解“用户问题”,组织答案后再挑选信源。页面铺满“东莞小程序开发”这类词,不等于AI认为你回答了“本地哪家公司做小程序开发靠谱”。
做法:内容按用户真实问题组织,每个问题一个独立段落,结论放第一句。这既是给读者看的,也是给抽取模型看的。
为什么会失效?传统SEO里,关键词密度和页面相关性是爬虫排序的重要信号;生成式模型按语义理解问题,关键词重复不再是相关性的证据。一个页面铺满“东莞小程序开发”,在模型看来只是一段重复文本,而真正回答“本地哪家靠谱、多少钱、多久交付”的内容才有引用价值。所以与其堆词,不如把客户的问题一个一个写清楚。
内容不可抽取
AI生成回答依赖对候选内容的抽取。营销话术、模糊表述、图片里的文字,都是抽取的阻力。能用的内容长这样:问题明确、答案直接、有数字、有出处。
做法:
- 核心页面增加FAQ区块,覆盖客户高频问题;
- 结论前置,解释放后面;
- 用结构化数据标记(如JSON-LD)声明实体信息:你是谁、提供什么服务、覆盖区域、联系方式,让机器能识别页面里的实体和关系。
信任信号缺位
AI选择信源时会评估可信度,可拆解为:作者和机构身份是否明确、数据是否有来源、内容是否持续更新、有没有外部引用和第三方背书。这一套和搜索质量评估里的E-E-A-T逻辑类似,只是AI把它用得更直接。
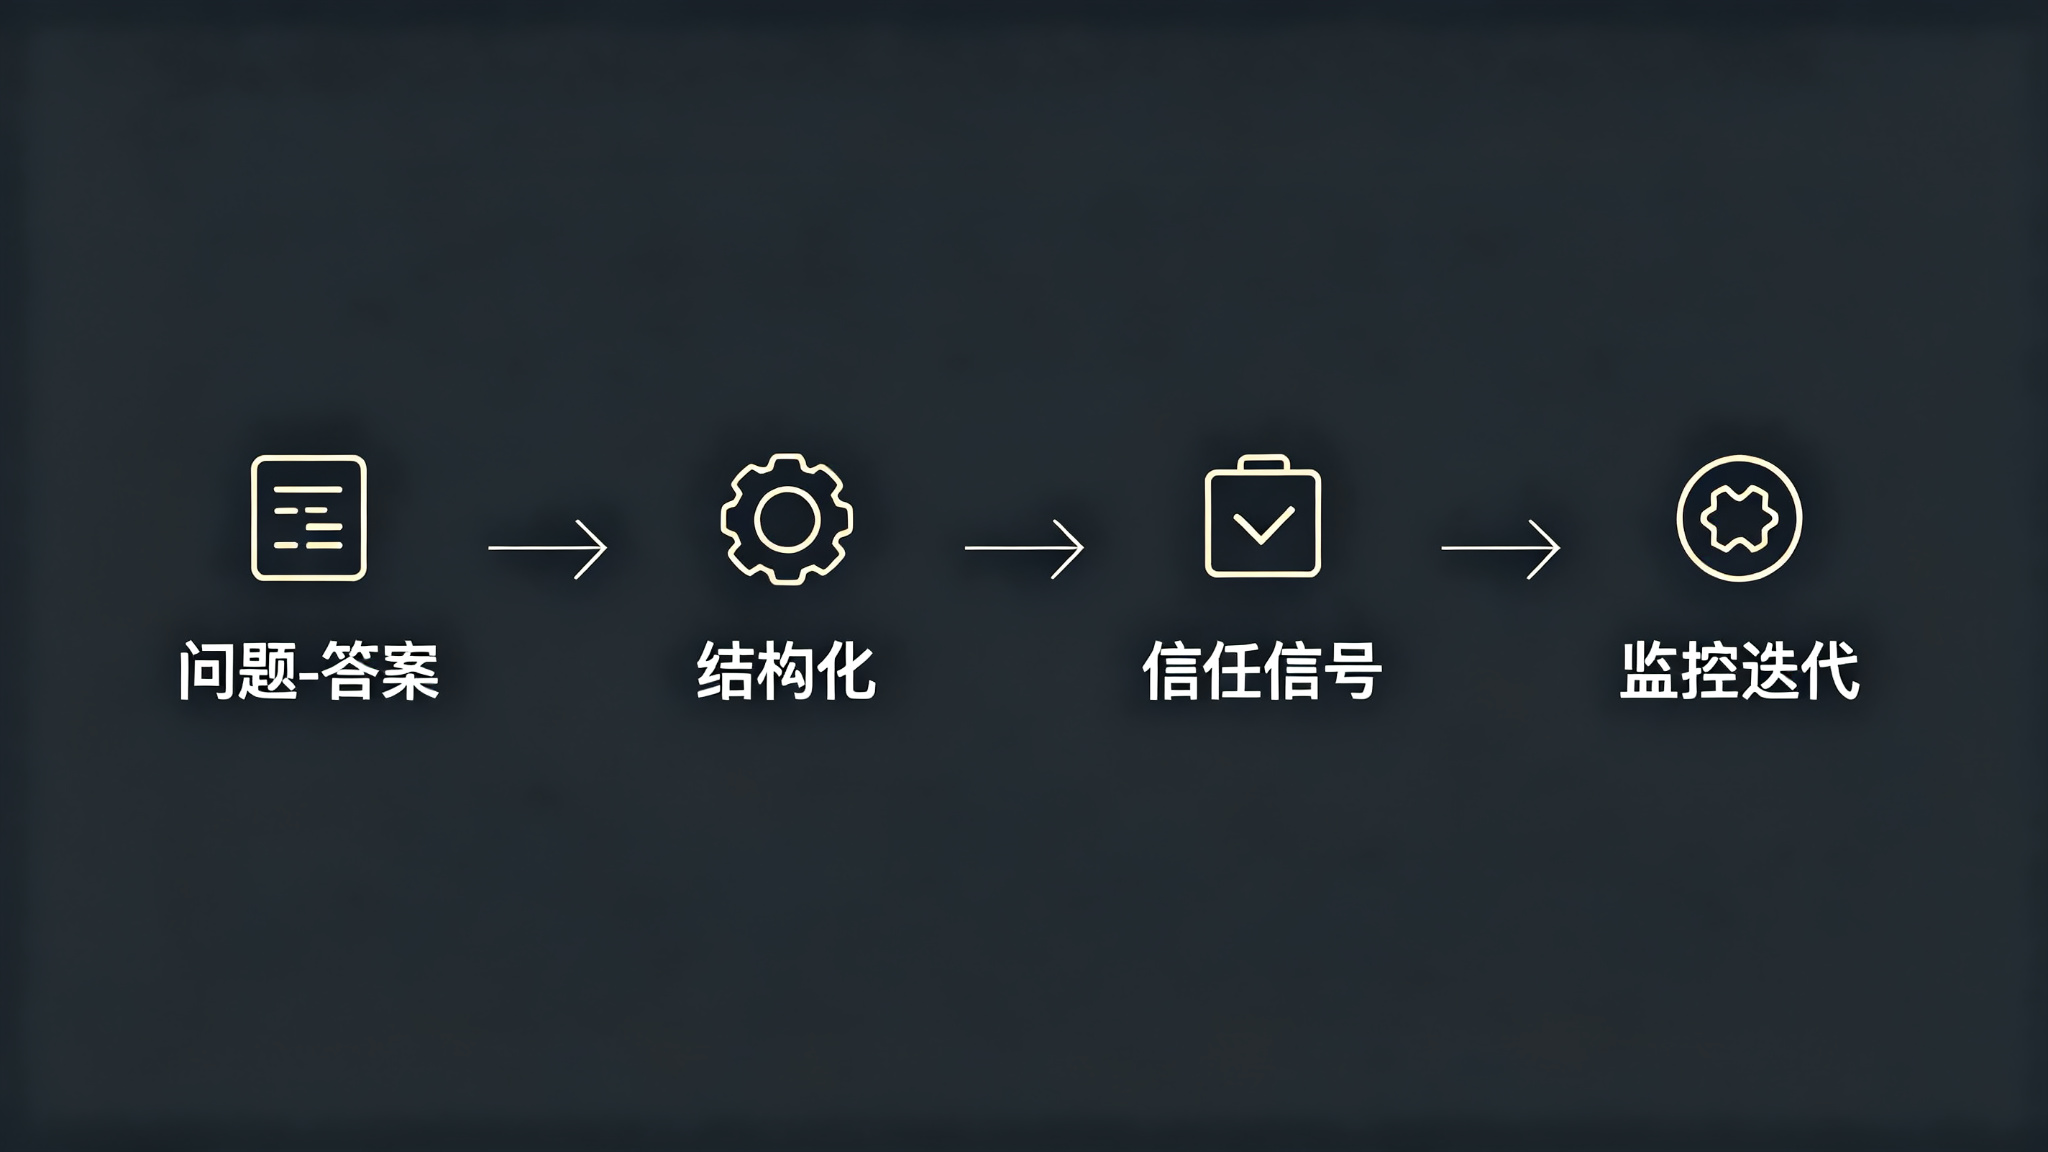
做法:文章署名、数据标来源、页面显示更新日期、客户案例和资质做成可验证的页面。信任信号是积累出来的,不是上线就有。
缺少监控闭环
AI的引用是动态的:内容会被重新评估,竞对内容在更新。没有监控,等于把判断权完全交给外部。
做法:定期做“AI引用体检”——用主流AI问答产品查询品牌词、服务词和核心问题,记录回答里有没有出现你、引用了哪里的内容、漏了哪些问题。漏掉的问题就是下一批内容选题。这个动作不复杂,难在坚持。
体检的维度可以更细:不只是看“有没有被引用”,还要记录AI在哪个问题上提到你、引用了你页面的哪段内容、描述是正面还是中性;同时看漏掉的问题里,哪些是竞对已经在回答的。这些记录攒下来,就是下一轮内容迭代的选题库。
小结:先把内容工程做对,再谈新概念。被收录只是入场券,被引用才是目标。我们在东莞做软件开发,也做运营,帮本地企业做官网GEO改造时,用的就是上面这套框架,目前反馈稳定。如果你也在做企业站,可以从FAQ结构化和引用监控两件事先试起。

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 3
 0
- 0


 已为社区贡献5条内容

所有评论(0)