
从美欧调查看「AI 采用」的测量、组织扩散与因果识别
温馨提示:若页面不能正常显示数学公式和代码,请阅读原文获得更好的阅读体验。
作者: 连小白 (连享会)
邮箱: lianxhcn@163.com
- 分类: AI 专题
- Title: 从美欧调查看「AI 采用」的测量、组织扩散与因果识别
- Keywords: AI 采用, 生成式 AI, 企业调查, 工人调查, 技术扩散, 因果识别, 生产率
提要: 美国工人工作中使用生成式 AI 的比例为 43%,六个欧洲受访国平均约为 32%。这组数字不能直接当作国家排名。本文从测量设计、组织扩散与因果识别三个层面,说明 AI 暴露、实际使用、流程嵌入和经济结果为何需要分开讨论。
有两家企业,员工都能打开 ChatGPT。一家企业为员工购买账号,允许在规则范围内处理非敏感材料,给出可用任务清单,也要求团队把高频场景沉淀为模板。另一家企业没有采购任何工具,却有不少员工把公开模型用于写邮件、翻译材料、整理会议纪要;管理层未必知道,更谈不上把它接入正式流程。
若只问企业是否采用了 AI,第二家企业很可能被记为「未采用」。若只问员工是否用过 AI,第一家企业内部真正的流程嵌入、数据接口和质量控制又会消失。更麻烦的是,若直接把任一指标与生产率或就业变化相连,我们很难判断:究竟是 AI 带来了结果,还是管理更好、数字化基础更强、人才结构更优的企业,既更容易采用 AI,也本来就有更高的生产率?
这正是 Bick et al. (2026) 这篇论文的价值所在。作者在美国和六个欧洲国家开展可比的工人调查,并结合 Eurostat 企业调查、美国 Census 的 BTOS 调查和管理实践数据,描绘了 AI 在工人、企业和行业层面的扩散。文中最醒目的数字是:2026 年,美国有 43% 的工人报告在工作中使用生成式 AI,而六个欧洲国家的平均比例约为 32%。但更值得讨论的,不是美国是否「领先」欧洲,而是这一组数字迫使我们重新界定实证研究中的 AI 变量。
本文围绕三个问题展开:
- AI 暴露、实际采用、使用强度和生产率结果,分别应怎样测量?
- 企业推动与员工自发试用,怎样共同构成 AI 的组织扩散?
- 看到「高采用行业生产率增长更快」时,哪些结论可以说,哪些仍不能说?
1. 43% 与 32%:这不是一张国家排名表
Bick et al. 的工人调查覆盖美国、德国、英国、法国、意大利、瑞典和荷兰,两轮调查分别在 2025 年与 2026 年进行。问卷先给出生成式 AI 的定义及常见工具例子,再询问受访者是否在工作中使用。这种设计并不完美,却比从职业名称或任务描述反推 AI 使用更接近研究对象本身。
结果显示,美国工人不仅更常报告在工作中使用生成式 AI,而且使用得更频繁、投入的工时也更多。作者估计,美国全部工人的工作时间中约有 5.2% 花在生成式 AI 上;这一比例包含完全不用 AI 的人。欧洲国家之间的差异同样很大,英国、瑞典和荷兰高于德国、法国和意大利。
这些数字首先说明,AI 的可得性并不会自动变成工作中的真实使用。采用率仍然不同,意味着问题不能只停在「某职业是否容易被 AI 影响」。
但也不能把 43% 与 32% 读成精确的「美欧总体差距」。工人端的欧洲样本只有六国,调查问的是受访者能够意识到的生成式 AI 使用,并不包含所有嵌入软件后台的 AI 功能。它最适合回答的是:在可比问卷下,工人是否主动把生成式 AI 用于工作,以及这种主动使用如何随国家、职业、行业和企业特征而变化。
2. AI 采用不是一个变量:从暴露到有效使用
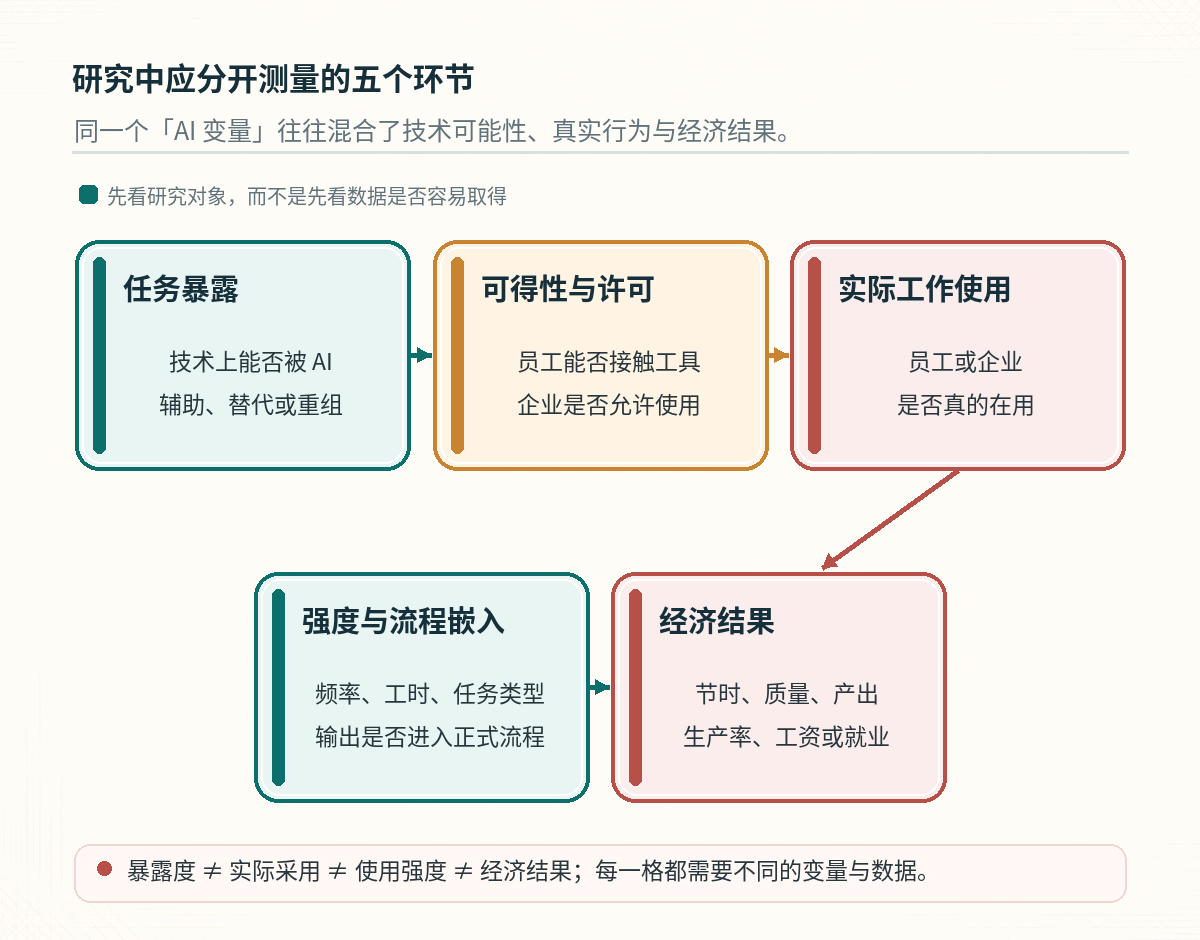
经验研究中常把「AI」写成一个二元变量,甚至把职业暴露度直接作为处理变量。这个做法方便,却会把至少五件不同的事混在一起。更清楚的表达是:
AI exposure≠actual adoption≠use intensity≠effective integration≠economic outcome.AI exposure=actual adoption=use intensity=effective integration=economic outcome.
AI 暴露度回答的是:某个任务在技术上是否可能被 AI 辅助、替代或重组。例如,文本归纳、标准化写作、代码补全的可自动化空间,通常高于线下设备维修、现场谈判或需要承担法律责任的最终判断。暴露度可以来自职业任务库、专家评分、专利或文本相似度;它描述的是技术可能性,不是现实行为。
实际采用回答的是:某位员工、某个团队或某家企业是否真的用过 AI。Bick et al. 的工人问卷属于这一层;企业调查中的「企业是否使用某类 AI 技术」也属于这一层。二者看似相近,单位却不同:前者是人的行为,后者是组织行为。
使用强度与任务嵌入继续追问:使用发生在哪些任务上、每周用了多久、AI 输出是否进入正式文稿、代码、客户回复或决策流程。只在某次写邮件时调用 ChatGPT,与每天用企业 Copilot 协助编程、检索和文档处理,不能视为同一种处理状态。
有效整合还包括工具许可、数据权限、提示词模板、人工复核、责任分配和内部流程接口。企业购入软件但员工不用,或员工自发试用却不敢把输出用于正式材料,都会使「购买」与「产生组织效果」脱节。
经济结果才是生产率、质量、工时、工资、招聘或就业。即使 AI 节省了某项任务的时间,也可能被用于核查输出、承担更多工作、改善质量,或只是缩短闲置时间。不能把自报节时直接等同于增加了同等比例的增加值。
研究设计中的一张记录卡
在构造 AI 变量前,至少写清五项:观察单位是任务、员工还是企业;时间窗口多长;使用的是个人工具还是企业工具;使用频率与任务类型如何记录;结果变量是节时、质量、产出还是劳动力调整。若这五项中有两三项模糊,变量名称不宜直接写成「AI 采用」。
这也是本文与一般 AI 暴露度文章的分工:暴露指标仍然有用,它可以帮助我们预测哪些任务最可能发生变化;但若研究问题是「AI 使用是否改变了企业行为或劳动结果」,暴露度不能替代采用数据。
3. 同一句「是否使用 AI」:问卷口径为何会改变结论
这篇论文最值得借鉴的,不只是作者做了跨国调查,而是它反复展示了测量口径如何改变结论。
在工人端,作者问的是生成式 AI 是否用于工作,随后追问使用频率、使用时长、节省时间和未使用原因。这一设计的优点是清楚地区分了工作使用与私人使用,也能把二元采用率推进到使用强度。局限在于它依赖自报:被访者未必知道软件中嵌入了 AI,也可能把偶尔的尝试记为稳定使用。
企业端的差异更大。Eurostat 的企业调查列出多类具体 AI 技术,并询问其用于营销、生产、管理、物流、财务、研发等哪些业务功能。2025 年,欧盟中雇员不少于 10 人的企业里,约 20% 报告使用至少一种 AI 技术。美国 BTOS 在 2025 年 11 月前使用的核心问题却更窄:企业是否将 AI 用于「生产商品或服务」。在这种口径下,Bick et al. (2026) 报告美国 2025 年初的比例约为 7%,欧盟同一窄用途的平均比例约为 4%。
这两个数字不能被拼成「美国 7%,欧盟 20%」的比较。它们服务的是不同问题:一个接近全部业务用途,一个只看生产或服务过程。美国 Census 也在 2025 年 11 月将 BTOS 的提问改为 AI 是否用于「任何业务功能」。这不是文字润色,而是处理变量定义发生了变化。BTOS 的官方改版说明 对此有明确记录。
因此,跨国或跨数据库合并 AI 采用率时,至少应逐项核对:
- 采用的是生成式 AI,还是更广义的机器学习、视觉识别、自动化决策;
- 问的是过去两周、过去三个月,还是企业当前是否拥有某项技术;
- 回答者是普通员工、部门主管、ICT 负责人,还是企业决策者;
- 企业样本是否排除了小微企业、金融业、农业或公共部门;
- 采用率是企业数加权、就业人数加权,还是工人样本加权;
- 同一类技术在不同年份是否增加、删除或改写了类别。
对中国研究者而言,这一节有一个很直接的启发:用年报文本、专利、招聘广告或问卷构造变量时,应在文章中明确写出该变量更接近「技术暴露」「企业投入」「管理层表述」「员工实际使用」中的哪一种。没有一种代理变量天然覆盖全部层次。

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)