
【大模型RAG生成式AI开发实战】《大模型RAG生成式AI开发实战》_239.[第24章 面试与职业发展] 技术博客运营:用RAG内容打造个人品牌
别再让你的RAG项目经历烂在硬盘里发霉了!这篇文章要告诉你,如何把大模型检索增强生成的实战经验,变成让猎头主动敲门、让面试官提前认可你的硬核个人品牌资产。读完你会彻底明白:顶尖程序员的护城河从来不只是代码,而是可传播、可检索、可复利的“技术影响力”。
文字目录
- 赛道定位:找到你的RAG人设坐标
- 内容选题:从调参日记到架构思辨
- 叙事技巧:把报错写成悬疑小说
- 可视化:让流程图成为记忆锚点
- 持续运营:对抗算法与倦怠
- 品牌闭环:博客即隐形简历
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《大模型RAG生成式AI开发实战》239.[第24章 面试与职业发展] 技术博客运营:用RAG内容打造个人品牌
俗话说得好,“是金子总会发光的”,但大仙我得补一刀:在这个AI一周一迭代、信息严重过载的年代,金子也得自己学会打光,不然就只能烂在矿坑里,还得被人踩两脚。你是不是也这样?RAG项目实打实做了好几个,向量数据库从Milvus换到Qdrant再玩到PGVector,Prompt调优调到看见OpenAI的文档都想吐,结果一写简历,只能干瘪地写上“熟悉LangChain”和“了解RAG基本流程”。面试的时候,明明你亲手解决过百万级文档下的检索精度暴跌问题,嘴皮子磨破了,面试官却一脸“你确定这不是背八股文”的狐疑。更扎心的是,跟你同水平坐一排的小伙伴,就因为坚持写了半年博客,被猎头主动挖走,薪资倒挂你百分之三十。焦虑吗?焦虑就对了!今天咱们就好好聊聊,怎么用RAG内容做燃料,把你的技术博客打造成个人品牌的核动力引擎。
赛道定位:找到你的RAG人设坐标
很多新手写博客,第一步就走岔了。他们把博客当成云笔记,今天手撕一个Transformer注意力机制,明天复现一个LoRA微调,后天突然跑来写一个RAG入门。看起来你很全能,实际上读者看完一脸懵:“这位老哥到底是干嘛的?”在大模型时代,“全能”约等于“没有标签”,“没有标签”就等于“平台算法不推你,面试官记不住你”。你要做的第一件事,就是在RAG这条黄金赛道里,找到一个足够尖锐、足够垂直的切入点,给自己立一个“人设坐标”。
我见过太多这样的博客主页了。点进去,最近一篇文章是《Python装饰器详解》,往前翻是《React Hooks最佳实践》,再往前是《基于LlamaIndex的RAG五分钟入门》。兄弟,你以为自己在秀知识广度,其实在读者和HR眼里,这就是“技术流浪者”。没有垂直度,算法根本不知道把你的内容推给谁;没有固定标签,面试官翻完你的主页,脑海里留不下任何记忆点。
举个例子,有个粉丝叫阿强,他跟我诉苦:“大仙,我写了一年博客,阅读量惨淡,面试也没加分。”我点开他的主页,好家伙,一年写了四十篇,涉及八个技术领域,RAG相关的只有五篇,还都是“什么是Embedding”、“向量数据库简介”这种泛泛而谈的科普向。有一次他去面试一家做大模型应用的公司,面试官问他:“你在RAG方面有什么深入理解?”阿强当场卡壳。他虽然写过几篇,但全是零散的知识点,没有形成体系,更没有展示过他解决真实复杂问题的能力。这就是典型的“散点式写作”,看似忙忙碌碌,实则原地踏步。更惨的是,因为他没有固定标签,平台算法也懵圈,不知道把他推给哪类读者,每篇文章都像往大海里扔了一根针,连个响儿都听不见。
那正确的做法是什么?给自己贴一个“RAG细分标签”。注意,不是“AI博主”,也不是“大模型开发者”,而是具体到RAG的某一个纵深领域,扎进去做深。比如你可以是:
企业级RAG架构师。你专注写分布式检索集群的搭建、多租户场景下的数据隔离方案、RAG系统的全链路可观测性、以及高并发下的延迟优化。你的读者画像就是工程Leader和架构师。
RAG算法优化师。你专注写Embedding微调的实际技巧、重排序模型的选型与训练、查询改写策略的对比实验、以及混合检索的权重调优。你的读者画像是一线算法工程师。
RAG评测与交付专家。你专注写RAGAS指标在业务中的落地、幻觉检测的工程化方案、A/B测试的方法论、以及 bad case 的归因分析。你的读者画像测试负责人和AI产品经理。
垂直行业RAG解决方案师。你专注写医疗病历的分块与向量化、法律文书的检索增强、或者电商客服的RAG落地。你的读者画像是业务开发者。
阿强后来听了我的建议,把之前杂七杂八的文章该隐藏隐藏,专注输出“医疗领域RAG落地”系列。从病历的分块策略,到医学术语和普通口语的向量对齐,再到针对幻觉的Prompt约束工程。连续写了八篇之后,奇迹发生了。搜索“医疗RAG”相关关键词,他的文章能排进前三,还有三家做智慧医疗的公司HR私信问他要不要聊聊。你看,这就是垂直定位的威力——你不需要讨好所有人,只要让需要你的人一眼看到你,就够了。
你也可以用下面这个思路图来锚定自己:
记住,定位不是给自己画牢笼,而是在一片红海里,给自己挖一条独有的战壕。让读者提到某个细分问题时,脑子里第一个蹦出来你,你就赢了第一局。
内容选题:从调参日记到架构思辨
定位定好了,接下来就该琢磨写啥了。新手最容易踩的第二个大坑,就是把博客写成“实验报告”或者“成功学流水账”。调参日记不是不能写,但单纯的“今天我试了Top-K等于5比Top-K等于10效果好”这种内容,没有任何信息增量,读者看完只会觉得“就这?”。高质量的RAG博客,必须提供架构级的思辨,要让读者看完发出“原来还能这么玩”的感叹,甚至想立刻收藏。
来,看看你是不是也写过这种文章。标题叫《RAG项目实战记录》,正文第一段“最近公司要做知识库,领导让我调研RAG”,第二段“我选了LangChain加Chroma加GPT-4”,第三段贴一段初始化代码,第四段“运行成功,效果还不错”,结尾“以上就是本次分享,希望对大家有帮助”。兄弟,这叫备忘录,不叫博客。读者能从里面学到什么?什么都没学到。你解决了什么问题?不知道。遇到坑了吗?没提。性能数据呢?没有。这种内容在信息海洋里就是一片浮沫,看过即忘,连被收藏的资格都没有。
更严重的错误是“知识搬运”。有些同学看了几篇英文论文,翻译一下摘要,配两张原文截图,就当成自己的博客发出去。这种“二手信息”没有任何个人品牌加成,因为读者直接去看原文不香吗?面试的时候,面试官一问消融实验的细节,搬运工立马露馅:“呃,这篇是我翻译的,具体实验我没复现过。”场面一度非常尴尬,品牌在面试官心里直接塌方。
要把选题从“流水账”升级为“深度复盘”,你需要掌握“问题驱动写作法”。每一篇博客,都要围绕一个真实、具体、有痛感的问题展开。我常用的结构是五个环节:背景冲突、方案对比、踩坑实录、数据验证、方法论沉淀。
举个例子,同样是写RAG检索优化,低质量的写法是:“我用了HyDE查询改写,效果不错,推荐大家试试。”高质量的写法应该是:《百万级知识库下,HyDE查询改写让我的RAG召回率提升了百分之二十三,但差点把延迟搞崩——从索引选型到Fallback策略的完整复盘》。
在这个标题里,包含了场景感、技术点、量化结果、冲突张力、以及体系深度。正文怎么展开?先交代业务背景:公司客服知识库接入RAG后,用户问法口语化且多样化,传统向量检索经常漏召回,导致大模型开始胡编。然后抛出你的调研过程:试过微调Embedding,标注成本太高,周期两个月,业务等不起;试过BM25混合检索,效果有提升但天花板明显;最后锁定HyDE,因为能在不改动向量库的前提下,用生成假设文档来扩展查询语义。
接着写接入过程的真实波折:发现HyDE生成假设文档后,向量检索的延迟从两百毫秒暴涨到一点二秒。第一反应是模型生成太慢?不对,生成只用了三百毫秒。第二反应是网络开销?也不对。最后通过打点发现,生成的假文档太长,向量计算量爆炸,而且用的是Flat暴力索引。切换到IVF_PQ索引并缩短假设文档长度后,延迟回落到三百毫秒,召回率还保持住了。最后写兜底策略:HyDE不是银弹,当置信度低于阈值时,Fallback到标准检索,保证极端情况下的稳定性。
你看,同样是写HyDE,这种写法不仅展示了技术深度,还体现了工程思维——没有完美的技术,只有权衡后的方案。面试官看到这种文章,眼睛会发光,因为你在教他怎么当一个靠谱的架构师,而不是一个只会跑Demo的调参侠。
叙事技巧:把报错写成悬疑小说
有了好选题,怎么让人看得下去?技术内容天然有阅读门槛,RAG又涉及检索、向量、Prompt多个环节,逻辑链条长。如果你平铺直叙,读者读到一半就跑了,去刷短视频了。高手写技术博客,都懂一个秘诀:制造叙事张力。把一次Debug过程,包装成一场悬疑推理,让读者追着看。
我见过太多“反人类”的技术博客排版了。上来先贴五十行环境配置,然后啪地扔出一段一百行的报错信息,红色的Stack Trace占满整个屏幕,作者就轻飘飘写一句:“大家注意这个错,然后改一下参数就好了。”我看好几行?哪个参数?为什么改?读者一脸懵逼地进来,一脸懵逼地出去。
还有的博主写RAG优化,上来就整数学公式:“查询向量q与文档向量d的相似度计算如下……”然后贴一个余弦相似度的LaTeX公式。兄弟,除非你在写论文投稿ACL,否则这种写法在大众博客平台就是自杀。大部分读者是通勤路上刷手机看的,你搞这么严肃,谁看得下去?更典型的是说教口吻:“你们一定要做查询改写,不然效果很差。”这种居高临下的语气,读者看了就想关页面,心说“你谁啊就教育我”。
要把RAG技术写得引人入胜,你要学会做“技术导演”。我分享三个亲测好用的叙事技巧。
第一,开篇抛尸。别从环境配置开始,直接从最诡异、最反常识的现象切入。比如你可以这样写:“上周三凌晨两点,我们的RAG客服系统突然‘发疯’了。用户问‘怎么重置密码’,大模型居然回答‘建议你去申请一张白金信用卡’。我当场就清醒了。检索日志显示,Top-3召回的文档明明都是密码相关的操作手册。文档对了,模型为什么答非所问?问题到底出在哪?”
你看,这不比“今天介绍RAG的上下文污染问题”吸引人一百倍?读者会立刻好奇:召回对了,生成却错了?这什么鬼?他就会跟着你的思路往下挖。
第二,扮演福尔摩斯。把排查过程写成推理链条,不要直接给答案。接上文的例子,你可以继续写:“我第一反应是Prompt被恶意注入了。但检查日志,用户输入里没有任何异常字符。第二反应是文档拼接格式有问题。果然,我在构建上下文时,用了简单的字符串join,两篇文档的边界模糊不清,模型把‘信用卡申请’的文本当成了‘密码重置’的上下文,产生了幻觉。但等等,为什么偏偏召回了信用卡的文档?继续往下查,发现向量检索召回的Top-K其实没问题,问题出在重排序阶段,模型把信用卡文档排进了前三……”
这种层层递进的写法,让读者有强烈的参与感,仿佛跟你一起坐在电脑前Debug。哪怕他暂时没遇到这个问题,也会觉得“这博主思路好清晰”,从而毫不犹豫地点个关注。
第三,善用口语化内心OS。在关键步骤插入你的想法和情绪:“当时我在这里卡了整整一个下午,气得差点把键盘砸了”、“说实话,我之前一直以为BM25是老古董,这次真香了”、“这个坑官方文档提都没提,害我头发又少了两根”。这种句子瞬间拉近你和读者的距离,让你从一个冷冰冰的“教程作者”变成“一起熬夜加班的战友”。技术博客的最高境界,是让读者在获得知识的同时,获得阅读爽感。
可视化:让流程图和代码成为记忆锚点
人的大脑天生对图像比对文字敏感。RAG系统又是一个典型的多阶段流水线,涉及查询理解、检索、重排、上下文构建、生成等多个模块。纯文字描述很容易让读者迷失在“检索前处理”、“向量匹配”、“后处理重排”这些抽象概念里。所以,一张清晰的流程图,抵得上你写五百字。同样,代码展示也有讲究,大段粘贴是自杀,精准切片才是艺术。
回忆一下,你是不是写过这样的段落:“用户提问之后,系统会先进行查询改写,然后发送到向量数据库进行相似度检索,检索回来的结果会经过一个重排序模型,然后再把相关的文档片段插入到Prompt模板里,最后交给大模型生成答案……”写到这儿你自己都晕了吧?读者更晕。RAG的流程本来就涉及五六个模块,你用纯文字线性描述,读者很难建立空间记忆。更糟糕的是,有些博主知道要画图,结果掏出Windows画图板,画几个歪歪扭扭的矩形,箭头交叉得像盘丝洞。这种图不仅没有辅助理解,还显得很不专业,掉价。
代码展示方面,新手最常见的错误是“dump”。一篇文章贴两百行代码,从import到main函数全在里面。手机端读者看到满屏代码,第一反应就是左滑退出。而且你没有高亮关键行,读者根本不知道重点在哪里,只能对着屏幕发呆。
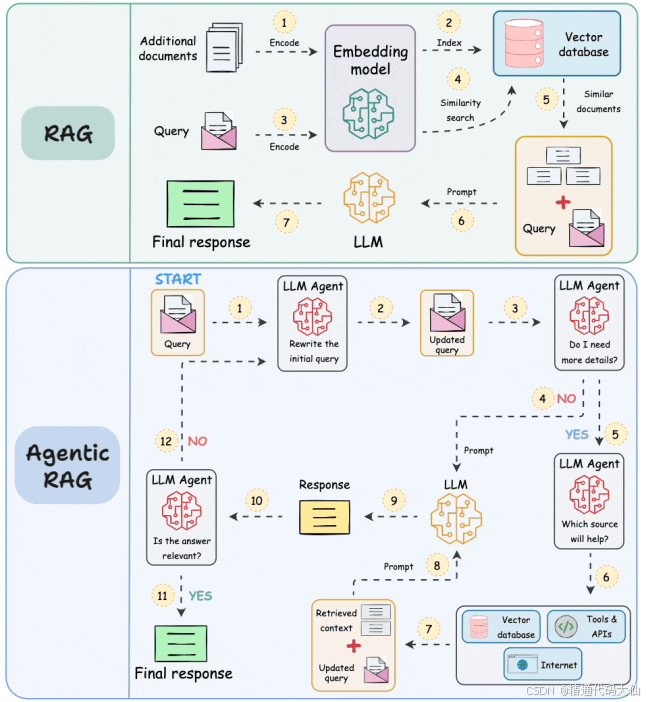
首先,每篇深度博客至少配一张架构图或流程图。RAG是流水线型架构,特别适合用流程图展示。而且不要用手绘,直接用Mermaid画,既专业又清晰,还能体现你是“硬核程序员”的审美。
比如你要讲一个带“查询路由”和“重排序”的RAG流程,可以这么画:
你看,这张图一出来,读者秒懂你的RAG不是简单的一路到底,而是有智能路由、有精排、有兜底策略的工程化系统。而且因为你是用代码画的图,其他程序员天然就会觉得你“很对味”。
其次,代码要切片,不要dump。一篇博客里,核心代码不要超过三个区块,每个区块控制在三十行以内。展示的时候,用注释标出关键行,告诉读者“看这里”。比如你要展示RAG的Context构建逻辑:
# 关键:不是简单拼接,而是加入文档来源标记
def build_context(retrieved_docs):
    contexts = []
    for idx, doc in enumerate(retrieved_docs):
        # 每个文档块前标注来源,防止模型混淆边界
        contexts.append(f"[来源{idx+1}] {doc.page_content}")

    # 超过窗口长度时,优先保留高相关度片段
    return "\n\n".join(contexts)[:MAX_CONTEXT_LEN]
就这几行,把“为什么要标注来源”和“长度截断策略”都点到了。读者看完能记住,面试时也能直接复述出来。
另外,数据对比尽量用表格或简易图表。比如对比不同Embedding模型在RAG任务上的Recall表现:
在这个读图时代,可视化不是锦上添花,是技术博客的及格线。一图一表一段精品代码,才能让RAG的复杂逻辑真正住进读者脑子里,成为你个人品牌的记忆锚点。
持续运营:对抗算法与倦怠的双重夹击
很多新手博主夭折,不是因为不会写,而是因为熬不过“冷启动期”。发了三篇,阅读量两位数,心态崩了,从此封笔,账号长草。还有一种是“鸡血型”,发誓日更,结果两周就把弹药打光,陷入极度倦怠,看见Markdown编辑器就想吐。写技术博客是长跑,你需要一套“可持续运营系统”,而不是靠意志力死撑。
先说算法。各大技术平台的推荐机制,对新手极不友好。你的第一篇RAG博客,哪怕质量炸裂,也很可能被淹没在“Hello World”的海洋里。因为没有历史权重,没有粉丝基础,算法不会给你推流。这时候如果你的心态是“我写一篇就必须爆一篇”,那你离放弃就不远了。很多优质的RAG深度文,前期的冷启动阅读量可能都不过百,但半年后会被搜索引擎带火,带来源源不断的长尾流量。
再说倦怠。技术博客的写作成本极高。一篇有深度的RAG复盘,从整理思路、画Mermaid图、写可运行代码、验证数据,到最终排版,动辄五六个小时。如果你工作已经很忙,还要强迫自己周更,很快就会把写作从“兴趣”变成“酷刑”。我见过太多“间歇性踌躇满志,持续性断更半年”的账号了,粉丝刚积累几十个,一看停更太久,直接流失。
还有一种隐蔽的坑叫“自嗨式更新”。有些人为了维持频率,把一个很小的点硬生生水成三篇,或者写一些“RAG学习笔记Day1”这种对自己复盘、对他人毫无价值的内容。这种更新不仅不能积累品牌,还会稀释你的专业度,老粉看了都摇头。
怎么破?第一,建立选题蓄水池。不要等要发了才想题目,那样压力巨大。平时工作中遇到一个棘手的RAG Bad Case、读到一篇启发性的论文、甚至在群里看到一个高质量的讨论,都立刻扔进你的选题库。我通常保持选题库里有二十个以上的待写话题,这样我永远不会“没东西写”,打开编辑器只需要挑一个最有感觉的。
第二,控制节奏,质量绝对大于数量。对于在职的程序员,我建议双周一篇深度长文,比一周两篇水文效果好十倍。深度内容有长尾流量,半年之后还会被人通过搜索找到。水文则发完三天就归零,连点浪花都没有。
第三,学会“一鱼多吃”。一次完整的RAG项目,你可以拆解出至少三篇博客:第一篇讲整体架构设计与选型理由,面向架构师读者;第二篇讲核心踩坑与Debug实录,面向一线开发者;第三篇讲性能优化数据与方法论沉淀,面向技术负责人。这样一来,你一个月的弹药,其实只需要一个项目素材就能支撑。而且系列文章之间还能互相引流,读者看完一篇会点进你的主页追更。
第四,主动对抗算法冷启动。新文章发布后,先发到你的技术社群、朋友圈、团队内部,积累最初的互动量。算法看到有点赞、收藏、评论,才会试探性地给你推一波。别怕不好意思,你写的是RAG干货,又不是水文,分享出来是在做技术慈善。
第五,和读者建立真实连接。评论区有人问问题,尽量回复。这不仅是人情世故,也是在为你自己的博客“加热”。一条高质量的评论区答疑,有时比正文还精彩。而且在这个过程中,你能收到真实的反馈,知道下一篇该写什么,甚至能收获一批铁杆粉丝。
技术博客的个人品牌,是时间的朋友。你要做的不是百米冲刺,而是找到自己的呼吸节奏,让写作像健身一样,成为习惯,而不是负担。
品牌闭环:让博客成为面试的“隐形简历”
终于说到大家最关心的了:写博客到底能不能帮我升职加薪?我的答案是:不仅能,而且它是顶级程序员的“降维打击武器”。当你还在简历上干巴巴地写“熟悉RAG技术栈”时,别人已经递上了一整页博客链接,每一篇都是技术深度的铁证。面试官在面试你之前,就已经被说服了一半。
太多程序员面试时吃亏在“不会表达”。你明明花三个月做了一个企业级RAG项目,解决了查询改写、多路召回、幻觉抑制一堆难题。但面试只有三十分钟,你口述五分钟,面试官可能还没get到难点在哪。更糟糕的是,如果你面试紧张,逻辑混乱,本来八十分的项目,讲出来只剩五十分,亏不亏?
还有一种情况是“同质化竞争”。现在简历上写“有RAG经验”的人太多了。面试官一看,十个候选人九个都写“使用LangChain构建知识库问答系统”。你怎么证明你比别人强?靠口头说“我调参很细”?人家凭什么信你?甚至有些同学,简历上写了RAG项目,但被一问细节就露馅:“你们Embedding模型怎么选的?”“召回率低的时候怎么排查?”“有没有做幻觉检测?”如果只是跟着教程跑过Demo,这些问题根本答不上来,当场社会性死亡。
博客就是你的“技术证据链”。首先,简历上不再是干瘪的文字,而是可点击的作品集。在简历的项目经验部分,你可以这样写:“主导公司RAG知识库架构升级,相关技术复盘已发布于个人技术博客,含性能对比数据与架构演进图。”如果面试官感兴趣,他很可能在面试前就会点进去看。当他看到你的Mermaid架构图、看到你详细记录的延迟优化数据、看到你对比了三种重排序模型的优劣,他内心已经给你打上了“这人有干货,思路还清楚”的标签。
其次,面试时,博客是你的提词器。面试官问:“你在RAG项目中遇到最大的挑战是什么?”你不需要临场组织语言,直接说:“最大的挑战是上下文长度限制导致的多文档拼接丢失问题。当时我尝试了几种策略,最后发现按相关度加权截断效果最好,这个我在博客里有详细记录,包括当时的性能对比和踩坑过程。”这种回答既展示了问题复杂度,又暗示你有复盘习惯。如果面试官追问细节,因为你写过,记忆会非常深刻,回答起来条理分明,气场全开。
第三,谈薪时的溢价筹码。个人品牌本质上是信任前置。当面试官通过你的博客认可了你的技术影响力,他在给你定薪时,会更愿意给你高阶的职级。因为你不仅能写代码,还能传播技术、能沉淀方法论,这种人是天生的Tech Lead苗子。很多公司招高级开发,看的不仅是代码能力,还有技术布道和团队赋能能力。你的博客,就是最好的布道现场。
第四,打造职业选择的主动权。当你的RAG博客在细分领域有了一定知名度,你会发现猎头和行业大佬开始主动链接你。这时候不是你求着公司给Offer,而是你在挑平台。个人品牌带来的选择权,是任何短期加班都无法换取的稀缺资产。
在职业发展的牌桌上,代码能力是你的底牌,而技术博客是你的明牌。让面试官在面试你之前就已经欣赏你,这才是最高级的面试技巧,也是最硬核的个人品牌护城河。
写在最后
老朋友们,咱们今天从赛道定位、内容选题、叙事技巧,聊到了可视化、持续运营和品牌闭环。你会发现,写技术博客这件事,表面上是在输出内容,本质上是在经营一个“可搜索、可复用、可增值”的数字资产。每一篇关于RAG的深度博客,都是你未来职业生涯的一枚硬币,当时投下去可能没感觉,但日积月累,它们会产生惊人的复利,在你跳槽、转行、甚至创业的时候,连本带利地回报你。
我知道,刚开始写的时候,阅读量惨淡、没人点赞、甚至被人喷“写得什么玩意”,这些都是必经之路。我大仙当年第一篇博客,写了整整一周,阅读量只有三十七,其中还有二十次是我自己闲着没事点进去看的。但那又怎样?你只要坚持垂直、坚持深度、坚持真诚,时间会站在你这边,算法迟早会眷顾你。
RAG技术还在飞速进化,从基础的向量检索,到Agentic RAG、到多模态RAG、再到与具身智能的结合,这片蓝海足够大,容得下每一个愿意深耕的程序员。你不需要成为最顶尖的那个算法天才,你只需要成为那个“把复杂问题讲清楚、把实战经验写明白、让读者看完真能少走弯路”的人。
编程之路不易,技术迭代很快,但每一步扎实的输出都算数。保持好奇,保持表达欲,保持那股“我偏要把自己学明白的东西讲给全世界听”的轴劲儿。相信我,当你把博客写成个人品牌的那一天,Offer会来找你,机会会来找你,甚至连你曾经仰望的大佬,也会来评论区跟你讨教问题。
去做吧。就从你的第一篇RAG深度复盘开始。键盘就在你手里,光,得自己打。
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:2026 年多模态大模型实战训练营》
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 0
 0
- 0


 已为社区贡献209条内容

所有评论(0)