
【大模型RAG生成式AI开发实战】《大模型RAG生成式AI开发实战》_235.[第24章 面试与职业发展] RAG面试高频题:幻觉处理和评估方法
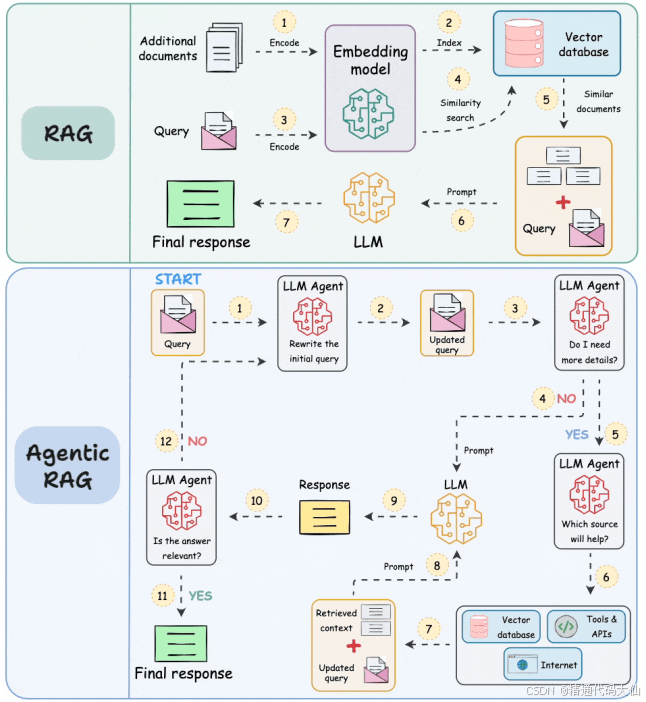
面试官问你"RAG怎么解决幻觉"时,你还在背八股文?这篇文章一次性把幻觉的"根"和"评估的尺"都给你讲透。从向量召回的隐形陷阱到生成层的疯狂脑补,从离线评测的冷启动到在线监控的指标体系,我们不只是罗列概念,而是手把手教你在面试场上不仅能答出来,还能让面试官眼前一亮——因为你知道信息是怎么在检索时丢的,也知道答案是怎么在生成时编的,更知道怎么用一套度量体系让幻觉率从"玄学"变成"可计算"。这才是区分"调包侠"和"工程师"的真正分水岭。
文字目录:
- 先搞懂——RAG幻觉到底"幻"在哪儿?
- 检索侧幻觉:你的知识库正在悄悄"埋雷"
- 生成侧幻觉:大模型的"脑补"比编剧还离谱
- 检测与缓解:给幻觉"拍CT"和"做手术"
- 评估体系:没有度量,就没有管理
- 面试实战:把项目经历变成你的"护城河"
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《大模型RAG生成式AI开发实战》235.[第24章 面试与职业发展] RAG面试高频题:幻觉处理和评估方法。
俗话说,“出来混,迟早要还的”。在RAG这行混,幻觉就是你欠下的技术债。你在开发阶段偷的懒——切片随便切、评估靠感觉、上线靠运气——上线后用户会连本带利地讨回来。今天面试官问你"怎么处理幻觉",你支支吾吾;明天线上用户投诉你"胡说八道",你手忙脚乱。
你是不是也在简历上写了"精通RAG开发",结果心里直打鼓?你是不是搭了一个向量数据库加LangChain的Demo,就以为掌握了RAG的全部?如果你点头了,那这篇文章就是为你写的。幻觉处理和评估方法,这不仅是面试的高频考点,更是区分一个RAG工程师是"玩具开发者"还是"工业级开发者"的核心分水岭。别怕,学长今天就把这一锅饭,一口一口喂给你吃。
一、先搞懂——RAG幻觉到底"幻"在哪儿?
很多新手有个误区,以为上了RAG就万事大吉,大模型不会再 hallucinate 了。醒醒吧,RAG确实能缓解纯参数化的幻觉,但它引入了一套全新的幻觉来源。RAG幻觉本质上分两大阵营:检索侧幻觉和生成侧幻觉。前者是"给错了弹药",后者是"拿错了枪还乱打"。
我见过太多同学,线上RAG回答出错了,第一反应是:“肯定是模型不行,换个GPT-4试试。” 结果呢?换了更强的模型,幻觉一点没减少。这就是典型的"头痛医头,脚痛医脚",连病因都没找对。
举个我亲身经历的Case。之前有个学弟做企业内部知识库问答,用户问"2024年的年假政策有多少天?" 向量库召回了一个2023年的旧文档片段,还有一个完全无关的"加班调休"片段。大模型拿到这两块上下文,居然一本正经地总结:“2024年年假为5天,且可以通过加班调休增加。” 实际上2024年政策已经改成10天了。这就是典型的检索侧幻觉——上下文本身就不对,模型越聪明,编得越像真的。
错误思维是这样的:幻觉 = 模型烂。所以疯狂微调模型、换更大的基座。这就像是厨房着火了,你不关火源,反而换了一把更贵的锅。
你要建立"双归因"的思维框架。遇到幻觉Case,先问两个问题:第一,检索回来的Top-K里,有没有包含正确答案?第二,如果有正确答案,模型有没有"看见"并"相信"它?
排查链路应该是这样的:拿到Bad Case -> 打印检索结果 -> 检查文档切片边界 -> 检查向量相似度分数 -> 检查Prompt中的上下文排列 -> 最后才怀疑模型能力。
正确做法是画一张"幻觉归因图"。横轴是检索质量,纵轴是生成忠实度。四个象限里,只有右上角是"好答案"。如果你发现大多数Bad Case落在左半区,先优化检索;落在右半区,再优化生成策略。
这样做的好处是,你把一个玄学问题,变成了工程定位问题。面试官听到你讲"先查检索日志再谈模型优化",眼神都会变。
小结: RAG幻觉不是单点故障,而是系统噪声。找不到根因的优化,都是盲人摸象。
二、检索侧幻觉:你的知识库正在悄悄"埋雷"
如果把RAG比作开卷考试,检索侧幻觉就是"你翻到了错误的参考书页"。它的罪魁祸首往往藏在最不起眼的地方:文档预处理、切片策略、向量化模型、召回算法。这些地方出问题,比大模型本身出问题更隐蔽,也更致命。
新手最容易在切片上翻车。我见过最离谱的做法是:不管三七二十一,按固定500字符一刀切。这就好比把一本小说的每一章都撕成碎片,然后问读者"主角为什么黑化"。你把"原因"和"结果"切到了两个不同的块里,向量检索只能召回一半信息,大模型拿到残缺上下文,除了脑补还能干嘛?
还有一个经典误区:盲目相信向量相似度。学弟问我:“大仙,我召回的Top3相似度都0.9以上,为什么答案还是错的?” 我让他把召回片段打出来一看,笑死,全是"本公司保留最终解释权"这种通用废话。查询问题是"退款流程是什么",召回的却是用户协议里的标准免责声明。语义上确实相似,但信息上完全不相关。这叫"伪相关",是向量空间的天然陷阱。
错误做法总结:切片按固定长度,不考虑语义边界;只用字面Embedding,不做关键词兜底;召回只看相似度分数,不看内容相关性。
第一,切片要"讲人话"。不要用固定字符,要用语义边界。比如按Markdown标题切、按段落切、甚至按句子组切。复杂一点的做法是滑动窗口切片,让相邻块之间有重叠,保证上下文连贯性。对于结构化文档,保留标题层级,做"父级摘要注入"——每个子块前面加上父标题的语义摘要。
第二,向量化要"双保险"。不要只把纯文本扔给Embedding模型。对于关键词敏感型查询,一定要配合Sparse Retrieval做混合检索。向量负责语义泛化,关键词负责精准匹配,两者做RRF融合,伪相关率能降一大截。
第三,召回结果要做"体检"。召回TopK后,加一层轻量级的重排序,比如Cross-Encoder。Cross-Encoder能看到查询和文档的交互特征,比双塔Embedding的相似度准得多。同时,设一个相似度阈值,低于阈值的直接过滤,别让他们混进上下文里污染生成。
看看修正后的效果:同样是问退款流程,语义切片保证了"流程步骤"和"特殊情况说明"在同一个块或邻近块里;Hybrid Search确保了含"退款"关键词的段落优先被召回;Reranker把真正相关的段落顶到了前面。大模型终于拿到了对的弹药,回答准确率自然就上去了。
小结: 上游检索是RAG的"水源",水源脏了,下游再怎么过滤都是徒劳。
三、生成侧幻觉:大模型的"脑补"比编剧还离谱
就算检索给了正确答案,大模型也不一定会"老实交代"。生成侧幻觉的本质,是模型在"已知"和"未知"之间没有一条清晰的边界。它会过度概括、会缝合矛盾信息、会为了回答流畅而凭空捏造细节。RAG里的生成侧幻觉,通常表现为三种形态:上下文无视型、过度推理型、冲突缝合型。
很多新手在Prompt工程上几乎不设防。System Prompt就一句"你是一个助手,请根据上下文回答问题"。这跟把羊扔进狼群说"你要乖"有什么区别?
我举个例子。某医疗知识库RAG,检索回来的上下文明确写了"药品X适用于症状A,禁忌人群为孕妇"。用户问"孕妇得了症状A能吃药品X吗?" 大模型回答:“药品X对症状A有良好疗效,孕妇可以在医生指导下使用。” 上下文明明说了禁忌,模型却为了"给出有用建议"而强行调和矛盾,把"禁忌"理解成了"谨慎使用"。这就是冲突缝合型幻觉。如果用户真听了,后果不堪设想。
还有一种常见错误:Temperature和Top-P设置过高。做RAG问答不是写诗,你不需要创意,你需要的是忠实。Temperature=0.7甚至0.9,模型每次回答都不一样,今天说"支持",明天说"不支持",你找Bug都找不到。
第一步,把Prompt当成"法律条文"来写。System Prompt里必须包含三大铁律:只能基于提供的上下文回答,上下文里没有的信息,明确回答"根据现有资料无法确认";如果上下文存在矛盾,优先采信最新或最权威的来源,并说明矛盾点;禁止编造细节,如果上下文提及,必须原文引用。
第二步,技术约束要做硬。Temperature拉到0.1以下,甚至0。RAG任务不需要采样多样性,需要的是确定性。开启JSON Mode或Structured Output,让模型按固定格式输出,比如包含answer、reasoning、certainty字段。certainty字段是神来之笔,模型自己报告置信度,低置信度的回答可以直接转人工审核。
第三步,引入溯源机制。要求模型在回答的每一个事实性陈述后面,标注来源文档的ID或片段编号。比如"年假为10天 [来源: 《2024员工手册》第3章]"。这不仅是用户体验的提升,更是幻觉检测的重要手段——如果模型标注的来源里根本没有这个数字,那它就是在编。
第四步,做"拒绝回答"的兜底。设置一个阈值,如果召回片段的相似度普遍偏低,或者Reranker打分都不过线,直接返回"暂未找到相关资料"都比胡说八道强。很多新手怕拒绝回答显得产品"不智能",但学长告诉你,一个会说"我不知道"的AI,远比一个瞎编乱造的AI更有商业价值。
小结: Prompt是缰绳,Temperature是油门,溯源是行车记录仪——三者缺一不可。
四、检测与缓解:给幻觉"拍CT"和"做手术"
说了这么多防御手段,但你总得知道"病好了没"吧?检测与缓解是RAG工业化的核心环节。它分两条战线:离线检测(上线前)和在线检测(上线后)。离线检测是体检,在线检测是ICU监护。
我见过最"原始"的评估方式,叫"老板评测法"——老板随机问几个问题,觉得"还行"就上线。这种项目在三个月内的幻觉投诉率几乎是100%。
还有一种错误:把"流畅度"当成"正确性"。团队里安排几个实习生读回答,觉得"语句通顺、像人话"就给过。但大模型编瞎话的时候,语气往往比说真话还笃定。你让非专业人员凭感觉判断,根本抓不住隐蔽的事实性错误。
技术层面的错误做法也很普遍。比如有人用简单的字符串匹配来判断模型回答是否在上下文里出现过。但模型会换词、会概括,"公司成立于2010年"和"该企业自2010年起开始运营"是一个意思,字符串匹配却会认为不匹配。这种检测等于没做。
离线检测三板斧:
第一板斧,NLI模型做事实校验。用一个小型的NLI模型或者开源的Fact-Checking模型,输入"上下文 + 模型回答",判断两者关系是蕴含、矛盾还是中立。矛盾率就是幻觉的近似指标。这种方法比字符串匹配聪明多了,能理解语义等价。
第二板斧,Self-Check或LLM-as-a-Judge。让另一个独立的LLM来审查答案。给它一个严格的Prompt:“请检查以下回答是否完全基于给定上下文,指出任何无依据的陈述。” 虽然LLM评判LLM听起来有点"左手监督右手",但在没有大量标注数据时,这是性价比最高的冷启动方案。
第三板斧,构建黄金测试集。准备100到500个标准问答对,覆盖高频场景和边界Case。每次迭代模型或调整Prompt后,跑一遍这个测试集,看准确率、幻觉率的变化。这是你的"回归测试",防止优化A指标时把B指标搞崩。
在线检测也不能少:
首先,规则过滤器做兜底。维护一个"敏感词+事实性词"的黑名单和白名单。比如医疗领域,回答里如果出现绝对化用语"100%治愈",直接拦截;金融领域,如果出现未在上下文出现的具体收益率数字,标记待审。
其次,语义漂移检测。把用户问题和模型回答也做Embedding,计算它们与召回上下文集合的语义一致性。如果回答的Embedding和上下文Embedding的聚类中心偏离太远,说明模型可能在"自由发挥"。
最后,用户反馈闭环。产品上一定要有"点赞/点踩"和"纠错"入口。点踩的数据要自动进低质样本池,每周人工Review一次。这些真实的负样本,是你优化RAG系统最宝贵的资产。
小结: 没有检测能力的RAG系统,就是蒙眼狂奔。只有能量化幻觉,才能根治幻觉。
五、评估体系:没有度量,就没有管理
检测是手段,评估体系是战略。RAG的评估不能只有一个"准确率",它是一个多层指标金字塔。很多新手面试时被问"你怎么评估RAG效果",只能憋出一句"看回答对不对",这说明你根本没有体系化思维。
第一个坑:只看生成指标,不看检索指标。团队花了大把时间调Prompt,结果发现是向量库根本没召回相关文档。如果你不把检索和生成解耦评估,就会陷入无尽的Prompt Engineering,却解决不了根本问题。
第二个坑:滥用传统NLP指标。有人拿BLEU、ROUGE来评RAG。这俩指标衡量的是文本重叠度,对于RAG这种"事实正确优先"的任务,基本没意义。模型回答"该功能需要升级专业版",标准答案是"请购买专业套餐以解锁此功能",BLEU得分很低,但意思完全正确。反过来,模型编造了一段看起来很像标准答案的话,BLEU可能很高,但事实是错的。
第三个坑:评估不自动化。每次评估都靠人工打分,效率低不说,标准还不一样。张三认为"勉强对"打3分,李四认为"完全错"打1分,数据根本没法纵向对比。
检索层指标——这是你的地基。
Context Recall或Hit Rate@K:正确答案能不能在Top-K召回结果里找到?这是最基本的"弹药是否充足"指标。
MRR:正确答案在召回结果里排第几?排第一和排第十,对后续生成的影响天差地别。
Context Precision:召回的K个片段里,有多少是真正相关的?过滤掉伪相关,能显著降低模型被噪声干扰的概率。
生成层指标——这是你的核心。
这里强烈推荐 RAGAS 框架。它定义了几个专门面向RAG的指标,而且支持自动化打分:
Faithfulness(忠实度):答案里的每一个陈述,能不能在上下文里找到依据?这是直接衡量幻觉的核心指标。RAGAS会用NLI或LLM自动拆解答案中的Claim,逐一验证。
Answer Relevance(答案相关性):答案有没有答非所问?即使内容忠实于上下文,但如果和问题不匹配,也是坏回答。
Context Precision与Recall:在检索评估的基础上,进一步看生成模块是否有效利用了这些上下文。
端到端与业务层指标——这是你的北极星。
技术指标再好,最终也要落到业务上:
人工抽检通过率:每周随机抽N条,业务专家盲审,看事实错误率。这个最准,但成本最高。
用户满意度:对话结束后的一星到五星评价。
纠错率或回话率:用户是否因为答案错误而重新提问或转人工?
任务完成率:比如客服RAG,用户是否在没有转人工的情况下解决了问题?
正确的评估流程应该是:离线阶段用RAGAS加黄金测试集做自动化评估,快速迭代;上线前做一轮人工评估,设定基线;上线后监控业务指标,异常时触发检索日志分析;每月做一次全量指标Review,看Faithfulness趋势、MRR趋势、用户满意度相关性。
这样做的好处是,当你面试时被问到"你们怎么评估RAG",你可以从容不迫地说:“我们分三层,检索层看MRR和Context Precision,生成层用RAGAS的Faithfulness指标做自动化评估,业务层跟踪用户满意度和纠错率。上线后Faithfulness从0.72提升到了0.89,客服转人工率下降了15%。” 面试官听完,心里只会想:这人我要了。
小结: 指标是你的北极星。选错指标,优化方向就会南辕北辙。
六、面试实战:把项目经历变成你的"护城河"
前面五节都是"内功",但面试是"比武",你得会把内功展示出来。RAG幻觉和评估这个主题,在面试里通常以三种形式出现:八股概念题、项目深挖题、场景设计题。很多同学死在"知道但不会说"上。
最经典的死法是这样的。面试官问:“你在项目里怎么解决幻觉问题的?” 你回答:“我用了RAG,把文档向量化存进Milvus,然后检索相关片段给大模型生成。” 面试官追问:“那如果检索回来的片段本身就不对呢?” 你愣住了:“额……我们会换更好的Embedding模型……” 然后就没有然后了。
这个回答的问题在于:第一,你把RAG当成了答案本身,而不是一个需要优化的系统;第二,你没有体现出问题排查的链路思维;第三,你没有量化结果,全是定性描述。
还有一种错误:背诵名词。一开口就是"Self-RAG"、“CRAG”、“Corrective RAG”,面试官问你"你们当时为什么没选CRAG",你答不上来。名词是武器,但你得知道什么时候拔哪把剑。
第一,回答项目题,用STAR法则,但必须加"技术纵深"。
Situation:不要只说"我做了一个智能客服"。要说"我们承接了某金融客户的智能客服项目,领域知识更新频繁,监管对回答准确性要求极高,幻觉容忍度接近零。"
Task:不要只说"我负责RAG模块"。要说"我负责RAG系统的幻觉治理与效果评估,目标是线上事实错误率低于2%,同时保证回答覆盖率不低于95%。"
Action:这是重头戏,要体现"分层治理"思维。
检索层:“我发现固定长度切片会导致表格和条款语义断裂,于是改成了基于Markdown标题的层次化切片,并引入父级摘要注入。召回侧做了BM25加Dense Vector的Hybrid Search,用Cross-Encoder Reranker做精排,Top3的相关性提升了40%。”
生成层:“Prompt里强约束了’仅基于上下文回答’和’不知道就拒绝’的策略。Temperature设为0.1,并强制模型输出引用来源。对于金融数值类问题,加了正则校验,确保出现的数字都能在上下文中找到。”
评估层:“离线用RAGAS框架做Faithfulness自动化评测,构建了300条黄金测试集。线上埋点了用户反馈和回答溯源校验,每周出幻觉率报告。”
Result:一定要量化。“迭代两个月后,RAGAS Faithfulness从0.68提升到0.91,线上用户点踩率下降了60%,客服转人工率从35%降到12%。”
第二,回答概念题,讲"因果链"而不是"名词解释"。
比如问"什么是Self-RAG?" 不要背定义。要说:“传统RAG是一次性检索完就生成,容易把噪声也生成出来。Self-RAG的核心是在生成的每一个Step里,让模型自我判断’我现在需不需要检索’、‘检索回来的内容有没有用’、‘我应不应该把这个内容采纳进回答’。它本质上是用模型的反思能力做动态检索决策,适合多跳问答场景。但我们项目当时没采用,因为推理成本太高,而且我们的知识库相对静态,用离线预检索加精排就已经能满足需求。”
这个回答的妙处在于:你不仅懂原理,还懂Trade-off,还结合了项目实际情况。这才是高级工程师的思考方式。
第三,回答场景设计题,体现"兜底意识"。
面试官问:“如果让你从0设计一个医疗问诊RAG,你怎么保证不产生幻觉?”
你要分层回答:
知识层:“医疗知识库必须经过执业医师审核,版本化管理,禁止用未经证实的网络文档。”
检索层:“召回阈值要做硬性截断,低于阈值的直接触发’建议您咨询专业医生’,不进入生成环节。”
生成层:“Prompt里要加入医疗免责声明,禁止模型给出诊断结论,只能基于教材做知识解释。输出必须带溯源。”
评估层:“上线前用黄金测试集做压力测试,邀请医生做盲审。上线后A/B Test,任何回答涉及药物推荐必须过审。”
兜底:“最后一道防线是人工复核队列,高风险的回答不进用户端,先进医生审核后台。”
这种回答滴水不漏,因为它体现了工程化思维:没有100%的系统,只有层层兜底的风险控制。
小结: 面试不是考背诵,是考你解决问题的"肌肉记忆"和"工程分寸感"。
写在最后
学到这里,你应该发现了,RAG的幻觉治理从来都不是一个"Silver Bullet"能解决的问题。它像是一场持久战,从文档入库的那一刀切片开始,到向量空间里的每一次相似度计算,到Prompt里的每一个约束词,再到评估报表上的每一个小数点,你都要守住关口。
很多新手觉得这些很繁琐,总想找一个"最强模型"或者"最优雅架构"来一劳永逸。但学长想告诉你,工业级的AI应用,恰恰就是由这些"繁琐"的工程和度量堆起来的。能把幻觉率从10%降到1%的人,靠的不是运气,而是对每一个Bad Case的耐心拆解,和对每一层指标的敬畏。
面试场上,当其他候选人还在背"RAG是检索增强生成"这种课本定义时,你已经能清晰地说出"我们的检索层用Hybrid Search解决伪相关,生成层用引用溯源和拒绝回答做兜底,评估层用RAGAS做Faithfulness自动化评测,最终把业务指标提升了XX%"——这就是你的护城河。
编程之路不易,RAG之路更是遍地暗坑。但每一步扎实的优化都算数,每一个被修复的Bad Case都在为你的履历加分。保持好奇,保持对细节的敏感,持续学习,你不仅能通过这次面试,更能在未来的AI工程浪潮里,成为一个真正靠得住的开发者。
加油,我们下期再见!
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:2026 年多模态大模型实战训练营》
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 3
 0
- 0


 已为社区贡献209条内容

所有评论(0)