
【大模型RAG生成式AI开发实战】《大模型RAG生成式AI开发实战》_234.[第24章 面试与职业发展] RAG面试高频题:切块策略和嵌入选型
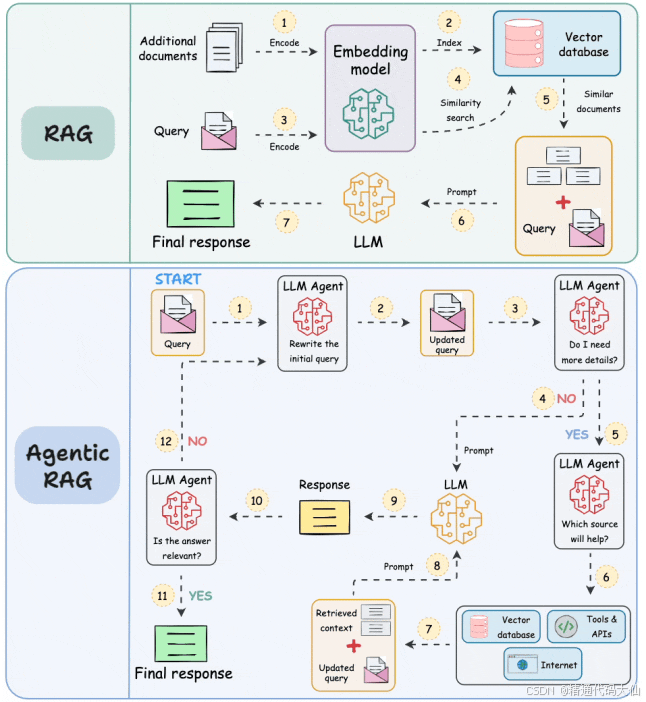
从“一刀切”到“量体裁衣”:一篇吃透RAG切块与嵌入的面试夺命连环问,让你在面试官面前不再“向量裸奔”!全文将用大白话拆解五大核心要点——从认知破局到切块选型,从嵌入模型对比到协同优化,再到面试实战杀手锏。读完这篇,你不仅能从容应对“文本怎么切”“模型怎么选”的灵魂拷问,更能讲出带有落地细节的调优故事,让面试官眼前一亮:这人是真干过,不是背八股。
文字目录
- 要点一:认知破局——面试官为啥死磕切块和嵌入这两个“基建”问题?
- 要点二:切块策略——别让“一刀切”毁了你的知识库
- 要点三:嵌入选型——从“唯OpenAI论”到“因地制宜”
- 要点四:协同优化——切块与嵌入的“君臣佐使”
- 要点五:面试杀手锏——从背八股到讲实战
- 写在最后
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《大模型RAG生成式AI开发实战》234.[第24章 面试与职业发展] RAG面试高频题:切块策略和嵌入选型
都说“面试造火箭,入职拧螺丝”,但在RAG这个领域,很多小伙伴连“螺丝”的螺纹规格都还没搞明白,就跑去跟面试官聊“火箭推进器”了。结果一聊到“你们文本怎么切的”“为什么选这个嵌入模型”,当场CPU占用率飙升,直接“宕机”。
你是不是也有这种感觉?跟着官方Quick Start跑了个Demo,把PDF往里一丢,向量库一插,问答似乎能跑了,就觉得自己掌握了RAG。可一旦深入到生产环境,面对格式混乱的真实文档、中英混杂的语料、专业领域的术语,瞬间就抓瞎了。别慌,今天咱们就把这两个“地基级”问题掰开了、揉碎了,讲清楚。
要点一:认知破局——面试官为啥死磕切块和嵌入这两个“基建”问题?
点题
很多新手对RAG的理解停留在“检索+生成”两个大字上,觉得核心是大模型本身。但其实,在真实的面试场景里,面试官最爱问的反而是:“你的文本切分策略是什么?”“嵌入模型怎么选的,维度多少,支持多长上下文?”
为啥?因为在大模型能力越来越趋同的今天,RAG的胜负手已经不在模型本身,而在“输入质量”。切分和嵌入,直接决定了你喂给大模型的上下文是不是“人话”,向量检索能不能召回真正相关的内容。这一块搞砸了,后面用再强的GPT-4也救不回来。
痛点分析
新手最容易掉的坑,就是**“API思维”**。觉得RAG = 向量数据库 + LLM API,中间那部分随便用个LangChain默认的CharacterTextSplitter就能搞定。
我见过太多这样的简历了:写“熟练搭建RAG应用”,一问细节,全是默认参数。
# 错误的“裸奔”示范
from langchain.text_splitter import CharacterTextSplitter

splitter = CharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=0
)
chunks = splitter.split_documents(docs)
这段代码跑Demo没问题,但上了生产环境就是灾难。比如一份技术文档里有一段Python代码,固定长度一刀切下去,def在第一块,return在第二块。用户问“这个函数怎么实现的”,检索召回的全是残肢断臂,LLM看了直摇头,只能开始“ hallucinate”(幻觉编造)。
还有个思维误区:“Chunk越小越精确”。于是有人疯狂把文本切成128、256字符。结果呢?单个Chunk确实精确了,但丢失了前后文的指代关系。比如前一句是“张三向李四借了五千元”,后一句是“他承诺月底归还”。你把这两句切开了,召回第二句的时候,LLM一脸懵:这个“他”到底是谁?
解决方案/正确做法
记住一句话:Garbage In, Garbage Out(垃圾进,垃圾出)。大模型再聪明,也吃不了馊饭。
你要建立的第一个正确认知是:切分和嵌入不是“预处理步骤”,而是RAG的“第一性原理”。它们共同决定了向量空间的质量。切分负责“语义完整性”,嵌入负责“语义表达能力”,两者缺一不可。
正确的起步姿势,是先理解你的数据,再动手切:
# 正确的认知落地:先观察,再切分
print(f"文档平均长度: {sum(len(d.page_content) for d in docs) / len(docs)}")
print(f"文档类型分布: {set(d.metadata.get('type') for d in docs)}")
拿到数据后,问自己三个问题:
- 我的文档是结构化(代码、Markdown、表格)还是非结构化(小说、聊天记录)?
- 用户提问的方式是精准检索(查定义)还是归纳总结(问主旨)?
- 我的嵌入模型最大支持多长的输入序列?
把这三个问题想明白了,你后面的选型才有根有据,而不是拍脑袋。
小结
面试官死磕这块,不是想刁难你,而是想看看你有没有“工程落地意识”。脱离数据谈切分,脱离场景谈模型,都是耍流氓。
要点二:切块策略——别让“一刀切”毁了你的知识库
点题
切块(Chunking)的策略五花八门,但面试高频考点主要集中在五大类:固定长度切分、递归字符切分、语义切分、结构化感知切分、Agentic动态切分。每一类都有自己的舒适区和雷区,关键是“看菜下饭”。
痛点分析
新手最容易犯的错,就是**“一招鲜,吃遍天”**。不管什么文档,上来就是固定长度1000字符,overlap给50,跑通了就行。
有个特别典型的Badcase。某同学做企业内部知识库,源文档是Confluence导出的Wiki页面,里面混着标题、表格、代码块。他用固定长度切完之后,一个Markdown表格被横着切成了三段。用户在检索时问“Q3的销售额是多少”,召回的Chunk里只有表格的中间几行,表头和Q3这一行天各一方。向量相似度算来算去,根本拼不出一张完整的表,LLM只能瞎猜。
还有人在处理法律合同的时候,把“甲方权利义务”和“乙方违约责任”切到了一个Chunk里,导致语义混杂。检索“乙方违约怎么办”时,因为向量相似度被“甲方权利”那部分稀释了,排名反而靠后,出现了**“该召回的没召回,不该召回的乱召回”**。
解决方案/正确做法
咱们逐个击破,给你一份“选型地图”。
1. 递归字符切分(RecursiveCharacterTextSplitter)
这是大部分长文本的“保底方案”。它不是一刀切,而是按标点层级递进:先按双换行(段落)切,段落太长再按单换行(句子)切,以此类推。
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=512,
    chunk_overlap=50,
    separators=["\n\n", "\n", "。", "!", "?", " ", ""]
)
chunks = splitter.split_documents(docs)
好处是天然尊重了文本边界,不会把一句话拦腰斩断。适合小说、论文、散文这类自然语言文本。
2. 结构化感知切分(MarkdownHeaderTextSplitter / CodeSplitter)
如果你面对的是Markdown、JSON、Python代码,千万别用通用文本切分器。LangChain提供了MarkdownHeaderTextSplitter,可以按#、##标题切,还能把标题作为元数据保留下来。
from langchain.text_splitter import MarkdownHeaderTextSplitter

headers_to_split_on = [("#", "Header 1"), ("##", "Header 2")]
splitter = MarkdownHeaderTextSplitter(headers_to_split_on=headers_to_split_on)
chunks = splitter.split_text(markdown_text)
代码同理,按函数、类、逻辑块切,保证每个Chunk都是自包含的语义单元。这样用户问“某个函数的实现”,召回的就是完整函数,而不是半拉子代码。
3. 语义切分(SemanticChunker)
它的核心思想是:先按句子切,然后对每句话做嵌入,计算相邻句子的语义相似度。相似度骤降的地方,就是语义边界。
from langchain_experimental.text_splitter import SemanticChunker
from langchain.embeddings import HuggingFaceEmbeddings

embeddings = HuggingFaceEmbeddings(model_name="BAAI/bge-small-zh")
splitter = SemanticChunker(embeddings, breakpoint_threshold_type="percentile")
chunks = splitter.split_documents(docs)
这种切分特别适合问答对、对话记录、逻辑跳跃较大的文本。缺点是计算成本高,需要预先嵌入一遍。面试时你可以说:“我在数据量不大且对质量要求极高的场景下,会采用语义切分作为补充策略。”
4. 表格特殊处理
对于表格,最佳实践是整表保留或者按行组(row group)切分。如果表格太大,可以按每5-10行一组,同时把表头复制到每一组的元数据里。千万别让表格出现“身首异处”的情况。
5. Agentic动态切分(进阶加分项)
如果面试想秀肌肉,可以提一嘴Agentic Chunking。简单说,就是让LLM先读一遍文档,自己决定在哪里下刀。成本高,但质量极优。你可以说:“我在对质量极度敏感、预算充足的场景下,会考虑用LLM辅助做语义边界的判定。”
小结
没有最好的切分策略,只有最合适的切分策略。 面试时别只背名字,要讲清楚“什么场景用什么,为什么,以及你遇到过什么坑”。
要点三:嵌入选型——从“唯OpenAI论”到“因地制宜”
点题
嵌入模型(Embedding Model)是RAG的“语义翻译官”。面试高频的选型维度包括:语言适配性、向量维度、支持序列长度、领域泛化能力、是否可微调、开源vs商用。
痛点分析
很多新手一提嵌入模型,脑子里只有text-embedding-ada-002或者text-embedding-3-small。这本身没错,OpenAI的模型确实很强,但面试时如果你只认识这一个,面试官会默认你对开源生态完全不了解,“深度不够”。
更致命的是“语言错配”。有同学做中文医疗问答,图省事直接上了英文优化为主的嵌入模型。结果“糖尿病”和“高血压”的向量算出来相似度不高,反而“糖尿病”和“尿毒症”因为共享了一些英文医学词根而被拉近。召回的结果简直是在拿患者的生命开玩笑。
还有个误区是**“维度越高越好”**。有人说“我选3072维的,信息量大”。但维度高意味着存储翻倍、检索变慢、内存爆炸。在百万级文档场景下,768维和3072维的索引构建时间可能差出好几倍。
解决方案/正确做法
给你一份面试时可以直接拿来用的“选型 checklist”。
1. 中文场景:BGE 系列是基线
BAAI/bge-large-zh-v1.5 是目前中文RAG的“安全牌”。它在C-MTEB上表现优异,支持512token,维度1024,开源可商用。
from langchain.embeddings import HuggingFaceEmbeddings

embeddings = HuggingFaceEmbeddings(
    model_name="BAAI/bge-large-zh-v1.5",
    model_kwargs={"device": "cuda"},
    encode_kwargs={"normalize_embeddings": True, "batch_size": 32}
)
注意要开启normalize_embeddings,这样向量模长为1,方便后续用余弦相似度。
2. 多语言/中英混杂:bge-m3 或 E5
如果你的语料中英混杂,或者需要跨语言检索(用中文问题搜英文文档),BAAI/bge-m3和intfloat/e5-mistral-7b-instruct是更好的选择。E5系列特别强的一点是它支持“指令式嵌入”(Instruct Embedding),你可以在输入前加一句指令,比如“Represent this sentence for searching relevant information:”,让模型知道你的任务意图。
3. 轻量级与资源受限:M3E 或 GTE-small
如果部署资源有限,比如要在CPU上跑,或者边缘设备上跑,别硬上 large 模型。moka-ai/m3e-base或者Alibaba-NLP/gte-base-zh是性价比极高的选择。面试时可以说:“我在资源受限的私有化部署场景,会在精度和性能之间做trade-off,选用轻量级模型并通过微调弥补差距。”
4. 领域微调:别迷信通用模型
通用模型在“法言法语”“医学术语”“金融黑话”上往往是门外汉。如果你的领域有积累的语料,一定要做领域微调(Domain Fine-tuning)。哪怕只是用领域内的相似句对做对比学习(Contrastive Learning),也能让相似度计算从“外行”变“内行”。
# 面试时描述你的微调思路即可,不需要现场写训练代码
# 核心逻辑:用领域内的 (query, positive_doc, negative_doc) 三元组
# 对基座模型做对比学习微调,让正样本拉近,负样本推远
5. 长文本嵌入:别忽视 max_length
很多嵌入模型默认只支持512 token。如果你的Chunk长度经常超过这个值,要么换模型(比如支持8192的),要么在切分阶段就做好长度控制。否则超出部分会被直接截断,信息丢失。
小结
嵌入模型的选型,本质是“在语言、领域、成本、性能”四个维度找平衡。 面试时展示你对开源模型的了解,比只说“我用OpenAI”要加分得多。
要点四:协同优化——切块与嵌入的“君臣佐使”
点题
切分和嵌入不是孤立的。Chunk Size 要和嵌入模型的 Max Length 对齐,Overlap 要照顾语义连贯性,元数据要辅助重排序。这一节咱们聊“协同”。
痛点分析
最常见的翻车现场是**“长度错配”**。比如 embedding 模型最大支持512 token,你Chunk Size设了2048。结果呢?文本被硬截断到512,后面1500多个字符的信息直接被丢了。用户问的问题如果答案在那1500字里面,你根本不可能召回。
还有一种痛叫**“重叠设为零”**。为了省存储、省计算,直接把chunk_overlap设成0。这会导致上下文完全断裂。比如一段技术文档:
“系统采用Redis作为缓存层。它通过TTL机制自动清理过期数据。”
你把这两句话切到两个Chunk里,且没有重叠。用户问“系统用什么做缓存”,召回第一句,没问题。但用户问“缓存怎么清理过期数据”,如果向量检索对“它”这个词理解不深,第二句可能因为缺少“Redis”这个关键词而相似度不足,导致漏召。
解决方案/正确做法
1. 长度对齐:Chunk Size ≤ Embedding Max Length - 预留
假设你的嵌入模型最大支持512个token。注意,是token,不是字符。1000个汉字可能等于700-800个token。所以 Chunk Size 建议控制在模型上限的80%-90%,留点余量给特殊token。
# 伪代码:对齐检查
max_tokens = 512
safe_chunk_size = int(max_tokens * 0.85)  # 留约435 token给内容

splitter = RecursiveCharacterTextSplitter(
    chunk_size=safe_chunk_size,  # 注意这里最终还要根据tokenizer校准
    chunk_overlap=50
)
面试时你可以说:“我会用模型的Tokenizer实际测算,而不是按字符数拍脑袋。”这句话一出,面试官就知道你是懂行的。
2. 合理重叠:给上下文留个“缓冲带”
Overlap 建议设置在 Chunk Size 的10%-20%。比如 Chunk Size 500,Overlap 给50-100。这样既能保证语义连贯,又不会让存储成本爆炸。如果你的Chunk非常小(比如128),Overlap比例可以适当提高到20%-30%。
3. 元数据保留:给Chunk发“身份证”
每个Chunk都应该携带丰富的元数据:源文件名、章节标题、页码、所属类别。这些元数据不参与向量相似度计算,但在重排序(Rerank)和过滤阶段极其有用。
# 正确的元数据实践
for chunk in chunks:
    chunk.metadata.update({
        "source": doc_name,
        "section": current_heading,
        "page": page_num,
        "doc_type": "technical_spec"
    })
面试时可以说:“我不仅会做向量召回,还会利用元数据做后置过滤。比如用户问财务问题,我先根据metadata里的doc_type过滤出财务文档,再在这个子集里做相似度检索,大幅提升准确率。”
4. 边界感知:别在实体和逻辑中间下刀
切分时尽量保证每个Chunk是“自包含”的。比如别把一个JSON对象切两半,别把一个函数切两半,别把一个人名切两半(“李”在上一块,“四”在下一块)。递归切分器的好处就是它会优先在标点处下刀,天然避免了这类尴尬。
小结
切分和嵌入,就像齿轮和链条,必须严丝合缝。 面试时能把“长度对齐、重叠策略、元数据增强”这三件事讲清楚,你已经超过了80%的候选人。
要点五:面试杀手锏——从背八股到讲实战
点题
前面四节是“知识储备”,这一节是“面试技巧”。面试官最终想听的不是你背了多少名词,而是**“遇到Badcase时,你的排查思路和优化路径”**。
痛点分析
很多小伙伴面试时的回答像百度百科:
“我使用了RAG技术,先对文档进行切分,然后向量化存入FAISS,最后用LangChain做检索和生成。”
面试官一听,模板化回答,毫无信息量。于是追问:
“你Chunk Size怎么定的?” “做过消融实验吗?” “Badcase怎么分析的?” “召回率和精确率怎么平衡的?”
然后你就开始“嗯…这个…我们后来加了个重排序…”。再问用的什么重排序模型,和Cross-Encoder什么区别,答不上来。空气突然安静。
解决方案/正确做法
给你一套**“场景-痛点-方案-收益”**的回答框架,直接套用。
1. 回答框架:STAR法则的RAG版
- Scene(场景):我们做的是企业内部法律文档问答,涉及大量中英文合同、法条引用。
- Task(任务):用户提问口语化,但文档高度书面化,存在严重的“表述Gap”。
- Action(行动):
- 切分阶段:放弃固定长度,采用
MarkdownHeaderTextSplitter保留条款层级,Chunk Size控制在384 token以匹配嵌入模型; - 嵌入阶段:基座选用
bge-large-zh,用法条内的“相似问答对”做领域微调; - 召回阶段:向量召回Top10 + BM25关键词召回Top10,合并去重;
- 精排阶段:用
bge-reranker-large做Cross-Encoder重排,取Top3送入LLM。
- 切分阶段:放弃固定长度,采用
- Result(收益):召回准确率从62%提升到89%,LLM幻觉率明显下降。
这套组合拳一打出来,面试官基本就认定你**“有工程经验”**了。
2. 调参Checklist(面试时展示系统性)
你可以说:“我通常会用控制变量法做消融实验。”
| 实验维度 | 测试值 | 观察指标 |
|---|---|---|
| Chunk Size | 256 / 512 / 1024 | 召回率、上下文完整性 |
| Overlap | 0 / 50 / 100 | 跨块语义连贯性 |
| 召回TopK | 5 / 10 / 20 | 命中率 vs 噪音率 |
| Rerank TopN | 3 / 5 | LLM输入长度与精度平衡 |
3. Badcase分析三板斧
面试时主动提你会分析Badcase,绝对是加分项。
- 漏召:该召回的没回来。通常是因为切分切断了关键语义,或者嵌入模型对领域术语理解不到位。解决:优化切分边界、做领域微调。
- 误召:召回的内容不相关。通常是因为Chunk太大,语义混杂;或者向量相似度被表面词汇欺骗(比如“苹果”公司 vs “苹果”水果)。解决:缩小Chunk Size、加元数据过滤、引入Reranker。
- 排序靠后:相关内容召回来了,但排在第8、第9位,被TopK截断了。解决:增大TopK先做召回,再用Reranker精排;或者调整向量索引的度量方式(余弦 vs 欧氏 vs 点积)。
4. 高级加分项(谨慎提及,确保你真懂)
- HyDE(假设文档嵌入):让LLM先根据问题生成一个“假答案”,再用假答案去检索。适合用户问题极短、语义模糊的场景。
- 多向量表示(ColBERT):不只用一个向量代表整个Chunk,而是保留token级别的细粒度交互。适合对精准匹配要求极高的场景。
- 稀疏向量(Splade)+ 稠密向量混合:稠密向量管语义,稀疏向量管关键词字面匹配,两者互补。
提这些的时候,一定要带上你的判断:“我用HyDE是因为用户问题太模糊,直接检索效果差;但如果延迟要求很高,我会权衡是否值得。” 这种**“有取舍”**的表达,比单纯堆名词更有说服力。
小结
面试不是期末考试,不需要你写出完美答案,而是要证明你有“解决未知问题的能力”。 把调参过程、Badcase分析、技术取舍讲出来,比背一百个名词都管用。
写在最后
聊到这里,关于RAG面试中“切块策略和嵌入选型”的核心考点,咱们就基本盘明白了。其实回过头来看,面试官问这些,无非是想确认两件事:第一,你知不知道“输入质量决定输出上限”;第二,你在真遇到问题时,有没有系统性的排查和优化思路。
这条路确实不容易。你可能要面对格式混乱的文档,要调参调到怀疑人生,要在精度、成本、延迟之间反复横跳。但每一次Badcase的分析,每一次消融实验的对比,都会让你对RAG的理解深一层。
编程之路不易,但每一步成长都算数。保持好奇,持续学习,别怕犯错,你也能从“只会调API”成长为“能扛生产RAG系统”的靠谱工程师。面试只是职业生涯里的一小站,拿下它,前面还有更广阔的天地等着你。
加油,咱们下篇见!
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:2026 年多模态大模型实战训练营》
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 9
 0
- 0


 已为社区贡献209条内容

所有评论(0)