
【大模型RAG生成式AI开发实战】《大模型RAG生成式AI开发实战》_233.[第24章 面试与职业发展] RAG面试高频题:向量检索原理和优化
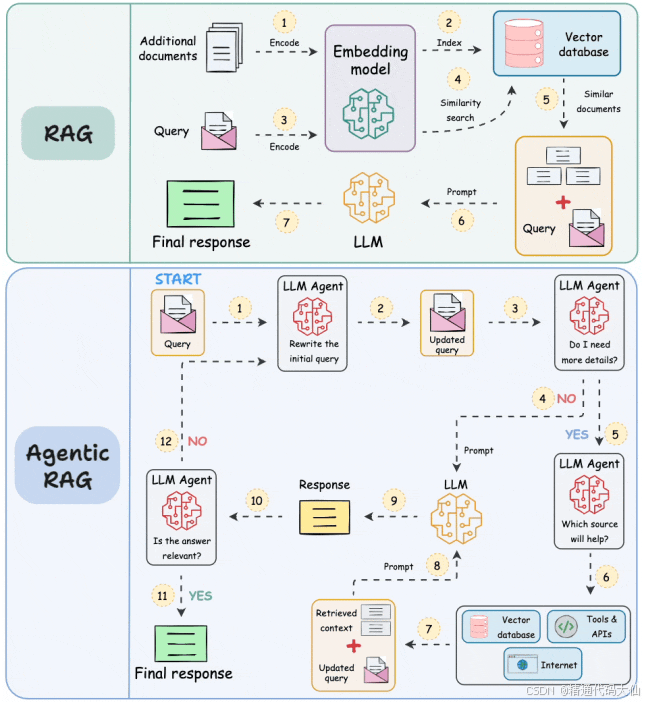
从"调包侠"到"原理党":一文打通RAG向量检索的面试任督二脉,让面试官听完直呼"这候选人我要了"!全文将用七大实战模块,带你扒开向量检索的底层实现、索引选型、Embedding陷阱、混合检索、重排序精排、工程化调优以及面试反杀技巧。读完这篇,你不仅能扛住面试官的连环追问,更能回到工程里真正做出高性能、高召回的RAG系统。咱们不玩虚的,直接上硬菜。
全文导航:
一、向量检索底层原理:从Embedding到ANN
二、索引结构深度解析:HNSW与IVF的生死抉择
三、Embedding模型:决定检索天花板的隐形杀手
四、混合检索:关键词与向量的双剑合璧
五、重排序与结果精排:召回后的临门一脚
六、工程化性能优化:量化、分片与延迟之战
七、面试高频陷阱与答题框架:反杀面试官的套路
写在最后
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《大模型RAG生成式AI开发实战》233.[第24章 面试与职业发展] RAG面试高频题:向量检索原理和优化。
都说"基础不牢,地动山摇"。这句话放在RAG面试里,那真是血淋淋的真理。你有没有发现,简历上只要写了"熟悉RAG架构、向量数据库",面试官的眼睛就会亮起来,接着连环三问:“向量检索为什么快?”“HNSW和IVF怎么选?”"Embedding模型你们怎么优化的?"这时候,如果你只停留在"调包"层面,当场就会CPU干烧,恨不得找个地缝钻进去。别急,今天学长就带你把这层窗户纸捅破,咱们从原理到工程,从焦虑到希望,一次性把向量检索的面试高频考点嚼碎了喂给你。
一、向量检索底层原理:从Embedding到ANN
点题。向量检索的本质,是把人类能理解的文本、图片、音频,通过Embedding模型压缩成一串固定长度的浮点数,也就是向量。这些向量生活在高维空间里,语义相近的内容,在空间里距离就近。我们要做的,就是在这个高维空间里,快速找到离查询向量最近的那一批邻居。这里的关键词是"快速"——因为如果做暴力穷搜,时间复杂度是O(N),数据量一上来直接凉凉。所以业界引入了ANN,Approximate Nearest Neighbor,近似最近邻搜索。它牺牲了一点点精度,换取了指数级的速度提升。
但很多同学对"距离"的理解非常模糊。面试里经常问:余弦相似度、欧氏距离、点积,三者到底什么关系?什么时候用哪个?
痛点分析。新手最容易踩的坑,就是对着Python代码死记硬背cosine_similarity(a, b),却根本不知道背后的几何意义。面试官稍微变个形:“如果向量已经做了L2归一化,余弦相似度和欧氏距离是什么关系?” 当场懵圈。还有些同学觉得"距离度量随便选一个就行",结果在推荐场景里用欧氏距离,把用户偏好向量的模长差异也惩罚了,导致推荐结果跑偏。
更隐蔽的误区是忽视"维度灾难"。有些同学以为向量维度越高,携带的信息就越多,检索效果一定越好。但高维空间里,向量之间的距离分布会变得非常集中,所有点都像是挤在一个 Thin Shell 里,区分度反而下降。如果你连这个都没概念,面试官只要问一句"为什么768维有时候不如384维",你就只能尬笑了。
解决方案。先建立几何直觉:余弦相似度看的是两个向量的夹角,只管方向不管长度,非常适合文本语义匹配。欧氏距离看的是绝对位置,适合对向量模长有敏感要求的场景,比如图像特征。点积则是模长乘以余弦相似度,所以它会受向量长度影响。一旦你做了L2归一化,所有向量都躺在了单位球面上,这时候余弦相似度和点积完全等价,而欧氏距离的平方等于2 - 2 * cosine_similarity。面试时能把这条公式随手写出来,面试官心里会给你加十分。
对于ANN的理解,不要只背名词。你要讲得出它的Trade-off:召回率(Recall)和查询延迟(Latency)之间的平衡。暴力搜索是100%召回但最慢;ANN通过空间划分(如KD-Tree)、局部敏感哈希(LSH)、图索引(HNSW)、乘积量化(PQ)等手段,把搜索空间剪掉一大半。面试时如果你能画个草图,说明"数据怎么被组织成索引结构、查询时怎么跳过无关区域",这就已经不是背八股了,这是工程思维。
小结:向量检索不是魔法,它是高维空间里的几何游戏。搞懂距离度量的本质和ANN的取舍逻辑,是你面试时展示深度的第一张王牌。
二、索引结构深度解析:HNSW与IVF的生死抉择
点题。有了向量,怎么组织它们才能查得快?目前工业界最主流的两大利器,一个是基于图的HNSW(Hierarchical Navigable Small World),另一个是基于聚类的IVF(Inverted File Index)。HNSW像是一张高速公路网,节点之间有多层 shortcut,查询时从顶层贪心导航,层层往下钻。IVF则像是先给向量按地理位置划分成很多个区县(聚类中心),查询时只去最相关的几个区县里找。
痛点分析。我见过太多同学在这个环节"唯新论",觉得HNSW是最新最潮的算法,遇事不决就上HNSW。结果在超大规模数据集上,内存直接爆炸,服务半夜OOM。反过来,也有同学在小数据集(比如几十万条)上硬套IVF,建索引时聚类开销比搜索节省的时间还多,得不偿失。
参数调优更是重灾区。HNSW里的M(邻居数)和efConstruction(构建时搜索深度),IVF里的nlist(聚类数)和nprobe(查询时搜索的聚类数),很多人完全是拍脑袋设值。面试官问:“你的HNSW的M为什么设16?如果改成64会怎样?” 如果你答"试试看的",气势上就输了。M决定了图的连通性和内存占用,越大图越稠密、召回越高、内存越炸;efConstruction决定了构建质量,越高建索引越慢,但查询时的底层图质量越好。
还有更惨的:有些场景需要带过滤条件的向量检索(比如只查最近7天的文档)。HNSW的图结构一旦加了强过滤,跳转逻辑会被打断,性能可能断崖式下跌。如果你面试时没提到这一点,面试官就知道你没在真实业务里踩过坑。
解决方案。选型要遵循数据量法则。单机内存够、数据量在百万级以内,HNSW通常是首选,因为它实现简单、召回率高、不需要训练。但如果你面对的是亿级甚至十亿级向量,或者你运行在资源受限的嵌入式环境,IVF-PQ(倒排+乘积量化)才是内存友好的老大哥。
面试时给出一个清晰的决策矩阵:
- 数据量 < 100万,延迟要求 < 10ms:选 Flat(暴力)或 HNSW。
- 数据量 100万 - 1亿,内存吃紧:选 IVF-PQ 或 HNSW + Scalar Quantization。
- 数据量 > 1亿,需要分布式:考虑基于 IVF 的分片方案,或者 Milvus、Zilliz 这类分布式向量数据库。
参数设置要讲得出道理。比如nlist通常设为sqrt(N),nprobe在精度和延迟之间试探,面试时常说"我会在离线测试集上通过Grid Search找到满足Recall@99 > 95%的最小nprobe"。这句话一出来,专业感直接拉满。
小结:索引没有银弹。HNSW是内存换速度,IVF是精度换空间。面试时展现你能根据数据规模、硬件预算、延迟要求做理性选型,比单纯背算法公式更能打动人。
三、Embedding模型:决定检索天花板的隐形杀手
点题。很多同学把向量检索当成纯工程问题,疯狂地调索引、调参数,却忽略了最核心的原料——Embedding向量本身的质量。如果Embedding模型对你业务领域的语义理解不到位,后面的索引和重排序再花哨,也是在沙地上盖高楼。
痛点分析。第一个大坑叫"OpenAI迷信症"。一上来就是text-embedding-ada-002或text-embedding-3-small,觉得大厂出品必属精品。结果呢?做中文法律合同检索,“不可抗力"和"情势变更"在通用模型里可能贴得很近,但在法律语境下完全是两个概念。第二个坑是"维度迷信”,觉得1536维一定比768维厉害。实际上,如果模型本身对领域数据理解不深,多出来的维度只是在存储空气,白白浪费2倍内存和带宽。
第三个坑更隐蔽:不看上下文长度和截断策略。你把一篇2万字的论文直接丢进最大长度512的Embedding模型,后面的内容被截断了,检索时永远匹配不到论文后半部分的核心结论。还有些同学直接把用户Query和文档用同一个模型编码,却不知道有些模型对短句和长文的编码尺度并不一致,导致相似度计算失真。
解决方案。模型选型要讲得出门道。通用场景可以用OpenAI、BGE、GTE系列;中文垂类场景强烈推荐BGE-M3、Jina-Embeddings-v2、或者阿里云的通用文本向量。面试时提到"MTEB榜单"会加分,但更要强调"榜单只是参考,业务评测集才是金标准"。因为MTEB里的任务和你线上用户的真实分布,往往差着十万八千里。
维度选择要做实验。在业务评测集上,分别用384维、768维、1024维跑一遍Recall@K,如果768维和1536维差距不到1%,果断选768维。省下来的内存可以多存一倍文档,或者把索引放缓存里,查询延迟更低。
垂类优化一定要提微调(Fine-tuning)。用领域内的问答对、相似句对,做对比学习(Contrastive Learning)。比如anchor是用户问题,positive是标准答案文档,negative是难负例(看着相关但实际不对的文档)。微调后的模型,检索准确率通常能提升10%到30%。面试时讲一个你微调的具体案例,远比空谈理论更有说服力。
小结:Embedding是RAG的隐形天花板。索引只是放大器,模型才是信号源。信号源错了,放大器只会把噪声也放大。
四、混合检索:关键词与向量的双剑合璧
点题。纯向量检索很强,但它不是万能的。对于ID、版本号、产品型号、低频专业术语,向量检索经常"意会"失败。这时候,BM25这类基于关键词的传统检索,反而能精准命中。混合检索(Hybrid Search)就是把这两条路打通,语义相关交给向量,精确匹配交给关键词,最后用RRF(Reciprocal Rank Fusion)等算法把结果融合。
痛点分析。新手最容易犯的错,是"有了向量,忘了关键词"。面试时被问"你们系统怎么保证对专有名词的精确检索",如果只回答"我们用向量相似度",面试官就知道你没做过严肃的业务系统。还有同学虽然做了两路召回,但融合策略极其粗暴:把关键词Top-10和向量Top-10直接拼在一起,去重后丢给大模型。结果向量排第一的结果和关键词排第一的结果,谁该更靠前?完全没谱。
另一个误区是认为RRF里的参数k需要精心调参。其实k=60是社区验证的通用 sweet spot,它主要是用来削弱排名靠后的噪声,让两路结果公平竞技。如果你把k设成1,排名稍微波动一下,分数就会剧烈震荡。
解决方案。先讲清楚为什么需要混合检索。向量检索基于语义泛化,适合同义改写、上下文理解;但面对"Error Code 0x80070005"、"iPhone 15 Pro Max 256GB 白色"这种强精确匹配需求,BM25的 Term-based 匹配更可靠。在Elasticsearch、Milvus、Pinecone里,混合检索都已经是原生支持的功能。
融合策略要讲RRF公式:score = Σ 1 / (k + rank)。两路结果分别算分后求和,分高的胜出。面试时如果你能再提一嘴"还可以基于业务规则做加权融合,比如电商场景下关键词匹配标题的权重可以高于向量匹配描述",这就说明你不仅仅懂算法,还懂业务。
更高级的做法是稀疏向量(Sparse Embedding),比如Splade或BGE-M3的lexical权重。它把关键词匹配也编码成高维稀疏向量,和稠密向量一起存进向量数据库,统一用向量检索框架查询。这样既保留了精确匹配能力,又不需要维护两套索引系统。面试时提到这一点,属于降维打击。
小结:向量负责"意会",关键词负责"言传"。两手都要抓,两手都要硬。只会一路召回的RAG系统,在真实业务里走不远。
五、重排序与结果精排:召回后的临门一脚
点题。向量检索第一阶段返回的Top-K,通常叫"召回"(Recall)。但召回的结果只是"看起来相关",未必是"最相关"。这时候需要二阶段的重排序(Rerank)来做精细化排序。核心武器是Cross-Encoder,也叫交叉编码器。它把Query和候选文档拼接在一起,送进Transformer做交互式注意力计算,得出的相关性分数比双塔模型(Bi-Encoder)准得多。
痛点分析。Bi-Encoder是大多数向量检索的底层架构。Query和Document各自独立编码成单一向量,然后算相似度。这种"先压缩再交互"的模式,天然存在信息瓶颈。一个768维的向量,要承载整篇文档的语义,很多细节必然被平均掉了。结果就是,召回的10篇文档都含有关键词,但哪一篇真正回答了用户问题,Bi-Encoder根本分不清。
很多同学不知道这个瓶颈,面试时把向量检索的Top-5直接送给大模型当上下文,导致大模型引用了次优甚至错误的段落,最终生成"幻觉"答案。还有一种极端,是听说Cross-Encoder很准,就直接在线上对百万文档做全量精排。后果?单次查询延迟从50ms飙升到5秒,用户当场流失。
解决方案。标准的工业界做法是"双塔召回 + 交叉编码精排"的两阶段流水线。第一阶段Bi-Encoder快速召回Top-100甚至Top-200,把搜索空间从百万级压到百级;第二阶段用轻量级的Cross-Encoder(比如bge-reranker系列)对这100个候选精排,选出最优质的Top-5或Top-10送给LLM。这样延迟可控,精度大幅提升。
如果延迟还是敏感,可以了解ColBERT这类Late Interaction方案。它把文档端的细粒度向量预存下来,查询时只做轻量级的交互,比Cross-Encoder快1到2个数量级,精度介于Bi-Encoder和Cross-Encoder之间。面试时提到这个,说明你关注过前沿的折中方案。
还要学会"动态截断"。不是每次都要精排固定数量的候选。可以根据分数分布做阈值截断,或者先用Cross-Encoder筛掉明显不相关的,只保留高分段再做进一步处理。这样又能省一笔计算开销。
小结:召回是广度,精排是深度。只做召回不做精排的RAG,就像只买菜不洗菜,吃是能吃的,但容易吃坏肚子。
六、工程化性能优化:量化、分片与延迟之战
点题。面试到最后,往往会落到工程实现上。原理说得头头是道,但线上Latency扛不住,一切都是空谈。向量检索的工程优化,核心围绕三件事:降低内存占用、减少计算量、缩短查询路径。对应的技术手段就是量化(Quantization)、分片(Sharding)和缓存(Caching)。
痛点分析。量化是第一颗雷。PQ(Product Quantization)听起来很美好,把原始向量切分成若干子空间,每个子空间用聚类中心ID代替。但参数m(子空间数)如果设得不合理,效果直接崩盘。我见过有同学把768维向量切成1个子空间,或者切成768个子空间,前者丢失所有局部结构,后者压缩率几乎为零。还有同学做了量化后,发现召回率从95%掉到60%,当场怀疑人生,却不知道通过增大nprobe或调整nbits就能部分挽回。
第二个坑是"遇事不决上分布式"。数据量才几百万,单台机器内存绰绰有余,非要搞成分布式集群,网络RPC开销反而把延迟拖高了。第三个坑是忽视元数据过滤(Metadata Filtering)。比如用户只想查"作者=张三且时间>2024年"的文档,结果系统先做了全量向量检索,再在内存里过滤,白白浪费大量算力。
解决方案。量化要讲得出细节。Scalar Quantization(SQ,标量量化)把FP32压缩成INT8,简单暴力,精度损失极小,通常能做到几乎无损且内存减半,是首选的"低风险"方案。PQ更适合对内存极度敏感的场景,子空间数m建议设为dim / 4到dim / 8之间,比如768维设96或192个子空间。面试时提到"我们在离线评测集上对比了SQ和PQ,最终选了SQ,因为PQ的Recall@10损失超过了业务容忍的2%阈值",这种有数据支撑的决策最能打动面试官。
分片策略要结合业务特征。可以按租户ID分片、按时间序分片、或者按哈希均匀分片。对于时序数据,按时间分片还能配合冷热分离,老数据走慢存储,新数据走SSD+内存缓存,成本直接砍半。
预过滤(Pre-filtering)一定要了解。现代向量数据库(如Milvus、Pinecone、Weaviate)支持把标量过滤条件下推到索引层,先做bitmap过滤,再在过滤后的短名单里做向量检索。这比"先向量后过滤"快一个数量级。
缓存策略也不能少。高频Query的向量结果可以缓存在Redis里;甚至Embedding向量本身,对于重复出现的Query,也可以跳过模型推理,直接读缓存。面试时说一句"我们把Top-1000热门Query的向量检索结果做了10分钟TTL缓存,P99延迟下降了40%",这就是实打实的工程经验。
小结:工程优化是道算术题,没有玄学,只有对精度、成本、延迟三角关系的精确拿捏。
七、面试高频陷阱与答题框架:反杀面试官的套路
点题。前面六条是知识储备,这一条是面试技巧。面试官问向量检索,往往不会直来直去,而是埋坑。掌握高频陷阱和答题框架,才能把你学过的知识精准地卖出去。
痛点分析。最常见的死法有三种。第一种是"绝对化陷阱"。面试官问:“HNSW能保证一定找到最近邻吗?” 如果你答"能",直接出局。ANN的核心就是Approximate,是概率性保证,不是确定性保证。只有Flat(暴力搜索)才能100%精确。
第二种是"概念混淆陷阱"。比如问:“HNSW和数据库索引里的B+树有什么区别?” 有些同学开始背B+树的节点分裂和平衡操作,完全没get到点。B+树做的是精确范围查找,依赖数据的偏序关系;HNSW做的是高维空间的近似最近邻,依赖图结构的贪婪导航。两者解决的压根不是一个问题。
第三种是"项目空洞陷阱"。面试官让你介绍做过的RAG项目,结果你只说"我用了Milvus做向量检索,效果挺好的"。没有数据、没有难点、没有Trade-off考量。这种回答在面试官耳朵里就是噪音。
解决方案。送你一套"原理+选型+优化+评估"的四维答题法。不管面试官怎么问,你都尝试往这个框架里套。
原理层:讲清楚Embedding怎么来的、ANN为什么快、距离度量怎么选。
选型层:讲数据规模、延迟要求、内存预算,推导你为什么选HNSW或IVF。
优化层:讲你是怎么从500ms优化到50ms的,是做了量化、分片、缓存,还是加了重排序。
评估层:讲清楚离线指标(Recall@K、MRR、NDCG)和在线指标(用户满意度、LLM生成幻觉率)怎么联动。
针对高频问题,准备几个杀手锏答案:
- “为什么余弦相似度适合文本?” -> 因为它消除了文档长度差异的影响,只看语义方向。
- “HNSW为什么快?” -> 因为它通过多层图结构实现了贪婪导航,平均时间复杂度接近O(log N)。
- “向量检索效果不好怎么排查?” -> 先看Embedding模型是否匹配领域,再看分块策略是否把答案切碎了,然后看索引参数,最后看重排序,而不是一上来就加机器。
项目介绍一定要用STAR法则。Situation(什么业务场景)、Task(你的目标是什么)、Action(你具体做了什么,为什么这么做)、Result(量化结果,检索准确率提升多少、延迟下降多少)。
小结:面试不是背诵,是展示你解决问题的思维链。知识是弹药,框架是枪法,两者结合才能百步穿杨。
写在最后
看到这里的你,已经很棒了。向量检索这个领域,说深很深,涉及到计算几何、机器学习、分布式系统;说浅也很浅,因为现在的开源工具已经把很多复杂性包起来了。但面试的本质,是筛选出那些"知其然更知其所以然"的人。面试官想要的,不是一个会调API的脚本小子,而是一个能在系统变慢时知道该看哪块、在效果变差时知道该从哪下手、在面对千万级数据时知道该选什么架构的工程师。
编程这条路,从来没有白走的路。你今天搞懂的HNSW分层原理、明天算清楚的PQ压缩率、后天调好的RRF融合参数,都会变成你简历上沉甸甸的底气。别害怕面试,它只是帮你把知识从"模糊的感觉"提炼成"清晰的表达"的一场修行。
保持好奇,持续动手,多在自己的项目里踩几脚真坑。你记住,每一次你被面试官问住的时刻,都是你下一次蜕变的前奏。加油,咱们山顶见!
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:2026 年多模态大模型实战训练营》
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 4
 0
- 0


 已为社区贡献209条内容

所有评论(0)