
【大模型RAG生成式AI开发实战】《大模型RAG生成式AI开发实战》_172.[第18章 生产环境部署] RAG系统架构设计:微服务和单体方案
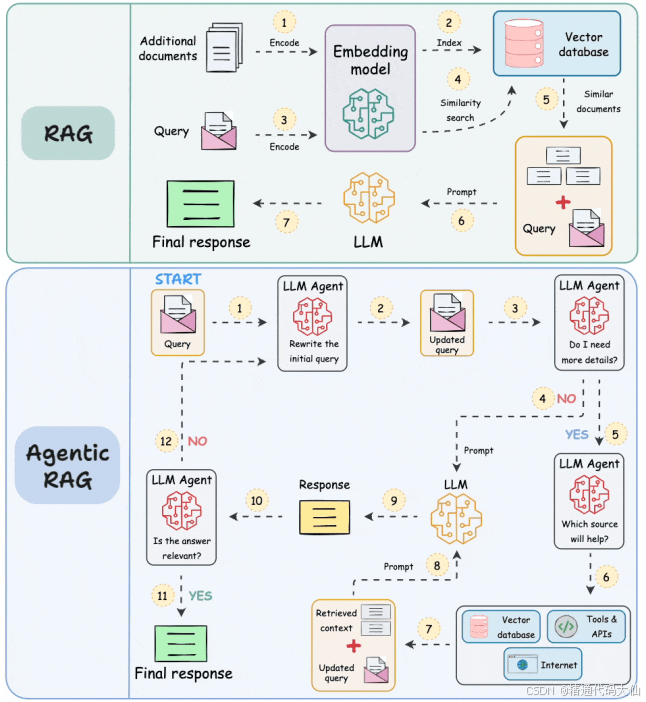
你的RAG Demo在笔记本上跑得飞起,一上生产环境就秒变“人工智障”?别急着把微服务当银弹,也别把单体架构当原罪——今天这篇,咱们就把RAG系统从“玩具”变“印钞机”的架构门道,掰开了揉碎了讲清楚。不管你是想把毕业设计熬成上线项目,还是为公司搭建企业知识库,这篇都是你的避坑指南。
文字目录
- 要点1:生产环境复杂度跃迁——你的Demo离上线还差十万八千里
- 要点2:单体架构的快稳省——模块化单体不是“低端”,是性价比之王
- 要点3:微服务拆分时机与策略——别让“拆”变成“拆东墙补西墙”
- 要点4:数据流与状态管理——RAG的血管和神经怎么搭
- 要点5:向量库与模型推理部署——别把GPU和CPU塞同一个饭盒
- 要点6:监控降级与演进路径——上线只是开始,活着才是胜利
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《大模型RAG生成式AI开发实战》172.[第18章 生产环境部署] RAG系统架构设计:微服务和单体方案。
俗话说,“饭要一口一口吃,代码要一行一行敲”。可在RAG这行当,我见过太多小伙伴,本地Jupyter Notebook里跑通了load_pdf -> split -> embed -> retrieve -> generate这五板斧,就觉得自己能 conquer 世界了。结果呢?一部署到生产环境,并发一上来,向量库锁死,LLM OOM,用户上传一个扫描版PDF直接让整个服务卡住三分钟。焦虑吗?太正常了。但好在,架构这事儿,只要有人提前给你把坑指出来,你就能少走半年弯路。今天,我就以“老学长”的身份,跟你聊聊RAG系统在生产环境里,到底该怎么选架构、怎么搭骨架。
要点1:生产环境复杂度跃迁——你的Demo离上线还差十万八千里
点题
咱们先泼一盆冷水。你在本地跑通的RAG,严格来说只能叫“技术验证”,离生产环境差了至少三个数量级。生产环境里有并发、有网络抖动、有千奇百怪的文档格式、有用户乱输入、有服务重启、有半夜告警。一个能扛住生产流量的RAG系统,至少得把下面这张网给织起来。
看见没?生产环境的RAG至少有两条主链路。一条是同步的查询链路(Query Path),用户提问,你要在几百毫秒内完成检索和生成;另一条是异步的数据链路(Ingestion Path),用户上传文档,解析、切片、向量化、入库,这玩意儿可能慢,但不能卡住主链路。很多新手一上来就把这两条路搅成一锅粥,不崩才怪。
痛点分析
新手最容易犯的毛病,我称之为“Demo思维”。怎么个意思呢?就是把所有东西塞进一个main.py,全局变量一摆,觉得“能跑就行”。来看一个我收过的真实“灾难代码”:
# 错误的示范:把所有东西塞在一个文件
@app.post("/chat")
def chat(file: UploadFile, question: str):
    loader = PyPDFLoader(file.file)  # 同步阻塞!主线程卡住
    docs = loader.load()
    vectorstore = Chroma.from_documents(docs, OpenAIEmbeddings())  # 内存里重复创建
    qa = RetrievalQA.from_chain_type(
        llm=ChatOpenAI(),
        retriever=vectorstore.as_retriever()
    )
    return qa.run(question)  # 第一个用户上传完,第二个用户只能干瞪眼
这段代码的问题,简直是“五毒俱全”。PDF解析是CPU密集型操作,直接阻塞主线程;向量库Chroma在内存里反复创建,并发一高内存直接爆炸;没有历史对话管理,没有错误兜底,没有超时控制。你把它扔到生产环境,不是上系统,是埋雷。
更可怕的是思维误区:“我先这样上线,后面再优化。” 兄弟,上线后再优化,往往意味着凌晨三点被老板打电话叫醒。生产环境的用户可不会等你“后面再说”。
解决方案/正确做法
第一步不是选微服务还是单体,而是画清边界。哪怕你最终用单体,也得把检索、生成、数据摄取这三个模块在代码层面拆开。
# 模块化单体的雏形:职责分离,接口清晰
retriever = RetrieverModule(db_url="...", embedder_url="...")
generator = GeneratorModule(llm_endpoint="...", timeout=10.0)
ingestion = IngestionWorker(queue=redis_queue)

@app.post("/upload")
async def upload(file: UploadFile):
    # 只接收文件,丢进队列就返回,绝不阻塞
    task_id = await ingestion.submit(file)
    return {"task_id": task_id, "status": "processing"}

@app.post("/chat")
async def chat(req: ChatRequest):
    # 同步链路保持轻量
    docs = await retriever.search(req.question, top_k=5)
    answer = await generator.generate(
        query=req.question,
        context=docs,
        history=req.session_id
    )
    return {"answer": answer}
看到区别了吗?上传和问答彻底解耦。问答链路里,检索和生成也是通过定义好的接口协作,而不是直接操作对方的内部状态。这样即使你后期要拆微服务,也是“无痛迁移”,把模块换成RPC调用就行。
小结
先认清生产环境的真面孔,你才知道手里该拿盾牌还是长矛。RAG不是简单的“LLM套壳”,它是一个涉及数据工程、模型推理、高并发查询的复合系统。
要点2:单体架构的快稳省——模块化单体不是“低端”,是性价比之王
点题
很多同学一提到“单体”,就觉得Low,觉得只有“微服务”才配得上自己“架构师”的身份。大错特错!单体架构,尤其是模块化单体(Modular Monolith),在RAG早期阶段往往是性价比最高的选择。它的核心思想是:代码层面高度模块化,部署层面暂时聚合在一个进程内。
痛点分析
我见过一个创业团队,三个人,日活不到五百,非要上来就搞Kubernetes + Istio + 六个微服务。结果呢?改一个接口字段,要同步改三四个仓库;本地调试起个Docker Compose要十分钟;链路追踪配了三天,业务代码没写几行。这就是典型的“拿着锤子找钉子”,砸到的是自己脚。
新手常有的错误想法是:“微服务才专业,单体就是菜鸡。” 于是硬把一个简单的RAG系统拆成“文档服务、向量化服务、检索服务、Prompt服务、LLM网关服务、历史会话服务”。调用链路长得能绕地球一圈,任何一个服务挂掉,整个链路就崩。图啥呢?
解决方案/正确做法
单体架构在以下场景下就是最优解:
- 团队规模小(小于10人)
- 日活/QPS可控(初期低于1000)
- 业务逻辑还在快速迭代,PMF(产品市场契合度)没跑通
正确姿势是代码模块化 + 进程内通信 + 后台任务队列。比如用FastAPI做主体,Celery + Redis处理异步的文档摄取。
# 模块化不代表一锅粥
# retriever.py
class Retriever:
    def __init__(self, vector_store):
        self.store = vector_store

    async def search(self, query: str, top_k: int = 5):
        return await self.store.similarity_search(query, k=top_k)

# generator.py
class Generator:
    def __init__(self, llm_client):
        self.llm = llm_client

    async def generate(self, query: str, docs: list, history: list):
        prompt = build_prompt(query, docs, history)
        return await self.llm.chat(prompt)

# main.py 只做组装,不做业务逻辑
app = FastAPI()
retriever = Retriever(milvus_client)
generator = Generator(openai_client)

@app.post("/chat")
async def chat(req: ChatRequest):
    docs = await retriever.search(req.question)
    answer = await generator.generate(req.question, docs, req.history)
    return {"answer": answer}
这样写的好处是啥?一是本地调试极快,一个IDE里就能跑完全链路;二是部署简单,一个Docker镜像 + 一个容器就能上线;三是当业务真的膨胀了,你把retriever.py整个包挪出去,改成gRPC服务,主工程几乎不用改。
小结
单体不是土,是没穿好衣服的金砖。先让业务跑起来、活下来,再考虑要不要为了扩展性而拆分。
要点3:微服务拆分时机与策略——别让“拆”变成“拆东墙补西墙”
点题
好,业务起来了,流量上来了,或者团队从3个人变成了30个人,单体确实扛不住了。这时候就该考虑微服务了。但微服务不是“把函数变成服务”那么简单,它拆的是业务能力,是组织协作的边界。
痛点分析
我见过最离谱的拆分方式,是按“技术层”拆:一个服务专门做Embedding,一个服务专门查向量库,一个服务专门做重排序,一个服务专门组装Prompt,一个服务专门调LLM。结果呢?用户问一个问题,系统内部串行发了五六个RPC请求,P99延迟直接飙到5秒以上。更惨的是,一旦Embedding服务网络抖动,整个检索链路全崩。
# 痛苦的微服务调用链(反模式)
async def chat(query):
    embedding = await embedding_service.encode(query)      # +200ms
    vectors = await vector_service.search(embedding)       # +100ms
    reranked = await rerank_service.rerank(query, vectors) # +300ms
    prompt = await prompt_service.build(query, reranked)   # +50ms
    answer = await llm_service.generate(prompt)            # +3000ms
    return answer  # 总延迟 > 3.6s,任何一个环节挂了全挂
这种拆法,我称之为“为了分布式而分布式”。你把一个本来内存里几纳秒就能完成的函数调用,硬改成了毫秒级的网络调用,还引入了序列化开销、超时风险、版本兼容性地狱。新手特别容易陷进这个坑,因为看起来“很架构”。
解决方案/正确做法
RAG系统合理的微服务边界,应该按业务能力和扩展频率来划分:
- Ingestion Service(数据摄取服务):负责文档解析、切片、向量化、入库。这是异步链路,容忍分钟级延迟,可以独立扩缩容。
- Retrieval Service(检索服务):负责接收Query、Embedding(如果模型小,建议内嵌)、向量检索、重排序。这是同步链路,要求低延迟,需要高并发。
- Generation Service(生成服务):负责Prompt管理、LLM调用、后处理。这是同步链路,但GPU资源昂贵,需要独立扩缩容。
关键点在于:减少同步RPC调用链。如果Embedding模型不大(比如BGE-small),直接内嵌在Retrieval Service里做Sidecar,别为了“解耦”而单独拆一个服务。
# 合理的内聚设计:检索服务内部闭环
class RetrievalService:
    def __init__(self):
        self.embedder = ONNXEmbedder()  # 本地加载,省RPC
        self.vector_db = MilvusClient()
        self.reranker = Reranker()

    async def retrieve(self, query: str):
        vec = self.embedder.encode(query)  # 本地推理,<50ms
        docs = self.vector_db.search(vec, top_k=50)
        return self.reranker.rerank(query, docs, top_k=5)
这样,一次用户请求,同步链路只需要调两个服务:Retrieval + Generation。Ingestion通过消息队列异步解耦,完全不影响查询性能。
小结
微服务拆的是团队,不是函数。别让架构复杂度超过你的组织复杂度,更别让一次简单的问答在网络里“周游世界”。
要点4:数据流与状态管理——RAG的血管和神经怎么搭
点题
RAG系统本质上玩的就是数据。文档怎么进系统?向量怎么更新?用户的多轮对话历史放哪?这些问题在Demo里你可以全放内存、全走同步,但在生产环境里,数据流设计直接决定了系统的生死。
痛点分析
新手最容易在这块栽两个跟头。
第一,把异步任务做成同步阻塞。 用户上传一个100页的扫描版PDF,你主线程里直接调用OCR解析,页面卡死30秒,Nginx直接返回504 Gateway Timeout。
# 错误:同步阻塞 + 状态存内存
chat_history = {}  # 重启即消失,而且不是线程安全的

@app.post("/upload")
def upload(file):
    docs = parse_pdf(file)      # 阻塞30秒!
    embed_and_store(docs)       # 再阻塞20秒
    return {"msg": "ok"}        # 前端早就超时了
第二,状态没有外部化。 用户聊了一半的对话历史存在Python的全局字典里,服务一重启,用户发现自己的“上下文”全没了,仿佛得了失忆症。如果你起了两个实例做负载均衡,更惨,用户这次请求打到A机器,下次打到B机器,历史记录对不上,体验直接裂开。
解决方案/正确做法
生产级的数据流必须做到异步解耦 + 状态外部化。
对于文档摄取,永远遵循“接收即返回,后台慢慢处理”的原则:
# 异步Ingestion:只负责接,不负责做
@app.post("/upload")
async def upload(file: UploadFile):
    url = await oss.upload(file)
    task_id = generate_uuid()
    await kafka.send("ingestion.topic", {
        "url": url,
        "filename": file.filename,
        "task_id": task_id
    })
    return {"status": "processing", "task_id": task_id}

# Worker端:慢操作全放这里
async def handle_ingestion(msg):
    docs = await parse(msg.url)       # OCR、表格识别,随便慢
    chunks = await split(docs)
    vectors = await embed(chunks)
    await vector_db.upsert(vectors, filename=msg.filename)
    await redis.set(f"task:{msg.task_id}", "done")
对于查询链路,必须做成无状态(Stateless)。任何需要跨请求保留的数据,全部丢给外部存储:
# 用Redis存多轮历史,支持分布式和无状态扩缩容
async def chat(session_id: str, question: str):
    history = await redis.get_json(f"chat:{session_id}")
    docs = await retriever.search(question)
    answer = await generator.generate(question, docs, history)

    # 更新历史
    history.append({"role": "user", "content": question})
    history.append({"role": "assistant", "content": answer})
    await redis.set_json(f"chat:{session_id}", history, expire=3600)
    return {"answer": answer}
这样做的好处是,你的Query服务可以随时重启、随时扩缩容,用户无感知。Redis挂了?顶多历史没了,但问答链路还能基于当前问题继续跑。
小结
把慢操作踢出主链路,把状态踢出进程内存。这是RAG系统从“玩具”走向“生产”的底线要求。
要点5:向量库与模型推理部署——别把GPU和CPU塞同一个饭盒
点题
RAG系统有两个“吃资源大户”:向量数据库和模型推理(Embedding + LLM)。很多新手为了“部署方便”,把它们和业务代码塞在一个容器里,结果启动慢、资源争抢、扩容困难。生产环境里,这些核心组件必须有独立的部署策略。
痛点分析
来看看经典的“巨无霸镜像”惨案:
# 错误:一个镜像想包打天下
FROM pytorch:2.0-cuda11.7
COPY . /app
RUN pip install transformers fastapi langchain chromadb ...
# 启动时要加载12B Embedding模型 + 70B LLM
# 镜像30GB,启动10分钟,一张A100显存直接OOM
CMD ["python", "app.py"]
这种部署方式的问题太多了。业务代码和模型推理混在一起,你改一行API接口逻辑,都要重新打包几十GB的镜像。更致命的是资源争抢:LLM推理把GPU显存占满了,Embedding模型连加载的地方都没有;或者向量库和业务服务抢内存,导致查询时内存不足被系统Kill。
还有一个隐藏大坑:用文件型向量库(比如Chroma文件模式、FAISS本地文件)做共享存储。多实例部署时,多个容器同时读写同一个文件索引,文件锁直接崩掉,数据一致性完蛋。
解决方案/正确做法
核心原则:让专业的组件做专业的事,让昂贵的资源用在刀刃上。
Embedding模型部署:
- 如果是轻量级模型(如BGE-small-zh),强烈建议导出为ONNX格式,用ONNX Runtime在CPU上推理。足够快,不占GPU。
- 如果是大模型,独立部署为一个轻量推理服务,供业务端通过HTTP/gRPC调用。
LLM推理部署:
- 必须用专用推理引擎,如vLLM、TGI、TensorRT-LLM。它们支持Continuous Batching、PageAttention等技术,能把GPU吞吐率提升数倍。
- 和业务代码完全分离,业务端只保留一个薄客户端:
# 业务代码只保留轻量客户端,绝不本地加载大模型
class LLMClient:
    def __init__(self):
        self.url = "http://llm-cluster:8000/generate"
        self.timeout = aiohttp.ClientTimeout(total=30)

    async def generate(self, prompt: str):
        async with aiohttp.ClientSession(timeout=self.timeout) as session:
            async with session.post(
                self.url,
                json={"prompt": prompt, "max_tokens": 1024}
            ) as resp:
                return await resp.json()
向量数据库部署:
- 生产环境请用云原生向量数据库:Milvus、Qdrant、Weaviate。它们支持分布式、多副本、分片、持久化备份。
- 配置长连接池,避免每次查询都新建连接:
# 向量库客户端长连接,避免每次创建开销
class VectorStore:
    def __init__(self):
        self.client = MilvusClient(
            uri="tcp://milvus-cluster:19530",
            pool="SingletonThread"
        )

    async def search(self, vector, top_k):
        return self.client.search(
            collection_name="docs",
            data=[vector],
            limit=top_k
        )
小结
让GPU专心干GPU该干的事,让业务服务专心做请求编排。混在一起,谁都吃不好,系统也长不大。
要点6:监控降级与演进路径——上线只是开始,活着才是胜利
点题
很多新手觉得,代码部署到服务器上,能访问了,就万事大吉。兄弟,这才刚刚开始。生产环境最大的确定性就是“不确定性”:网络会抖、磁盘会满、第三方API会超时、用户会问奇奇怪怪的问题。没有监控,你就是蒙眼开车;没有降级,你就是裸奔。
痛点分析
来看一个典型的“裸奔代码”:
# 裸奔上线,听天由命
@app.post("/chat")
async def chat(q: str):
    docs = vector_db.search(q)   # 网络抖动?直接500!
    answer = llm.generate(docs)  # 超时?前端干等!
    return {"answer": answer}
这段代码在生产环境会发生什么?向量库偶尔一次查询慢了两秒,用户看到白屏;LLM推理高峰期排队,请求堆积,内存打满,服务被OOM Killed;出了问题你也不知道是检索慢了、还是生成慢了、还是网络断了。老板问你“怎么回事”,你只能回答“我看看日志”——然后发现根本没打关键日志。
解决方案/正确做法
生产级RAG必须建立三层防护:监控指标体系 + 熔断降级策略 + 平滑演进路线。
第一层:监控指标
别只监控“CPU用了多少”,RAG要关注业务语义指标:
- 检索侧:Latency P50/P99、Recall@Top-K、向量库连接池使用率
- 生成侧:TTFT(Time To First Token)、TPOT(Time Per Output Token)、生成速率tokens/s
- 业务侧:对话轮次、用户点赞/点踩比例、降级触发次数、Ingestion队列堆积长度
这些数据是你调优的指南针。比如你发现检索P99很高,可能是向量库分片不足;TTFT超过2秒,可能需要给LLM集群加卡。
第二层:降级与熔断
别相信任何第三方组件或内部服务能100%稳定。代码里必须写“Plan B”:
# 有兜底的代码,才能睡得着觉
@app.post("/chat")
async def chat(q: str):
    docs = []
    # 检索兜底:超时或异常就空文档过
    try:
        docs = await asyncio.wait_for(retriever.search(q), timeout=1.5)
    except Exception as e:
        logger.error(f"检索失败,降级处理: {e}")
        # 触发告警,但服务继续

    # 生成兜底:LLM超时给友好提示
    try:
        answer = await asyncio.wait_for(
            generator.generate(q, docs),
            timeout=15.0
        )
        source = "retrieved" if docs else "general_knowledge"
    except asyncio.TimeoutError:
        logger.warning("LLM超时,返回降级响应")
        answer = "系统当前较忙,建议您稍后重试,或换个简短的问题试试~"
        source = "degraded"

    return {"answer": answer, "source": source}
关键思想:降级不是Bug,是特性。检索失败了,LLM基于通用知识回答,虽然可能不够精准,但总比抛一个500错误强。LLM超时了,给用户一个友好提示,比让用户对着白屏干等体验好一万倍。
第三层:平滑演进路线
架构不要想着一步到位。我推荐的演进路径是:
- 阶段一:模块化单体(团队<10人,跑通业务)
- 阶段二:API网关 + 独立数据层(前端解耦,数据层独立)
- 阶段三:Ingestion服务独立(异步链路拆分,释放主服务压力)
- 阶段四:检索与生成独立部署(按需扩缩容,检索加机器,生成加GPU)
- 阶段五:服务网格与治理(团队>50人,真正需要时再说)
每一步都等到上一个阶段的瓶颈真实出现,再进入下一个阶段。别为了“五年后的流量”提前付出五年的维护成本。
小结
好的架构是演进出来的,不是设计出来的。先让它能活,再让它跑得快,最后才让它跑得帅。
写在最后
聊到这里,相信你对RAG系统在生产环境的架构设计,心里已经有了一杆秤。微服务和单体从来不是非黑即白的选择题,而是不同阶段、不同团队、不同流量下的权衡艺术。单体可以让你快速验证想法,微服务可以让你支撑千万用户,但前提是——你知道自己现在在哪个阶段,该打哪张牌。
编程之路不易,架构之路更难。但每一次你躲过了一个坑,每一次你在凌晨三点没有被告警叫醒,那都是成长的印记。保持好奇,持续学习,先让系统活下来,再让它活得好。你走的每一步,都算数。
加油吧,未来的架构师!咱们下回见。
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:2026 年多模态大模型实战训练营》
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》
AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 4
 0
- 0


 已为社区贡献209条内容

所有评论(0)