
【大模型RAG生成式AI开发实战】《大模型RAG生成式AI开发实战》_175.[第18章 生产环境部署] Kubernetes部署:自动扩缩容和高可用
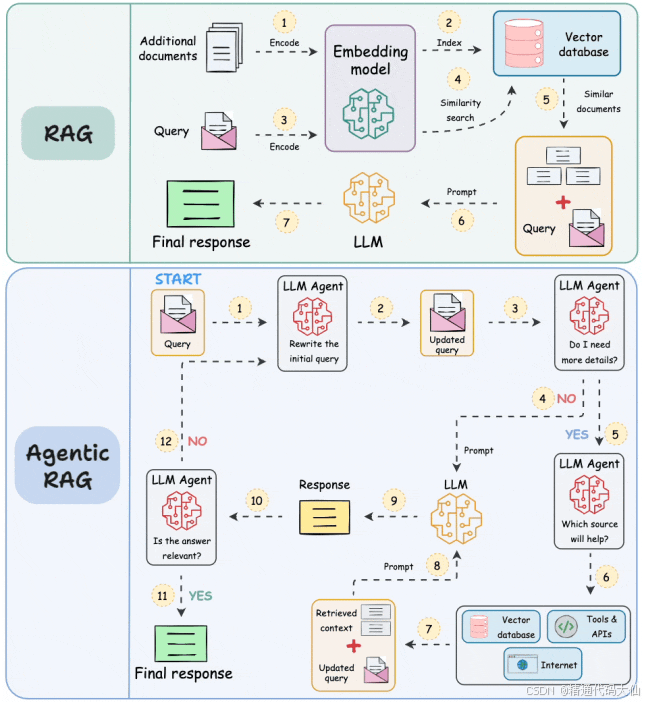
你的RAG服务还在“单机裸奔”?K8s自动扩缩容+高可用,才是生产环境的“保命符”!从本地Jupyter到生产集群,大模型RAG系统面临的从来不只是“能不能跑通”,而是“流量来了会不会崩”、“半夜节点挂了谁顶着”、“推理卡了要不要人工扩容”。全文将围绕K8s资源规划、HPA/VPA弹性伸缩、高可用架构、健康探针自愈、KEDA事件驱动这六大核心战场,手把手教你把RAG系统稳稳地“焊”在Kubernetes上,让它既能扛住流量洪峰,又能在故障时自动满血复活,彻底告别“半夜被告警惊醒”的噩梦。
文字目录:
-
- 资源规划与LimitRange:别让RAG成为“内存黑洞”
-
- HPA水平自动扩缩容:从“单机抗雷”到“弹性伸缩”
-
- VPA垂直扩缩容优化:治好“资源分配强迫症”
-
- 高可用架构设计:反亲和、多可用区与优雅关闭
-
- 健康探针与自愈机制:K8s的“自动回血”秘籍
-
- KEDA事件驱动扩缩容:RAG异步管道的“智能油门”
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《大模型RAG生成式AI开发实战》175.[第18章 生产环境部署] Kubernetes部署:自动扩缩容和高可用
都说“写代码一时爽,生产环境火葬场”。咱们做RAG应用的同学,本地用Docker Compose跑得好好的,向量库也能查,大模型也能答,感觉自己就是AI架构本构。结果一到生产环境,K8s一上,流量一上来,不是OOM杀 Pod,就是节点挂了全平台“失联”,半夜两点被老板电话惊醒的时候,才后悔没早点把自动扩缩容和高可用这俩“保命技能”点满。别怕,今天大仙就带你把这六个关键点一个个掰碎了讲清楚,看完这篇,你的RAG服务就能从“玻璃大炮”进化成“不死小强”。
1. 资源规划与LimitRange:别让RAG成为“内存黑洞”
点题
大模型RAG系统天生就是“资源饕餮”。Embedding模型要占显存,向量检索服务(比如Milvus、Weaviate)要吃内存,LLM推理更是个无底洞。在K8s里,如果你连资源规划都没做明白,那后面所有的自动扩缩容都是空中楼阁。
痛点分析
我见过太多新手同学,写Deployment的时候,resources字段直接留空,或者干脆复制粘贴一段limits写得巨高的配置,心里想着“我给足资源总没错吧”。结果要么因为不写requests,K8s调度器把Pod丢到一个本来就很挤的节点上,推理时内存暴涨,触发节点的OOM Killer,连自己带邻居一起“带走”;要么把limits.memory设成64Gi,但集群节点才32G,Pod死活调度不上去,Deployment一直在Pending,急得抓耳挠腮。
最典型的一个错误配置长这样:
# 错误示范:裸奔式资源定义
resources:
  limits:
    memory: "64Gi"
    cpu: "16"
  requests:
    memory: "64Gi"  # 请求也拉满,调度灾难
    cpu: "16"
这么写的后果是啥?你的RAG推理Pod成了一个“资源恶霸”,一个节点只能塞得下它一个,万一这个节点挂了,你的服务直接原地升天。而且HPA扩容的时候,也因为节点资源不足而扩不上去,流量来了只能干瞪眼。
解决方案/正确做法
资源规划的核心就一句话:requests决定调度,limits决定上限,两者要拉开差距,还要配LimitRange兜底。
对于RAG这种重内存应用,我的建议是:
- requests按“保底值”设:比如你的Embedding服务平时稳态占4G内存,那就设
requests.memory: "4Gi"。 - limits按“峰值缓冲”设:上限可以给到8G或12G,防止偶发大请求导致OOM。
- 用LimitRange给Namespace定规矩:防止团队里某个小伙伴手滑写了个离谱的配置。
# 正确示范:合理的资源配比
resources:
  requests:
    memory: "4Gi"
    cpu: "1000m"
  limits:
    memory: "8Gi"
    cpu: "2000m"
再配一个LimitRange,给整个Namespace上道保险:
apiVersion: v1
kind: LimitRange
metadata:
  name: rag-resource-limits
spec:
  limits:
  - default:
      memory: "8Gi"
      cpu: "2000m"
    defaultRequest:
      memory: "2Gi"
      cpu: "500m"
    type: Container
这样做的好处是,即使你偶尔漏写了resources,K8s也会自动注入默认值,不会让你的Pod裸奔。同时,合理的requests让调度器能更均匀地分布Pod,避免节点资源碎片化。你的RAG服务终于有了第一层“安全气囊”。
小结
资源规划不是浪费,而是投资。Requests和Limits设得好,你的RAG集群才能既不怕资源争抢,又能高效调度,后续扩缩容才有资源buffer可用。
2. HPA水平自动扩缩容:从“单机抗雷”到“弹性伸缩”
点题
Horizontal Pod Autoscaler(HPA)是K8s弹性伸缩的“基本功”。它的作用是根据CPU、内存或自定义指标,自动增加或减少Pod副本数。对于RAG系统来说,用户查询量往往是波动的,早上没人,晚上暴增,HPA就是帮你省钱的“智能管家”。
痛点分析
然而,很多新手对HPA的理解停留在“CPU超了80%就扩容”这个阶段。这对普通Web服务也许够用,但对RAG系统?坑大了!
大模型推理往往是内存和IO密集型,不是CPU密集型。用户一下子涌进来100个请求,你的RAG服务可能正在疯狂加载向量索引、等待LLM生成结果,CPU利用率可能才30%,但请求队列已经堵成一锅粥了。这时候如果你只配置了CPU指标的HPA,它会觉得“一切正常”,拒绝对外扩容。结果就是用户体验直线下降,超时报错满天飞。
另一个经典误区是缩容太快。有些同学配了HPA,发现流量下去后Pod瞬间被删掉,结果下一秒又来个波峰,系统又开始“抖动式”扩缩,Pod还没完全启动就又被关掉,形成“闪崩”。
错误的HPA配置通常长这样:
# 错误示范:只看CPU,且没有稳定窗口
spec:
  scaleTargetRef:
    name: rag-api
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 80
解决方案/正确做法
RAG服务的HPA,一定要引入自定义指标,并且把缩容策略放慢。
首先,你需要在集群里装上Metrics Server(基础指标)和Prometheus Adapter(自定义指标)。然后,针对RAG的特点,把“请求队列长度”、“P95推理延迟”或者“每秒查询数(QPS)”作为扩容依据,这些比CPU更能反映真实负载。
# 正确示范:多指标+行为控制
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: rag-api
  minReplicas: 3
  maxReplicas: 50
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
  - type: Pods
    pods:
      metric:
        name: rag_request_queue_length
      target:
        type: AverageValue
        averageValue: "10"
  behavior:
    scaleDown:
      stabilizationWindowSeconds: 300  # 缩容前先看5分钟,避免抖动
      policies:
      - type: Percent
        value: 10
        periodSeconds: 60
    scaleUp:
      stabilizationWindowSeconds: 0
      policies:
      - type: Percent
        value: 100
        periodSeconds: 15
这里的关键是behavior字段。scaleDown的稳定窗口设成300秒,意思是即使负载降了,K8s也会观察5分钟再决定缩容,防止“刚缩就扩”的抖动。扩容则保持灵敏,0秒延迟,快速响应流量。
这样做,你的RAG服务就像装上了“智能油门”,流量来了自动加足马力,流量走了也不会立刻熄火,稳稳当当。
小结
HPA不是只能看CPU。对RAG而言,自定义指标才是真正的扩容晴雨表。配好扩缩容行为策略,才能让弹性伸缩既灵敏又稳重。
3. VPA垂直扩缩容优化:治好“资源分配强迫症”
点题
Vertical Pod Autoscaler(VPA)解决的是另一个维度的问题:单个Pod到底该分配多少资源?有些场景下,水平扩容到顶了(比如单副本必须加载一个10GB的Embedding模型),或者你的RAG服务就是无法横向拆分,这时候就需要VPA来“加量不加碗”——垂直调整单个Pod的CPU和内存。
痛点分析
新手最容易踩的坑,就是把HPA和VPA的Auto模式同时打开。你想啊,HPA觉得负载高了,正在吭哧吭哧创建新Pod;VPA觉得现有Pod资源不够,又把老Pod的资源限制调高,甚至直接重启Pod去换资源配置。两边一打架,你的RAG服务就陷入了“无限重启”的恐怖循环。用户刚连上一个Pod,啪,重启了,请求直接断开。
还有一个误区是,以为VPA能像云服务器一样在线热升级。醒醒,K8s里VPA调整资源是要重建Pod的!如果你的RAG推理一个请求跑5分钟,VPA突然重启Pod,那正在生成的答案就全丢了。
下面这个配置,就是典型的“自杀式”用法:
# 错误示范:HPA与VPA Auto混用
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: rag-hpa
spec:
  scaleTargetRef:
    name: rag-llm
---
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: rag-vpa
spec:
  targetRef:
    name: rag-llm
  updatePolicy:
    updateMode: "Auto"  # 灾难现场!
解决方案/正确做法
对于生产环境的RAG系统,尤其是LLM推理这类“重单实例”服务,VPA的正确打开方式是**“建议模式(Off)”或“初始模式(Initial)”**,而不是全自动模式。
Off模式:VPA只分析历史资源 usage,给你推荐一个合理的request/limit值,但不自动修改。你可以根据建议手动调整Deployment,选择一个低峰期发布。
Initial模式:只在Pod创建时注入推荐的资源值,运行期间不再干预,避免运行中重启。
# 正确示范:VPA仅提供建议
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: rag-llm-vpa
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: rag-llm
  updatePolicy:
    updateMode: "Off"  # 只看建议,不动生产Pod
  resourcePolicy:
    containerPolicies:
    - containerName: llm-container
      minAllowed:
        memory: "8Gi"
        cpu: "1000m"
      maxAllowed:
        memory: "64Gi"
        cpu: "8000m"
      controlledResources: ["cpu", "memory"]
同时,如果你确实需要VPA和HPA共存,那必须错开作用域:比如HPA管API网关层(无状态,易水平扩展),VPA管底层的LLM推理Deployment(单实例重载,只给建议)。千万别让它们同时盯着一个Deployment“左右互搏”。
这样做的好处是,你既能获得数据驱动的资源优化建议,又能保住生产环境的稳定性。毕竟,RAG服务的连续性比那点资源优化重要得多。
小结
VPA是精细调优的工具,不是自动化的“万能钥匙”。生产环境用Off模式获取建议,配合手动发布,才是RAG大模型服务的稳妥之道。
4. 高可用架构设计:反亲和、多可用区与优雅关闭
点题
高可用不是喊口号,是实打实的架构设计。你的RAG服务就算有10个副本,如果这10个副本全跑在同一台物理机上,那这台机子一重启,你的服务照样“团灭”。高可用的核心就是把鸡蛋放进不同的篮子里,而且篮子还得在不同的房间里。
痛点分析
很多新手在写Deployment时,完全忽略affinity和topologySpreadConstraints这两个字段。K8s的默认调度策略是“能跑就行”,它不会主动帮你把Pod均匀分散到不同节点或不同可用区。结果呢?你的三个RAG副本全落在node-1上,node-1磁盘一坏,服务直接不可用。
另一个被严重低估的坑是优雅关闭(Graceful Shutdown)。RAG的大模型生成请求可能耗时很长,一个回答还没生成完,K8s收到节点维护信号,直接给Pod发SIGKILL,默认 grace period 只有30秒。30秒对大模型来说,有时候模型还没加载完呢!请求直接断开,用户体验断崖式下跌。
错误的配置就是“什么都不配”:
# 错误示范:无任何高可用与优雅关闭配置
spec:
  replicas: 3
  template:
    spec:
      containers:
      - name: rag-api
        image: rag:v1.0
      # 没有 affinity
      # 没有 topologySpreadConstraints
      # 默认 terminationGracePeriodSeconds: 30
解决方案/正确做法
首先,给Pod加上反亲和性(Pod Anti-Affinity),确保同一个服务的副本不会挤在同一台节点上。
# 正确示范:反亲和+跨可用区分布
spec:
  affinity:
    podAntiAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 100
        podAffinityTerm:
          labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values: ["rag-api"]
          topologyKey: kubernetes.io/hostname
  topologySpreadConstraints:
  - maxSkew: 1
    topologyKey: topology.kubernetes.io/zone
    whenUnsatisfiable: ScheduleAnyway
    labelSelector:
      matchLabels:
        app: rag-api
这里podAntiAffinity告诉调度器:尽量别把标签为app=rag-api的Pod放在同一个节点上。topologySpreadConstraints则进一步要求:在可用区(zone)之间尽量均匀分布,最大偏差为1。
其次,优雅关闭必须拉长时间。RAG推理不是简单的HTTP echo,给足时间让它处理完手头请求。
spec:
  terminationGracePeriodSeconds: 300  # 给5分钟收尾
  containers:
  - name: rag-api
    image: rag:v1.0
    lifecycle:
      preStop:
        exec:
          command: ["/bin/sh", "-c", "sleep 10"]  # 先等10秒,让Service摘除Endpoint
同时,你的应用程序代码里要监听SIGTERM信号,收到后停止接受新请求,但把当前正在生成的回答跑完再退出。K8s发SIGTERM后,等300秒如果还没停,才会发SIGKILL。这个时间对于绝大多数RAG生成任务来说,足够了。
别忘了再配上PodDisruptionBudget(PDB),保证在节点维护或升级时,始终有最小数量的Pod对外服务:
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: rag-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: rag-api
这套组合拳打下来,即使某个可用区整个失联,或者某台物理机半夜重启,你的RAG服务依然能对外稳稳输出结果。
小结
高可用不是堆副本数,而是让副本“散得开、死得起、关得掉”。反亲和+跨区分布+优雅关闭+PDB,才是RAG服务在K8s里安身立命的根本。
5. 健康探针与自愈机制:K8s的“自动回血”秘籍
点题
Liveness、Readiness、Startup Probe,这三个探针是K8s判断Pod“是死是活、能不能接客”的唯一标准。对于RAG系统来说,探针配置得好,K8s就是你的“自动回血挂”;配置得不好,它就是“定时炸弹”。
痛点分析
RAG服务有一个巨大的特点:启动慢。加载一个7B参数的模型到显存或内存里,少则几十秒,多则几分钟。新手同学往往只配一个livenessProbe,initialDelaySeconds设个10秒,periodSeconds设个5秒。结果呢?模型还没加载完,K8s就认为这个Pod“挂了”,开始疯狂重启。重启了又要重新加载模型,于是再次超时,再次重启,进入“重启地狱”。
还有一种错误,是把Readiness和Liveness配成完全一样的指标。比如都用/health接口。问题是,当RAG服务因为向量库短暂失联而“忙不过来”时,Readiness失败,把Pod从Service摘出去是对的;但Liveness也失败,直接把Pod杀了,这就过了。这时候服务本身没挂,只是暂时不想接新流量,杀Pod反而加重了恢复负担。
典型错误配置:
# 错误示范:探针太激进,且缺少Startup Probe
livenessProbe:
  httpGet:
    path: /health
    port: 8080
  initialDelaySeconds: 10
  periodSeconds: 5
readinessProbe:
  httpGet:
    path: /health
    port: 8080
  initialDelaySeconds: 10
  periodSeconds: 5
解决方案/正确做法
对于RAG这种“启动慢、运行重”的服务,Startup Probe是必选项。它的存在就是为了给Pod足够的启动时间,避免在初始化阶段被Liveness误杀。
# 正确示范:分层探针配置
startupProbe:
  httpGet:
    path: /health/startup
    port: 8080
  failureThreshold: 30   # 允许失败30次
  periodSeconds: 10      # 总共给5分钟启动时间
  timeoutSeconds: 5

readinessProbe:
  httpGet:
    path: /health/ready
    port: 8080
  initialDelaySeconds: 5
  periodSeconds: 10
  failureThreshold: 3

livenessProbe:
  httpGet:
    path: /health/live
    port: 8080
  initialDelaySeconds: 10
  periodSeconds: 15
  failureThreshold: 3
这里的关键是分层:
- Startup Probe:只在大模型加载、向量库连接初始化时起作用。连续30次失败(即5分钟)后才会重启,给足冷启动时间。
- Readiness Probe:检测“我能不能处理请求”。比如检测向量库连通性、模型是否加载完成。失败只意味着从Service摘流量,不杀Pod。
- Liveness Probe:检测“我是不是已经死透了”。指标要保守,比如只要HTTP服务还能响应就认为活着,避免在推理高负载时误杀。
你的应用程序里,这三个端点也要分开实现:
# 伪代码示意
@app.get("/health/startup")
def startup():
    if model_loaded and vector_db_connected:
        return {"status": "ok"}
    raise HTTPException(status_code=503)

@app.get("/health/ready")
def ready():
    if vector_db.is_connected() and request_queue.qsize() < 100:
        return {"status": "ok"}
    raise HTTPException(status_code=503)

@app.get("/health/live")
def live():
    # 只要进程没死就行
    return {"status": "ok"}
这样配置后,K8s就能精准判断RAG服务的状态:启动时耐心等,忙不过来时先摘流量,真正死了才重启。你的服务就像有了“自愈因子”,小伤自己恢复,重伤才动手术。
小结
探针不是越多越好,而是要“各司其职”。Startup给足耐心,Readiness判断能力,Liveness守住底线,RAG服务才能在K8s里真正“自动回血”。
6. KEDA事件驱动扩缩容:RAG异步管道的“智能油门”
点题
HPA和VPA虽然好用,但它们更适合实时在线服务。RAG系统里还有大量的异步任务,比如用户上传PDF后的文档解析、切片、Embedding入库,这些任务通常走Kafka或RabbitMQ。这时候,**KEDA(Kubernetes Event-driven Autoscaling)**才是正解。它能根据队列长度、消息堆积量等事件指标来扩容,比HPA更精准、更及时。
痛点分析
新手处理异步任务时,往往直接给Worker Deployment设一个固定的副本数,比如3个。白天文档上传少,3个Pod空转浪费资源;晚上批量导入任务来了,3个Pod消化不了,Kafka消息堆积如山,用户等半小时还没检索到新文档。
也有人想用HPA来解决,给Worker配个CPU指标。但异步消费任务的CPU利用率本来就不高,大部分时间都在等IO(调Embedding接口、写向量库)。CPU可能一直很低,HPA觉得“不需要扩容”,但消息队列已经爆了。这就是指标错配的典型悲剧。
错误思路长这样:
# 错误示范:用HPA管理异步消费者
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: rag-worker-hpa
spec:
  scaleTargetRef:
    name: embedding-worker
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 50
解决方案/正确做法
对于这种场景,直接上KEDA。它通过ScaledObject资源,把消息队列的Lag转换成扩容信号。
假设你的RAG系统用Kafka做文档解析队列:
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: rag-embedding-keda
spec:
  scaleTargetRef:
    name: embedding-worker
  pollingInterval: 10
  cooldownPeriod: 60
  minReplicaCount: 1    # 没任务时保留1个,快速响应
  maxReplicaCount: 50   # 峰值最多50个
  triggers:
  - type: kafka
    metadata:
      bootstrapServers: kafka-cluster:9092
      consumerGroup: rag-embedding-group
      topic: doc-ingestion
      lagThreshold: "50"  # 每个Partition堆积超过50条就扩容
      activationLagThreshold: "10"  # 低于10条缩容到min
这里lagThreshold: "50"的意思是:当Kafka每个Partition的未消费消息数超过50条时,KEDA就会自动增加Worker副本。消息消化完了,cooldownPeriod观察60秒后缩容到minReplicaCount。
你还可以基于Prometheus指标来触发,比如直接监控“待处理文档总数”:
  triggers:
  - type: prometheus
    metadata:
      serverAddress: http://prometheus:9090
      metricName: pending_documents_total
      threshold: "100"
      query: sum(pending_documents_total{job="rag-pipeline"})
KEDA的强大之处在于,它让RAG的异步管道真正实现了“按需分配”。没任务时只跑1个Pod省钱,任务堆积时秒级扩容到几十个Pod并行处理。而且缩容可以缩到0(如果你设minReplicaCount: 0),对于低频批处理任务,这能省下一大笔集群资源。
小结
HPA看的是“机器忙不忙”,KEDA看的是“活有多少”。RAG的异步流水线,用KEDA按事件扩容,才是把钱花在刀刃上的正确姿势。
写在最后
咱们搞技术的,最怕的不是代码写不出来,而是自认为“能跑就行”,结果在生产环境里被现实啪啪打脸。大模型RAG系统从Demo走向生产,Kubernetes不是简单地“把容器放进去”,而是要围绕资源、弹性、高可用、自愈这几个维度,搭建一套真正能扛事儿的工程体系。
今天咱们聊了资源规划怎么防止OOM惨案,HPA怎么根据业务指标弹性伸缩,VPA怎么在不动生产的前提下优化配置,高可用架构怎么让服务“散得开、死得起”,健康探针怎么让K8s精准“治病”,以及KEDA怎么让异步管道智能提速。这六个点,环环相扣,缺一不可。
你看,生产环境的K8s部署,说白了就是一场“防御性编程”。你提前把坑填了,半夜就能睡个安稳觉;你偷懒省一步,告警和老板的电话就会在凌晨三点如约而至。大仙我也是从“救火队员”一步步走过来的,深知那种手心冒汗查日志的滋味。所以,把这些配置和思路吃透,不仅是为了系统稳定,更是为了咱们自己的生活质量啊。
编程之路不易,但每一步扎实的成长都算数。K8s的水很深,RAG的坑很多,但只要你保持好奇,持续学习,把每一个生产环境问题都当成升级打怪的副本,你一定能成为那个团队里最靠谱的“架构兜底人”。别怕麻烦,动手去配吧,你的RAG服务值得被温柔以待!
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:2026 年多模态大模型实战训练营》
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 7
 0
- 0


 已为社区贡献209条内容

所有评论(0)