
【大模型RAG生成式AI开发实战】《大模型RAG生成式AI开发实战》_148.[第15章 向量数据库选型] FAISS本地方案:Meta开源的向量检索库
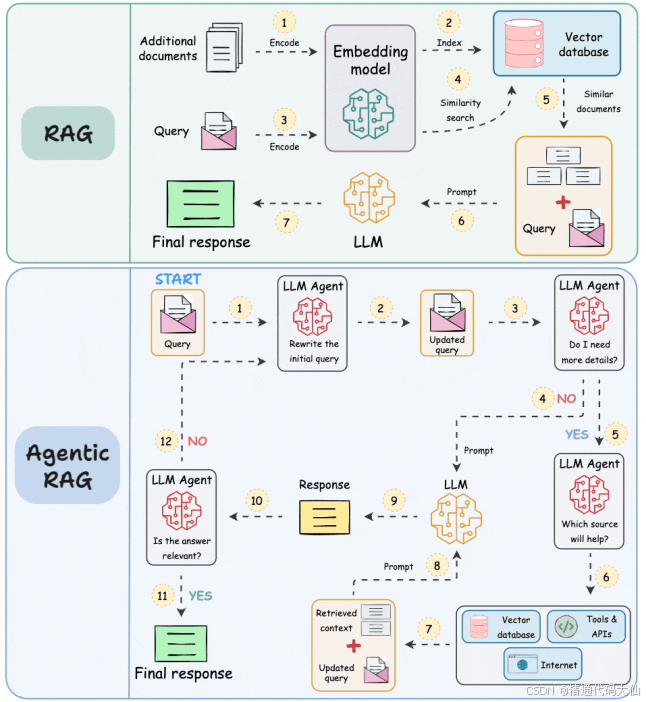
本地RAG性能天花板?Meta这把“屠龙刀”,90%的人却只当“水果刀”在耍!从安装踩坑到索引选型,从增量更新到内存优化,一篇说清FAISS在RAG实战里的正确打开方式。全文围绕FAISS本地方案展开,带你避开新手最容易踩的七个深坑,掌握从环境部署到工程落地的完整心法,让你的大模型RAG既快又稳。
目录
- 定位与核心原理:别把检索库当成数据库
- 安装与环境配置:CPU还是GPU?Conda还是Pip?
- 索引结构选型:Flat、IVF、HNSW、PQ到底怎么挑
- 数据管理与增量维护:ID映射和更新删除的坑
- 检索实战与调参:nprobe、距离度量与阈值过滤
- 持久化与内存优化:保存、加载与mmap黑科技
- RAG全流程集成:从文档切片到LLM Prompt的闭环
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《大模型RAG生成式AI开发实战》148.[第15章 向量数据库选型] FAISS本地方案:Meta开源的向量检索库。
“不吃学习的苦,就要吃踩坑的苦。” 这句话放在向量数据库选型上,简直再贴切不过了。很多兄弟刚上手大模型RAG项目,听别人说FAISS是Meta开源的神器,免费、本地跑、速度快,于是一头扎进去。结果呢?安装报错、索引选型一脸懵、数据删不掉、检索结果离谱,最后得出的结论竟然是“FAISS不好用”。兄弟,不是刀不快,是你握刀的姿势不对啊!这玩意儿用好了,本地RAG照样能飞起;用不好,那就是给自己埋雷。今天咱们就把这七个关键命门掰开揉碎讲清楚,保你少走三个月弯路。
1. 定位与核心原理:别把检索库当成数据库
点题
FAISS,全称 Facebook AI Similarity Search,现在跟着Meta混。它本质上是一个高维向量相似性搜索库,注意我说的是“库”(Library),不是“数据库”(Database)。它跑在你的Python进程里,和你写的业务代码共享内存,不需要网络连接,也没有独立的服务端进程。你可以把它理解成一个超级高效的“数组检索加速器”——你给它一堆向量,它帮你以极快的速度找出和查询向量最像的那几个。
在RAG的整个版图中,FAISS处于承上启下的位置。
痛点分析
新手最容易犯的毛病,就是拿着传统数据库的思维来套FAISS。总觉得“我装了个数据库,得有服务端口吧?得有用户权限吧?得能远程连接吧?” 抱歉,这些通通没有。FAISS就是一个.so或.pyd文件,被你import进来,创建一个Index对象,往里面add向量,然后search。
还有一个致命误区:以为FAISS只做“精确搜索”。其实FAISS的强项恰恰是近似最近邻(ANN)。也就是说,它为了速度,会牺牲一点点精度,不保证100%返回绝对最接近的结果。很多新手不知道这一点,拿FAISS做精确匹配业务,结果一查发现漏数据,当场崩溃。
来看个真实案例。我有个学弟,公司内网部署RAG,他上来就写了个Flask服务,每次收到请求都执行:
import faiss
index = faiss.read_index("big_index.faiss")
D, I = index.search(query_vector, k=5)
你觉得这代码能跑吗?能跑。QPS多少?大概也就1。为啥?因为每次请求都从磁盘加载一遍索引文件,十几GB的索引,硬盘都快冒烟了。他跑来问我:“大仙,FAISS怎么这么慢?” 我说兄弟,你把图书馆当成自动售货机了,每买一瓶可乐都要重新盖一栋楼,能不慢吗?
解决方案/正确做法
首先,在脑海里给FAISS贴个标签:进程内的高性能ANN组件。它适合单机、本地化、嵌入式的RAG场景,不适合需要多机共享、实时高并发写入、复杂事务管理的场景(那些请交给Milvus、Pinecone或Weaviate)。
正确的姿势是启动时一次性加载索引,常驻内存:
class FaissRetriever:
    def __init__(self, index_path):
        self.index = faiss.read_index(index_path)
        # 如果GPU可用,可以转到GPU
        # self.index = faiss.index_cpu_to_all_gpus(self.index)

    def search(self, query_vec, top_k=5):
        return self.index.search(query_vec, top_k)

# 全局单例
retriever = FaissRetriever("my_index.faiss")
其次,一定要理解ANN的召回率与速度权衡。FAISS的索引构建时,你可以通过参数控制“有多近似”。比如IVF索引的nlist,HNSW的M和efConstruction。接受这一点——轻微牺牲召回率换取十倍百倍的加速,这正是FAISS的价值所在。
小结
把FAISS当成你Python程序里的高速检索插件,而不是一个独立的数据库服务。接受ANN的近似特性,你才能用对它。
2. 安装与环境配置:CPU还是GPU?Conda还是Pip?
点题
FAISS的安装,堪称“从入门到放弃”的第一道鬼门关。它底层是C++写的,依赖OpenBLAS、LAPACK、CUDA等一堆东西。你如果在错误的环境用错误的命令安装,迎接你的将是一屏幕猩红的编译报错。
痛点分析
第一个天坑:pip install faiss。这条命令在某些环境下会直接报错,或者装上一个根本不能用的版本。正确的包名是faiss-cpu或faiss-gpu。很多新手在PyPI上一搜,看到有个faiss包就装了,结果发现版本老旧,甚至是个空壳。
第二个天坑:CPU和GPU版本混装。你在有GPU的机器上pip install faiss-cpu,跑的时候发现GPU风扇纹丝不动,速度贼慢。反过来,你在没GPU的机器上装了faiss-gpu,一import faiss直接段错误(Segmentation Fault),因为CUDA runtime找不到。
第三个天坑:Windows原生环境。FAISS对Windows的支持 historically 比较折磨,尤其是GPU版本。很多新手在Windows CMD里折腾一下午,Anaconda Prompt和PowerShell来回切换,最后心态爆炸。
看看这段经典的错误示范:
# 错误安装后
import faiss
# 报错:OSError: [WinError 126] 找不到指定的模块
# 或者:ImportError: libfaiss.so: cannot open shared object file
还有一种隐蔽的错误:用conda装了一个版本,pip又装了另一个版本,两个包互相覆盖,导致faiss模块里有些函数有,有些函数没有,调试起来怀疑人生。
解决方案/正确做法
安装之前,先问自己三个问题:有没有NVIDIA显卡?CUDA版本是多少?用conda还是pip?
纯CPU环境,最简单:
pip install faiss-cpu
这个包现在有预编译的wheel,不需要你自己编译C++,成功率很高。
GPU环境,推荐用conda(预编译的CUDA依赖处理得更好):
conda install faiss-gpu -c pytorch
# 如果你需要指定CUDA版本,比如11.8
conda install faiss-gpu=1.7.4 cudatoolkit=11.8 -c pytorch
注意:faiss-gpu的conda包会把CUDA runtime一起处理好。如果你非要用pip装GPU版,那得自己确保系统里有匹配的CUDA和cuDNN,门槛高很多。
验证安装的小脚本,建议每个人都跑一遍:
import faiss
import numpy as np

print("FAISS version:", faiss.__version__)

# CPU测试
d = 128
index = faiss.IndexFlatL2(d)
vecs = np.random.random((1000, d)).astype('float32')
index.add(vecs)
D, I = index.search(vecs[:5], 10)
print("CPU search OK")

# GPU测试(如果期望用GPU)
try:
    res = faiss.StandardGpuResources()
    print("GPU resource OK")
except Exception as e:
    print("GPU not available:", e)
还有个小技巧:如果你是在**WSL2(Windows Subsystem for Linux)**里开发,装faiss-cpu的体验会比Windows原生好十倍。Windows不是不能跑,但WSL2能让你避开很多奇奇怪怪的动态链接库问题。
小结
装FAISS就像配钥匙,型号对不上,门永远打不开。CPU用faiss-cpu,GPU优先conda install faiss-gpu,装完跑验证脚本,确保没翻车再往下写业务代码。
3. 索引结构选型:Flat、IVF、HNSW、PQ到底怎么挑
点题
FAISS最核心、最精华、也最容易劝退新人的,就是它的索引(Index)体系。IndexFlatL2、IndexIVFFlat、IndexIVFPQ、IndexHNSWFlat、IndexPQ……这些名字看的人头皮发麻。选对了,查询速度起飞;选错了,要么内存爆炸,要么召回率低到怀疑人生。
这里我画个简单的决策流程,帮你建立直觉:
痛点分析
新手的第一个反应往往是:“我不懂,那我就用最暴力的,IndexFlatL2,总不会错吧?” 兄弟,数据量小的时候确实没错,但一旦你往里面扔了100万条768维的向量,内存占用直接 100万 * 768 * 4字节 ≈ 2.9GB,而且每次查询都要和这100万个向量逐一遍历算距离,延迟可能高达几百毫秒。这在RAG场景里,用户问你个问题,等半天才出第一个字,体验直接裂开。
另一个极端是盲目追求速度。听说HNSW快,上来就建HNSW,结果建索引的过程慢如蜗牛,内存占用比Flat还大,而且HNSW不支持直接删除(remove_ids在某些封装下行为怪异)。更惨的是选IVFPQ想省内存,结果没做训练(train)就直接add,搜索出来的结果完全是随机数,召回率惨不忍睹。
看看这个典型的翻车代码:
d = 768
quantizer = faiss.IndexFlatL2(d)
# 新手以为随便填个nlist就能跑
index = faiss.IndexIVFPQ(quantizer, d, 100, 8, 4)
vectors = np.random.random((10000, d)).astype('float32')
# 注意:这里直接add,没有train!
index.add(vectors)
# 搜索返回的结果几乎不可用
D, I = index.search(vectors[:5], 10)
print(I)
IVFPQ是需要先train的!你不train,聚类中心都是随机状态,量化器完全不准,查出来的邻居和你想要的基本没关系。很多新手在这一步卡了一周,以为是FAISS有bug,其实是自己漏了index.train(vectors)。
解决方案/正确做法
咱们按场景对号入座:
场景一:数据量小(<10万),或要求100%召回(比如金融、医疗的精确检索)
直接用 IndexFlatL2(欧氏距离)或 IndexFlatIP(内积)。简单、精确、无需训练。缺点只有一个:慢。但数据量小的情况下,够用了。
index = faiss.IndexFlatIP(d)  # 如果是归一化向量,IP等价于余弦相似度
index.add(vectors)
场景二:中等规模(10万~1000万),内存够,要速度
推荐 IndexIVFFlat。它需要训练,核心思想是先通过聚类把向量分到不同的桶(倒排列表)里,查询时只找最相近的几个桶。
nlist = 100  # 通常设置为 4 * sqrt(N),比如100万数据设4000
quantizer = faiss.IndexFlatL2(d)
index = faiss.IndexIVFFlat(quantizer, d, nlist)

# 必须训练!
index.train(vectors)
index.add(vectors)

# 查询时调节nprobe,越大越准越慢
index.nprobe = 10
D, I = index.search(query, k=5)
场景三:追求极致查询速度,内存不太敏感,数据量中等
用 IndexHNSWFlat。基于图结构,查询速度极快,不需要训练。但建索引慢,且内存占用通常比IVFFlat高。
index = faiss.IndexHNSWFlat(d, M=32)
index.hnsw.efConstruction = 128
index.add(vectors)

# 查询时调节efSearch
index.hnsw.efSearch = 64
D, I = index.search(query, k=5)
场景四:数据量巨大(千万级以上),内存吃紧
上 IndexIVFPQ。PQ(Product Quantization)把向量切成几段,每段分别量化,极大节省内存。但代价是有损压缩,召回率会下降,需要仔细调参。
nlist = 4096
m = 16  # 把768维切成16段,每段48维
nbits = 8  # 每段量化到8bit
quantizer = faiss.IndexFlatL2(d)
index = faiss.IndexIVFPQ(quantizer, d, nlist, m, nbits)

# 训练数据量要够,通常至少比 nlist * m * 256 大
index.train(vectors)
index.add(vectors)
高级技巧:FAISS支持组合索引。比如先用OPQ(旋转预处理)提升PQ效果,再套IVF,再套PQ,甚至底层quantizer换成HNSW。但这些属于进阶玩法,先把上面四个基础索引玩明白再说。
小结
没有完美的索引,只有最适合当下数据规模、内存预算和召回率要求的索引。记住三个关键词:小数据用Flat,中数据求平衡用IVFFlat,追速度用HNSW,省内存用IVFPQ。需要train的索引,千万别忘了train!
4. 数据管理与增量维护:ID映射和更新删除的坑
点题
很多教程教你index.add(vectors)和index.search(query),看起来岁月静好。但一落地到真实业务,问题来了:我怎么把FAISS里的向量ID和我业务里的文档ID对上号?我要删一条数据怎么办?我要更新一条数据的向量怎么办?FAISS的回答是:这事儿吧,有点复杂。
痛点分析
第一个痛点:默认的add()返回的ID是0, 1, 2, …,自增的。你的业务系统里,文档ID可能是UUID,可能是数据库主键,根本不连续。于是你add进去之后,根本不知道搜出来的ID对应哪篇文档。很多新手在这里手写一个“数组下标→文档ID”的映射表,结果add的顺序一改,映射全乱,检索结果驴唇不对马嘴。
第二个痛点:删除和更新。FAISS的核心索引(如IndexFlat、IndexHNSW)并没有设计为“高动态”的数据结构。remove_ids方法在部分索引上不存在,或者存在但效率极低,删完后不会自动释放内存,甚至可能让索引进入一种“幽灵状态”——ID没了,但内部统计信息还在,再次add或search时行为异常。
来看个错误示范:
index = faiss.IndexFlatL2(768)
index.add(vectors)

# 业务侧想删除ID=5的文档
# IndexFlatL2根本没有remove_ids方法!
# index.remove_ids(np.array([5], dtype='int64'))  # AttributeError
有些新手尝试用IndexIVFFlat,它确实有remove_ids,但删完后会发现,某些查询结果突然变差,或者返回的ID出现重复。这是因为IVF的倒排结构在删除后,内部聚类信息没有自动重新平衡。
那更新怎么办?FAISS没有update操作。你的文档内容变了,向量也要变,正确的逻辑应该是“先删后加”。但如果索引不支持删除,你就傻了。
解决方案/正确做法
FAISS提供了一个非常实用的包装器:IndexIDMap。它给你的索引加上一层ID映射,允许你使用自定义ID进行add_with_ids,以及remove_ids。
# 先创建一个基础索引
base_index = faiss.IndexFlatL2(d)
# 用IDMap包装它
index = faiss.IndexIDMap(base_index)

# 业务侧的文档ID,比如从数据库来的
doc_ids = np.array([101, 102, 103, 104, 105], dtype='int64')
vectors = np.random.random((5, d)).astype('float32')

# 带着业务ID添加
index.add_with_ids(vectors, doc_ids)

# 搜索返回的就是业务ID
D, I = index.search(query, k=3)
print(I)  # 比如 [[101, 105, 102]]
删除也变得可行了:
ids_to_remove = np.array([103], dtype='int64')
index.remove_ids(ids_to_remove)
但要注意!remove_ids在IndexIDMap包装下,底层索引必须支持。如果底层是IndexHNSWFlat,在某些FAISS版本里,remove_ids后可能无法正确工作。这时候怎么办?
工程上的兜底策略——标记删除 + 定期重建:
维护一个Python层面的set(),记录哪些ID已经被删除。查询时,FAISS返回的结果先经过这个set过滤,把已删除的ID剔除。如果有效数据量变化不大,这种方式开销很低。每隔一段时间(比如每天凌晨),或者当“脏数据”比例超过阈值时,用最新的有效数据重新构建一个全新的索引,原子替换旧索引。这是业界的常用做法,甚至很多商用向量数据库内部也是类似逻辑。
对于更新操作,同样推荐“写新索引 + 热切换”的思路:
# 伪代码
def rebuild_index(all_active_docs):
    new_index = faiss.IndexIDMap(faiss.IndexFlatL2(d))
    # 重新向量化所有活跃文档
    ids, vecs = vectorize(all_active_docs)
    new_index.add_with_ids(vecs, ids)
    faiss.write_index(new_index, "index_new.faiss")
    # 原子重命名,替换旧索引
    os.replace("index_new.faiss", "index.faiss")
    return new_index
小结
FAISS不是为高频增删改设计的。用IndexIDMap解决业务ID映射问题,用“标记删除 + 定时重建”解决更新删除问题,这是本地RAG工程化的标准答案。
5. 检索实战与调参:nprobe、距离度量与阈值过滤
点题
索引建好了,数据也灌进去了,到了最关键的一步:search。但检索不是简单地调用index.search()就完事的。查得准不准、快不快、结果能不能直接给大模型用,这里面有三道关卡:搜索深度(nprobe/efSearch)、距离度量(Metric Type)、结果过滤(阈值/去重)。
痛点分析
第一道坑:nprobe没调。如果你用的是IVF类索引(比如IndexIVFFlat),FAISS默认的nprobe通常是1。这意味着查询时,它只找距离最近的一个聚类中心,只搜索那个桶里的向量。万一你的目标向量刚好落在两个桶的边界上,而nprobe=1只搜了其中一个,那结果就是漏召回。用户明明知识库里有的内容,RAG却检索不出来,大模型开始胡编乱造。
第二道坑:距离度量选错了。你的向量化模型产出的是归一化向量(比如很多Sentence Transformer模型),理论上应该看余弦相似度或内积。结果你用了IndexFlatL2(欧氏距离)。虽然数学上归一化向量的欧氏距离和内积有单调关系,但一旦向量没有严格归一化,或者你用了某些特殊的embedding模型,L2和内积的结果排序可能大相径庭。更离谱的是,有些模型输出的是非归一化向量,必须用内积(IP)才能正确衡量语义相似度,用L2反而让语义相近的向量距离变大。
第三道坑:把检索结果无脑塞给LLM。search返回了top 5,距离分别是 0.1, 0.2, 0.3, 1.5, 2.0。后两个明显已经和查询没什么关系了(比如L2距离很大),但你还是把它们和前几名一起拼进了Prompt。大模型拿到这些垃圾上下文,输出质量直接雪崩。
看看这段典型的问题代码:
# 错误示范三连
index = faiss.IndexIVFFlat(quantizer, d, nlist)
index.train(vectors)
index.add(vectors)

# 坑1:忘了调nprobe,默认可能是1
# index.nprobe = 1

# 坑2:模型输出是归一化向量,但用了L2,且没检查
query_vec = model.encode("查询文本").astype('float32')

# 坑3:直接塞给LLM,不做过滤
D, I = index.search(query_vec.reshape(1, -1), k=5)
retrieved_texts = [doc_map[i] for i in I[0]]
prompt = f"根据以下资料:{retrieved_texts}\n回答问题:{query}"
解决方案/正确做法
第一,调nprobe(IVF类)或efSearch(HNSW类)。
对于IndexIVFFlat/IndexIVFPQ,nprobe控制搜索多少个倒排列表。公式很简单:nprobe越大,召回率越高,速度越慢。你需要在自己的测试集上做个简单的Grid Search。
# 用一小部分带标注的测试集来测召回率
for nprobe in [1, 5, 10, 20, 50, 100]:
    index.nprobe = nprobe
    # 计算top-k召回率...
    print(f"nprobe={nprobe}, recall@10={recall}")
通常nprobe设在10到100之间是个不错的起点。如果你发现nprobe调到1000了召回还不够,说明你初始的nlist可能设太大了,需要重建索引。
对于IndexHNSWFlat,调的是index.hnsw.efSearch:
index.hnsw.efSearch = 64 # 默认可能是16,增大可提升召回
第二,选对metric_type。
FAISS默认是METRIC_L2(欧氏距离)。如果你的模型输出是归一化向量,且你想用余弦相似度,直接选METRIC_INNER_PRODUCT(内积),因为归一化向量的内积等价于余弦相似度,且计算更快。
# 归一化向量 + 内积
index = faiss.IndexFlatIP(d)  # IP = Inner Product
如果你不确定向量是否归一化,可以在入库前手动归一化:
faiss.normalize_L2(vectors)  # 原地归一化
index = faiss.IndexFlatIP(d)
如果向量没有归一化,且语义相似度确实需要用余弦,那还是先归一化再用IP,或者直接用支持余弦的索引(底层其实也是归一化+IP)。
第三,设置距离阈值和结果后处理。
检索结果必须经过业务过滤才能进Prompt。以内积为例,IP值域通常是[-1, 1],越接近1越相似。你可以设一个阈值,比如0.75,低于这个值的直接丢弃。
D, I = index.search(query_vec, k=10)

# 过滤:假设用IP,保留距离大于0.75的
mask = D[0] > 0.75
filtered_ids = I[0][mask]
filtered_scores = D[0][mask]

if len(filtered_ids) == 0:
    # 兜底:检索不到时,直接告诉用户或走大模型无上下文模式
    pass
对于L2距离,则是保留距离小于某个阈值的。阈值怎么定?拿你的验证集统计一下正样本的距离分布,取个分位点。
小结
检索是RAG的咽喉要道。调对nprobe/efSearch保证不漏召,选对metric_type保证排序准,加上阈值过滤保证不给LLM喂垃圾。这三板斧砍下去,你的RAG回答质量能上一个台阶。
6. 持久化与内存优化:保存、加载与mmap黑科技
点题
FAISS的索引是内存里的对象。进程一关,全没了。怎么把它存到磁盘?怎么在几十GB的大索引下做到秒级启动?怎么让多线程查询不打架?这一节咱们聊聊工程化里的硬骨头。
痛点分析
第一个天坑:用pickle保存索引。Python程序员习惯啥都用pickle,但FAISS的Index对象里包含C++层面的指针和内存缓冲区,pickle虽然有时候能行,但跨版本极易损坏,而且不支持内存映射(mmap)。你pickle存进去的索引,下次加载必须全量读进内存,且可能直接load报错。
第二个天坑:大索引加载慢。你有一个50GB的索引文件,faiss.read_index()时,系统会一次性把这50GB从磁盘搬到内存。机械硬盘上可能要几分钟,而且内存占用瞬间爆炸。如果部署在容器里,健康检查都超时了,索引还没加载完,Kubernetes直接把你杀掉,无限重启循环。
第三个天坑:多线程的误区。有人以为Python有GIL,多线程对FAISS没用。但其实FAISS的search底层会释放GIL,多线程查询在CPU bound场景下是有收益的。然而有些新手为了“优化”,开100个线程去查一个CPU索引,结果上下文切换开销远大于查询本身,速度反而下降。另一方面,某些Index对象内部状态并不是完全线程安全的(虽然官方说read-only的search是线程安全的),在极端高并发下偶尔会出现core dump。
解决方案/正确做法
持久化:只用原生API。
# 保存
faiss.write_index(index, "my_index.faiss")

# 加载
index = faiss.read_index("my_index.faiss")
这是唯一推荐的持久化方式。FAISS有自己的二进制格式,稳定且高效。
大索引优化:内存映射(mmap)。
如果你的索引文件太大,而你的查询往往是“用其中一小部分”,或者你想让启动速度飞快,可以用faiss.IOFlagMmap或faiss.IOFlagMmapIfHuge。
# mmap模式加载,不会立刻占满物理内存
index = faiss.read_index("huge_index.faiss",
                         faiss.IO_FLAG_MMAP | faiss.IO_FLAG_READ_ONLY)
mmap的原理是把磁盘文件映射到虚拟内存地址空间,查询时只加载实际访问到的页(page)。好处是启动瞬间完成,内存占用根据查询压力按需增长。坏处是:如果索引文件在机械硬盘或网络存储(NAS/SMB)上,随机I/O的延迟会让查询速度暴跌。所以mmap一定要配合本地SSD使用。
如果你追求极致,可以把索引转成内存高效的格式。例如,IVFPQ本身压缩率就高;如果还不够,FAISS支持将索引中的某些部分(如HNSW的图结构)做进一步的内存优化存储。
多线程与并发:
FAISS的index.search()在只读场景下是线程安全的。你可以放心地用Python的ThreadPoolExecutor去并发查询,不需要加锁。
from concurrent.futures import ThreadPoolExecutor

def batch_search(queries):
    # queries: (batch_size, d) 的numpy数组
    return index.search(queries, k=5)

# 多线程处理多个请求
with ThreadPoolExecutor(max_workers=4) as executor:
    futures = [executor.submit(batch_search, q) for q in query_batches]
但要注意workers数量别超过CPU物理核心数太多。通常设成核心数或核心数+1即可。
GPU卸载:
如果你的机器有GPU,可以把CPU索引一次性搬到GPU上,查询速度能快数倍到数十倍。
res = faiss.StandardGpuResources()
gpu_index = faiss.index_cpu_to_gpu(res, 0, index)
D, I = gpu_index.search(queries, k=5)
但要注意GPU显存容量。50GB的索引,显存只有16GB,肯定是装不下的。这时候要么用faiss.index_cpu_to_all_gpus分散到多张卡,要么继续用CPU + mmap的方案。
小结
存索引用write_index/read_index,大索引用mmap加速启动,查询并发用线程池但要控制workers数量。内存、磁盘、GPU之间做好权衡,FAISS才能在你的本地机器上跑出生产级的性能。
7. RAG全流程集成:从文档切片到LLM Prompt的闭环
点题
讲了这么多FAISS本身,咱们最后把它串起来。在真实的RAG项目里,FAISS只是中间一环。前面有文档切片、向量化模型,后面有结果过滤、Prompt组装、大模型生成。任何一个环节掉链子,都会让FAISS的努力付诸东流。
痛点分析
维度不一致。你的向量化模型输出768维,结果建索引时随手写了个d=384,add的时候直接shape mismatch报错。或者你中途换了模型,新模型是1024维,但加载的是旧索引,搜索时维度对不上。
ID与内容对不上。搜出来ID=42,你去一个Python list里取texts[42],结果发现这个list在入库后被人 sorted 了一下,顺序变了,取出来的完全不是对应的文档。或者你存了向量但忘了存原文,检索后只有向量ID,根本不知道这段向量代表什么,还得回头去数据库再查一次,增加延迟。
结果未后处理直接塞给LLM。检索返回的top 5个chunk里,可能有3个来自同一篇文档的相邻段落,内容高度重复。全部拼进Prompt,浪费token不说,还会让大模型产生“重复强调”的偏差,影响回答质量。还有一种情况是,检索结果里包含代码、表格、特殊符号,没有清洗直接进Prompt,导致LLM理解混乱。
看看这段让人血压飙升的代码:
# 错误示范:维度没检查,内容没映射,结果没过滤
chunks = load_docs()  # 原始文档切片
model = SentenceTransformer("all-MiniLM-L6-v2")
vectors = model.encode(chunks)

# 假设model输出384维,但下面写成512
index = faiss.IndexFlatL2(512)
index.add(vectors)  # 这里会报错,或者如果恰巧shape对上但意思不对

def rag_chat(query):
    q_vec = model.encode([query])
    D, I = index.search(q_vec, k=5)
    # 直接用list下标取,假设chunks顺序永远不变
    context = "\n".join([chunks[i] for i in I[0]])
    prompt = f"已知:{context}\n问题:{query}\n回答:"
    return llm.generate(prompt)
这段代码里埋了至少三个雷:维度硬编码、内容映射脆弱、结果无过滤。
解决方案/正确做法
第一步:建立稳固的ID映射和内容存储。
不要依赖list的下标顺序。给每个文档切片一个全局唯一的ID,并用字典(或Redis、LevelDB等轻量级KV存储)维护 id -> metadata + text 的映射。
# 初始化时
doc_store = {}  # 或持久化到本地json/leveldb
index = faiss.IndexIDMap(faiss.IndexFlatIP(d))

for idx, chunk in enumerate(chunks):
    doc_id = generate_unique_id(chunk, idx)  # 比如hash或uuid
    vec = model.encode([chunk.text])
    faiss.normalize_L2(vec)  # 如果用IP,先归一化
    index.add_with_ids(vec.astype('float32'),
                       np.array([doc_id], dtype='int64'))
    doc_store[doc_id] = {
        "text": chunk.text,
        "source": chunk.source_file,
        "page": chunk.page_num
    }

faiss.write_index(index, "rag_index.faiss")
save_json(doc_store, "doc_store.json")
第二步:检索封装函数,做严格的后处理。
def retrieve(query, top_k=10, score_threshold=0.75, max_chars=3000):
    q_vec = model.encode([query])
    faiss.normalize_L2(q_vec)

    D, I = index.search(q_vec.astype('float32'), top_k)

    results = []
    seen_sources = set()

    for score, doc_id in zip(D[0], I[0]):
        # 坑点:如果doc_id被删除,doc_store可能找不到,要兜底
        if doc_id not in doc_store:
            continue

        # 距离过滤:IP是越大越好,L2是越小越好,这里假设IP
        if score < score_threshold:
            continue

        doc = doc_store[doc_id]

        # 去重:同一段内容不要重复出现(可选)
        if doc["text"] in seen_sources:
            continue
        seen_sources.add(doc["text"])

        results.append({
            "text": doc["text"],
            "source": doc["source"],
            "score": float(score)
        })

        # 控制总长度,别超过模型上下文
        if sum(len(r["text"]) for r in results) > max_chars:
            break

    return results
第三步:Prompt工程与LLM衔接。
检索出来的结果,不要直接粗暴拼接。给每个chunk加上编号和来源标识,让大模型知道信息的边界。如果检索结果为空,千万别硬编一个空字符串进Prompt,要明确告诉模型“未检索到相关资料”,触发它的知识库回答或拒答策略。
def build_prompt(query, retrieved):
    if not retrieved:
        context_str = "(未检索到相关资料)"
    else:
        context_parts = []
        for i, r in enumerate(retrieved, 1):
            context_parts.append(f"[{i}] 来源:{r['source']}\n{r['text']}")
        context_str = "\n\n".join(context_parts)

    prompt = f"""请根据以下参考资料回答问题。如果资料不足以回答,请基于你的通用知识回答,并说明未在资料中找到直接依据。

参考资料:
{context_str}

用户问题:{query}

请给出清晰、准确的回答:"""
    return prompt
第四步:全链路防御性编程。
- 维度检查:在add和search的地方都加上
assert vec.shape[1] == index.d,防止模型偷偷升级。 - 异常捕获:
search时如果索引损坏或内存不足,会抛异常,不要让整个服务挂掉。 - 日志记录:记录每次查询的检索耗时、召回数量、进入Prompt的token数,方便后续调优。
assert vectors.shape[1] == index.d, f"维度不匹配!索引:{index.d}, 向量:{vectors.shape[1]}"
小结
FAISS再强,也只是RAG pipeline里的一个齿轮。只有和向量化模型、文档管理、结果后处理、Prompt工程严丝合缝地咬合在一起,才能驱动大模型生成高质量的答案。记住:检索是起点,不是终点。
写在最后
咱们今天把FAISS这个Meta开源的本地向量检索库,从头到脚捋了一遍。从它的“库”而非“服务”的本质定位,到安装时CPU与GPU的版本抉择;从Flat、IVF、HNSW、PQ的索引选型心法,到ID映射、增量更新、删除重建的工程化套路;从nprobe调参、距离度量、阈值过滤的检索三板斧,到write_index、read_index、mmmap的持久化与内存优化;最后再到RAG全链路的闭环集成。
你看,FAISS并不难,它只是细节特别多。每一个新手踩过的坑,本质上都是对“本地部署”这四个字缺乏敬畏。没有运维帮你在背后兜底,没有云服务的自动扩缩容,一切都要你自己亲力亲为。但也正是这种亲力亲为,让你对向量检索的每一个字节、每一次计算都了然于胸。
编程之路不易,RAG这股风虽然大,但风停了,掉下来的都是没长翅膀的猪。保持好奇,持续动手,把每一个报错都当成升级的经验包。你不需要一天就成为大神,但今天搞懂了FAISS,明天你的RAG项目就少崩一次。每一步成长都算数,咱们下回见!
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:2026 年多模态大模型实战训练营》
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》
AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 4
 0
- 0


 已为社区贡献209条内容

所有评论(0)