
【大模型RAG生成式AI开发实战】《大模型RAG生成式AI开发实战》_142.[第15章 向量数据库选型] 向量数据库全景对比:Pinecone、Milvus、Weaviate、Qdrant
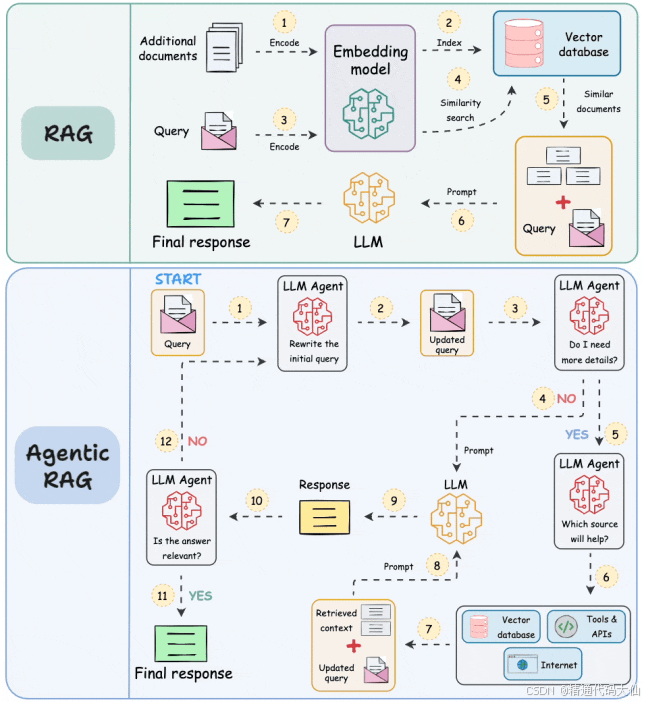
把Pinecone、Milvus、Weaviate、Qdrant扒个底朝天!RAG项目选型不踩坑,看完这篇你比架构师还会选!从云原生托管到自建集群,从Python生态到Rust性能怪兽,咱们不聊虚的,直接告诉你什么场景该上什么车,新手也能秒变选型老司机。
目录速览:
- 选型方法论:“托管vs自建”的本质鸿沟
- Pinecone:开箱即用的“懒人福音”,但要算清经济账
- Milvus:企业级全能战士,分布式与多模态的深水区
- Weaviate:语义原生与模块化设计的独特哲学
- Qdrant:Rust写就的性能怪兽,小团队的高性价比之选
- 决策罗盘:四维度选型法与RAG场景适配实战
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《大模型RAG生成式AI开发实战》142.[第15章 向量数据库选型] 向量数据库全景对比:Pinecone、Milvus、Weaviate、Qdrant
学RAG就像打游戏,你以为BOSS是大模型的Prompt工程,结果新手村门口第一个小怪——向量数据库选型——就把你送回了复活点。很多新手朋友一上来就懵了:Pinecone、Milvus、Weaviate、Qdrant,名字都念不利索,网上一搜,有人说这个快,有人说那个稳,还有人说“我用某某某从没出过问题”。你越看越慌,越看越焦虑,生怕选错一个组件,整个项目就埋了雷。这种怕踩坑的心情,我太懂了。毕竟,向量库一旦定下来,后期迁移的成本可不是改几行配置那么简单。今天这篇,咱们就把这四个主流向量数据库放到手术台上,一层层剖开看,保证你看完心里跟明镜似的。
选型先选“型”:托管服务与自建部署的鸿沟
点题
很多人一上来就对比“谁支持混合查询”、“谁检索更快”,这属于还没学会走就想跑。向量数据库首先要分两大类:全托管(Fully Managed)和自建(Self-Hosted)。Pinecone是纯托管的代表,你只管写代码,它帮你管服务器。Milvus和Qdrant骨子里是给工程师折腾的自建方案,虽然也有云服务,但核心优势在于私有化部署。Weaviate卡在中间,既有托管版也有本地版。选型的第一个灵魂拷问是:你的团队,有人能半夜起来修服务器吗?
从架构哲学上看,Pinecone是云原生的极致,连“实例”这个概念都帮你隐藏了。Milvus是云原生但偏重型,它假设你拥有完整的DevOps工具链。Qdrant是云友好但轻量,一个Docker容器就能跑,但又允许你玩出花。Weaviate则像一块瑞士军刀,既能在你的笔记本上安静运行,也能在K8s里咆哮。
痛点分析
我见过太多血淋淋的案例。某初创公司兄弟,听网上说Milvus好,直接本地Docker Compose一套,召回链路跑通了,老板很开心。结果上线第二天,数据量一涨,查询慢得像蜗牛,Docker容器直接OOM killed。他傻眼了:明明本地测试好好的啊?大哥,你那是测试数据集,就几千条。生产环境上百万条768维的float32向量,仅 raw data 就要吃掉近3GB内存,加上HNSW索引膨胀,单机内存直接爆表。而他们公司连个懂K8s的人都没有,连Heap dump都不会看。
另一个极端,某大厂架构师做内部知识库RAG,图省事直接用Pinecone,按量付费。结果内部搞了个大促活动,向量查询量暴增,月底账单五位数起步。他去找财务解释,财务眼神能杀人。这就是没算清“托管税”。你以为托管是省心,其实是在用真金白银换人力。还有更隐蔽的坑:有的团队对数据隐私要求极高,金融和医疗场景下,客户数据根本不能出内网,结果有人选了纯托管的海外服务,合规审计直接挂红灯,项目差点黄掉。
解决方案与正确做法
画张简单的决策草图在你心里。先别管功能,先看人。如果你是个人开发者、学生党、或者公司就三五个研发,没有任何运维资源——闭眼先考虑Pinecone Serverless或者Weaviate Cloud。它们按查询收费,没有运维负担,让你把精力集中在RAG业务逻辑上,而不是凌晨三点修etcd。
如果你们公司已经有DevOps团队,数据规模明确要上亿,或者你对数据隐私极度敏感,那再考虑Milvus集群或Qdrant自建。Milvus的分布式架构是真·分布式,不是闹着玩的,但它需要至少一个懂对象存储(S3/MinIO)、消息队列(Pulsar/Kafka)和K8s调度的工程师。
记住一个公式:团队运维能力 < 向量库复杂度 = 迟早出事。先老实评估自己的人力,再选工具。RAG项目最大的风险不是检索不准,而是半夜告警没人会处理。
小结
选型不是选最强王者,而是选和你团队当前段位最匹配的那个。别让架构复杂度,跑在业务需求前面。
Pinecone:开箱即用的“懒人福音”,但要算清经济账
点题
Pinecone应该是目前对新手最友好的向量数据库。没有集群概念,没有分片概念,你拿到一个API Key,几行Python代码就能把向量存进去、搜出来。它就像云函数一样,纯纯的Serverless体验。但友好的背面,是高度封装带来的灵活性缺失,以及你可能忽略的成本陷阱。它适合当你想“先跑起来再说”的时候,但不适合当你需要深度定制召回逻辑的时候。
痛点分析
新手最容易栽在三个坑里。第一,索引类型选错。Pinecone有Pod-based和Serverless两种。Pod-based是传统预留资源模式,最低配的pod一个月也要几十刀,而且扩容不灵活。有同学直接默认创建,结果用了Pod-based,上线后发现流量波动大,低峰期也在烧钱。第二,metadata过滤用得像摆设。Pinecone对metadata的过滤支持有限,复杂的多条件AND/OR查询性能会暴跌。有人试图把关系型数据库的查询逻辑搬过来,在metadata里塞了十几个字段做联合过滤,结果召回从10ms变成2s,还以为是大模型慢了,疯狂优化Prompt,结果坑在向量库。
第三,维度限制和距离度量方式选错就改不了。有人一开始用欧氏距离(euclidean),后来想换成余弦相似度(cosine),发现索引建好了不能改,只能重建。数据量小还好,几百万条向量重建一次,业务中断半小时,用户投诉直接刷屏。
还有一个隐形的坑:成本控制盲区。Pinecone Serverless是按读写单元(RPU/WPU)收费的。如果你做RAG时不做缓存,每次用户提问都触发一次向量搜索,流量一上来,账单会让你体会到什么叫“肉疼”。有个做客服机器人的团队,上线第一周账单就破千,一查才发现是用户在疯狂点击“重新生成”,每次点击都走了一次完整的向量化+检索+生成链路。
解决方案与正确做法
对于RAG新手,Pinecone依然是最好的起跑线。建议这样用:新项目直接选Serverless,零起步成本,按查询付费,没流量就不花钱。做metadata过滤时,尽量简化条件,把复杂的过滤逻辑前置到数据预处理环节,或者结合外部的Redis做一层粗筛。比如先按业务类型在Redis里筛出候选ID列表,再进Pinecone做语义检索,别想着一个数据库干所有活。
向量维度务必在业务开始前定死。如果你用OpenAI的Embedding模型,1536维或3072维是主流,距离度量无脑选cosine,兼容性最好,以后换模型也不容易踩坑。
成本控制方面,一定要在RAG链路里加缓存层。比如用Redis把热门query的向量搜索结果缓存10分钟。别小看这一步,它能帮你砍掉50%以上的无效查询。另外,Pinecone的namespace功能要善用,把不同业务的数据隔离开,既能提升性能,也方便后续清理。还要注意,Pinecone的免费档有容量限制,适合PoC,别指望它扛生产流量。
小结
Pinecone是RAG开发的“新手村保护卡”,但出了新手村,你要开始学会看账单、读限制、做缓存。把它当做一个精致的“语义缓存盒”,而不是万能数据库。
Milvus:企业级全能战士,分布式与多模态的深水区
点题
Milvus由Zilliz开源,是目前功能最全面的分布式向量数据库。支持GPU索引(CAGRA)、多模态向量、标量向量混合查询、甚至向量间的复杂距离计算。如果你要做十亿级别的大规模RAG,或者需要同时检索文本、图片、视频向量,Milvus几乎是绕不开的选项。但功能全面意味着概念多、门槛高,它是一头需要驯服的猛兽。
痛点分析
新手面对Milvus,第一个劝退点就是概念爆炸。Collection、Partition、Shard、IndexType、Consistency Level…光看文档就头大。有同学直接照葫芦画瓢,把Milvus当MySQL用,建一个Collection塞所有数据,不做Partition,不建索引,结果查询时扫描全量数据,慢得一批。还有人搞不清Milvus的多种索引:IVF_FLAT、HNSW、DiskANN、GPU_CAGRA,闭着眼睛选默认HNSW,结果数据量到了十亿级,内存占用直接压垮服务器,因为HNSW是内存索引,数据量越大越吃内存。
另一个典型误区是在小规模场景强行上Milvus集群。我见过一个五人团队,数据就几十万条,非要照着官方文档搭K8s集群,上了MinIO、Etcd、Pulsar一整套。部署花了两周,bug调了一周,最后发现单机版Qdrant十分钟就能搞定的事,他们搞成了“微服务地狱”。这就是典型的“杀鸡用牛刀”,刀还崩了刃。更要命的是,Milvus的版本迭代快,从1.x到2.x架构完全重写,网上很多旧教程已经过时,新手照着做,连API都对不上,直接裂开了。
解决方案与正确做法
用Milvus之前,先问自己三个问题:数据有没有过千万?是否需要分布式扩展?有没有专职运维?如果三个都是Yes,再上Milvus不迟。
在RAG场景中,Milvus的真正优势在于混合检索。你可以把向量和标量字段放在一起查,比如“找与这段代码语义相似的Python项目,且star数大于1000,更新时间在近一年内”。这种查询Pinecone做起来很别扭,Milvus原生支持。另外,如果你的RAG涉及图片、音频,Milvus的多向量支持和GPU索引能显著提升构建速度。
给新手的实操建议:先用Docker单机版Milvus Standalone做验证,通过Attu可视化工具熟悉Collection和Partition概念。别一上来就搞cluster模式。索引选择也有讲究:百万级数据用HNSW,追求极致召回用FLAT,十亿级以上且内存吃紧再考虑DiskANN(磁盘索引)。千万级以下的项目,你很可能根本不需要Milvus,别给自己加戏。
小结
Milvus是企业级RAG的终极答案,但你的团队得先配得上它的复杂度。把它当成航空母舰,没舰队护航,别开出去。
Weaviate:语义原生与模块化设计的独特哲学
点题
Weaviate是一个用Go语言编写的向量数据库,它的设计理念和其他几家截然不同。它内置了向量化模块(Vectorizer),甚至可以直接在数据库层面做生成式查询(Generative Search)。最特别的是它的模块化架构:Retriever、Ranker、Generator都可以像插件一样插拔。如果你的RAG系统需要频繁切换Embedding模型,或者需要深度集成语义理解能力,Weaviate会让你眼前一亮。
痛点分析
然而,Weaviate的“特别”也成了新手的拦路虎。首先是接口风格:它主打GraphQL,虽然也有RESTful API,但高级功能都在GraphQL里。习惯了JSON和SQL的程序员,看到GraphQL的查询语法直接懵了。“这花括号套花括号的是啥?我查个向量怎么跟写代码似的?”有同学硬用RESTful做复杂查询,结果很多混合搜索功能用不了,回过头来骂Weaviate难用,其实是你没走正门。
其次是模块配置的黑盒感。你想换个Embedding模型?得去改docker-compose里的ENABLE_MODULES环境变量,还要理解text2vec-openai、text2vec-cohere、text2vec-transformers的区别。有新手配了半天,发现向量没自动生成,一查日志是模块没加载,整个人都不好了。这种“配置即代码”的思路,对急着想跑通Demo的同学来说,简直是折磨。
还有一个深坑是Weaviate的混合搜索(Hybrid Search)权重调优。它把稠密向量(Dense Vector)和稀疏向量(BM25)做加权融合,但默认权重不一定适合你的语料。有人直接 copy 官方示例,发现关键词匹配太强,语义匹配太弱,或者反过来,搜出来的结果总是不对味,却不知道怎么调alpha参数,最后弃坑。
解决方案与正确做法
把Weaviate当成一个“语义中台”而不是纯粹的向量存储,你的心态就顺了。它的核心优势是RAG流程的原生支持:你甚至可以发一个GraphQL请求,让它帮你完成“向量化→向量检索→LLM生成总结”的全链路,代码量极少。
在选型上,如果你的项目符合以下画像,优先考虑Weaviate:需要向量搜索+BM25关键词搜索的混合排序;需要动态切换多个Embedding模型做A/B测试;需要内置的向量化(不想自己调OpenAI接口)。配置模块时,建议先用Docker Compose单机版,从text2vec-openai起步,因为不需要本地GPU,配置最简单。
对于GraphQL的畏惧,其实入门只需要掌握三个概念:Get(查询)、Aggregate(统计)、Generative(生成)。花半小时看几个例子,你会发现它比RESTful更省带宽。调Hybrid Search时,记住alpha参数是0到1之间,0代表纯BM25,1代表纯向量搜索。建议从0.7开始测,逐步逼近你业务的最佳点。
小结
Weaviate不是最顺手的向量库,但如果你在语义检索上追求深度定制,它是最好的乐高玩具。搭好了绝妙,搭错了抓狂,耐心看完文档是你的入场券。
Qdrant:Rust写就的性能怪兽,小团队的高性价比之选
点题
Qdrant是用Rust语言编写的向量数据库,这个出身就决定了它的基因:内存安全、高并发、低延迟。在四个选手中,Qdrant的社区活跃度近年飙升,特别适合中小规模但性能敏感的场景。它的API设计非常干净,过滤查询(Payload Filtering)性能极强,而且资源占用控制得极好。如果说Milvus是重型坦克,Qdrant就是灵活的武装直升机。
痛点分析
很多新手对Qdrant有“小众恐惧症”:“Rust写的?社区有没有Python客户端啊?出了问题去哪搜资料?”其实Qdrant的Python客户端非常完善,文档也清晰。真正的坑在别处。
第一大坑是数据持久化。有同学图方便,docker run qdrant/qdrant直接启动,没挂volume。跑了半个月,容器一重启,向量全没了,当场石化。向量数据库也是数据库,持久化配置是底线。
第二大坑是Payload索引的缺失。Qdrant支持很强大的payload过滤,比如按状态、时间、标签做复杂组合查询。但如果你没给这些字段建索引,过滤查询会退化成全表扫描。有同学在十万级数据里做时间范围过滤,没建索引,查询从5ms变成500ms,还以为Qdrant性能不行,其实是自己没加索引。
第三大坑是内存规划。Qdrant默认尽量把数据放内存,如果你服务器内存只有2G,却塞了几百万条768维向量,它也不会温柔提醒,会直接OOM。有位兄弟用2C4G的阿里云跑Qdrant,存了80万条向量,三天两头被系统Kill,愁得头发掉了一把,后来一算才发现内存根本不够。
解决方案与正确做法
Qdrant是我个人最推荐给技术型小团队做RAG自建的选项。部署简单,单机性能强悍,而且它的过滤查询设计得非常符合程序员直觉。
正确的打开方式:Docker部署时务必挂载持久化卷,-v $(pwd)/qdrant_storage:/qdrant/storage。给所有用于过滤的payload字段显式创建索引。内存方面,做下简单估算:100万条768维float32向量约等于3GB,再加上HNSW索引和payload,预留5GB内存比较安全。如果内存吃紧,可以启用on-disk存储(mmap),牺牲一点查询速度换取稳定性。
在RAG架构里,Qdrant特别适合作为精排前的召回层。它的HNSW索引查询极快,加上payload过滤,能帮你快速从百万级文档中筛出候选集。而且Qdrant支持多向量集合(Collections),你可以把用户问题向量和文档向量分开放,做更复杂的语义匹配。它的快照(Snapshot)功能也很贴心,备份恢复一条龙,适合生产环境。
小结
别被Rust吓到,Qdrant可能是你自建RAG向量层时,性价比最高的那个隐藏BOSS。小而美,快且稳,是技术团队的私房利器。
决策罗盘:四维度选型法与RAG场景适配实战
点题
聊了这么多特性,最后必须给你一个“傻瓜式”决策框架。我总结了四个维度:数据规模、运维能力、查询复杂度、预算上限。拿着这四个维度去套,基本不会出错。选型不是玄学,是工程,工程就要讲逻辑。
痛点分析
最怕的就是“拍脑袋选型”。有同学在网上看了篇文章说“Milvus牛逼”,也不管自己数据就几千条,吭哧吭哧学了半个月K8s,最后项目黄了,向量库还没搭好。还有同学做企业POC,为了省钱自建Qdrant,结果客户要求99.99%可用性,他单机部署半夜挂了没人知道,第二天被客户骂成狗。
另一个误区是“只看吞吐量,不看延迟分布”。RAG场景下,向量检索的P99延迟比平均延迟重要得多。大模型本身生成就慢,如果向量检索偶尔抽风飙到2秒,用户体验直接崩盘。有人做benchmark只跑平均QPS,上线后才发现 tail latency 高得离谱,用户反馈“有时很快,有时卡死”,这种抖动最致命。
还有一种情况是过度工程化。明明Pinecone Serverless一个月几十块就能搞定的事,非要自建Milvus集群,雇两个运维看着。或者明明需要混合搜索,却选了只擅长纯向量检索的数据库,召回质量永远上不去。
解决方案与正确做法
直接上决策表,对号入座:
更细一点说:数据量在百万级以下、团队无专职运维、想快速验证RAG效果——直接Pinecone Serverless,别犹豫。数据量过亿、业务多模态、有K8s专家——Milvus是你的终极战场。需要深度语义定制、频繁换模型、喜欢GraphQL——Weaviate让你如鱼得水。技术能力强、预算敏感、想完全掌控基础设施——Qdrant自建,省下的钱够给团队加鸡腿。
在RAG落地时,还有一个实操技巧:不要只测“能搜到”,要测“搜得快且稳”。建议用Locust或k6压测时,重点看P95和P99延迟。如果你用Qdrant或Milvus自建,监控一定要配好,至少看内存使用率、磁盘IO、查询QPS三条线。
最后,记住选型的动态性。项目初期用Pinecone快速验证,用户量上来了再迁移到Milvus或Qdrant,这是很多成功团队的共同路径。别把初期选型当成一辈子的婚姻,但要确保迁移成本可控——比如始终保留原始文本和向量生成的pipeline,不要过度绑定某个数据库的专有语法。向量可以重新生成,业务逻辑不能乱。
小结
向量数据库没有“最强”,只有“最适配”。掌握四维罗盘,你就能在RAG航道上精准导航,不再人云亦云。
写在最后
说实话,向量数据库这个领域还在疯狂进化,今天的热门选手明天可能就变天。但选型的底层逻辑是不变的:看懂自己的业务阶段,匹配工具的认知成本,留好架构的演进空间。做RAG就像做菜,大模型是主厨,向量库是切配师傅——切配不稳,主厨再牛也出不了好菜。
很多新手总怕选错,其实比起选错,更可怕的是因为怕选错而永远停留在对比阶段。Pinecone、Milvus、Weaviate、Qdrant,随便选一个先跑起来,在实战中你自然会知道它的边界在哪。编程之路不易,但每一步折腾都算数。保持好奇,持续学习,你也能成为那个在架构评审会上拍板说“我们就用这个”的淡定大神。
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:2026 年多模态大模型实战训练营》
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》
AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 6
 0
- 0


 已为社区贡献209条内容

所有评论(0)