
一张图讲透OpenClaw:Agent、Skill、Tool
一、先问一个扎心的问题
你有没有这样的经历:
对 ChatGPT 说:"帮我根据我公司的产品手册写一份竞品分析。"它说:"好的!"然后给你一堆泛泛而谈的内容——因为那本手册它根本没见过。
你叹了口气:AI 啊,你既不会操作文件,也不知道我的内部资料。
但如果你用的是 OpenClaw,你会看到另一番景象——它能读取你本地的产品手册 PDF,检索内部知识库中的相关章节,结合搜索到的公开竞品信息,最后直接输出一份有来源引用的竞品对比报告,自动保存到你的工作区。
区别在哪?
区别在于:ChatGPT 只有 LLM(语言模型),而 OpenClaw 让 LLM 拥有了 Agent、Skill、Tool 和 RAG 五位一体的完整作战体系。
别急,我们用一个比喻把这五者的关系讲清楚。
二、终极比喻:一家 AI 公司的组织架构
想象一下,OpenClaw 就是一家公司,里面有五个关键角色:
🧠 LLM —— 大脑(CEO)
LLM = Large Language Model,大语言模型。
它是整个系统的"大脑",负责理解你的意图、做决策、写方案、拍板定案。
- GPT-4o、Claude、文心一言……这些名字你肯定听过,它们就是 LLM。
- LLM 擅长的是:理解自然语言、推理、判断、组织表达。
- 但它不会动手——就像一个只有战略头脑、从未进过车间的 CEO。
- LLM 能干的事: 理解、推理、总结、生成文本、做决策。
- LLM 干不了的事: 打开浏览器、操作 Excel、发邮件、查找内部文档。
LLM 能干的事: 理解、推理、总结、生成文本、做决策。LLM 干不了的事: 打开浏览器、操作 Excel、发邮件、查找内部文档。
👔 Agent —— 项目经理(业务负责人)
Agent = AI 智能体。
如果说 LLM 是大脑,Agent 就是装在大脑上的身体+人格+记忆。
Agent 的构成:
Agent = LLM(决策) + Soul(人设/性格) + Memory(记忆系统) + Skills & Tools(能力矩阵) + RAG(知识库连接器)
在 OpenClaw 中,Agent 是一个完整的"服务身份":
- 每个 Agent 有独立的 SOUL.md(人格设定)、MEMORY.md(长期记忆)、HEARTBEAT.md(定时任务)。
- 一个 Gateway 可以运行多个 Agent,每个 Agent 有自己的模型配置、技能组合和用户群。
- Agent 通过 Session(会话)与你对话,记住你是谁、你上次说了什么、你喜欢什么风格。
Agent 的价值: 把"冷冰冰的模型"变成"有记忆、有性格、能持续服务的私人助理"。
📚 RAG —— 图书馆管理员(知识补给官)
RAG = Retrieval-Augmented Generation,检索增强生成。
这是本文新增、也是最重要的一章。
LLM 最大的短板是什么?——它只知道自己训练截止之前见过的公开知识。
你问:"我们公司的请假制度是什么?"LLM 答:“这取决于各公司的政策……通常是一周 5 天……”(幻觉开始)
RAG 的解决思路:不要求 LLM 记住一切,而是在它回答问题之前,先帮它从外部知识库"翻书"。
用户在 Telegram 问 OpenClaw:
”新员工入职流程第三步是什么?”
│
▼
┌──────────────────────────────┐
│ Agent 判断需要检索知识库 │
│ → 触发 RAG Skill │
└──────────────┬───────────────┘
▼
┌──────────────────────────────┐
│ Embedding 模型将问题 │
│ ”新员工入职流程第三步是什么?” │
│ → 转化为向量表示 │
└──────────────┬───────────────┘
▼
┌──────────────────────────────┐
│ 在本地向量数据库 │
│ (如 Qdrant)中做相似度检索 │
│ → 找到最相关的 3 个文档片段 │
└──────────────┬───────────────┘
▼
┌──────────────────────────────┐
│ 把【原始问题】+ │
│ 【检索到的文档片段】 │
│ 一起喂给 LLM │
└──────────────┬───────────────┘
▼
┌──────────────────────────────┐
│ LLM 基于真实文档生成答案 │
│ ”根据员工手册第 12.3 条……” │
│ 并标注引用来源 │
└──────────────┬───────────────┘
▼
Agent 回复给用户
RAG 的本质: 给 LLM 配了一个即查即用的"随身图书馆",不再是闭卷考试,而是开卷答题。
🛠️ Tool —— 扳手和螺丝刀(原子级操作)
Tool = 单个具体的操作能力。
Tool 是最小执行单元,一次只做一个动作:
| Tool | 干什么 |
|---|---|
exec | 执行一条命令行 |
read / write | 读取 / 写入文件 |
web_search | 搜索互联网 |
browser | 操控浏览器 |
message | 发消息(微信/飞书/Telegram) |
tts | 语音合成 |
memory_search | 搜索本地记忆知识库 |
关键特征:
- Tool 没有逻辑,它只管干活,不判断该不该干。
- Tool 没有记忆,每次调用是独立的。
- 一个 Task 往往需要 串联多个 Tool 才能完成。
📦 Skill —— 标准化作业流程(SOP)
Skill = 一组 Tool 的组合 + 完整的业务流程 + 错误处理机制。
这是 OpenClaw 最精妙的设计之一。
在没有 Skill 之前,Agent 是这样工作的:
用户:”帮我把这个数据整理成表格。”
LLM 想:”我需要……读文件 → 搜索数据 → 写内容 → 生成 Excel → 发邮件”
→ 但是用哪个工具?参数怎么拼?出错了怎么办?先读哪个后读哪个?
→ 每次都要重新推理一遍,又慢又不稳定。
有了 Skill 之后:
用户:”帮我把这个数据整理成表格。”
Agent → 匹配到 skill ”xlsx-processor”
Skill(SKILL.md):”收到数据处理请求,按以下固定流程执行:”
Step 1: 调用 read 读取源文件
Step 2: 调用 exec 运行 Python 清洗脚本
Step 3: 调用 xlsx skill 生成工作表
Step 4: 调用 message 通知用户
任何一步出错 → 按预设逻辑恢复或通知用户
Skill 的本质
Skill 就是一个包含 SKILL.md 的文件夹,里面定义了:
- 元数据:这个名字叫什么、什么时候触发(triggers)、能干什么(description)
- 执行逻辑:主流程、分支判断、循环、结果组装
- 内部调用:调哪些 Tool、顺序是什么、出错怎么处理
Skill(一个业务能力)
├── 元数据:trigger、prompt、说明(对外:我能干啥)
├── 执行逻辑
│ ├── 参数校验
│ ├── 分支判断 / 循环
│ ├── 结果组装 / 格式化
│ └── 错误处理
└── 内部调用:多个 Tool
├── Tool1:read(读取文件)
├── Tool2:exec(执行脚本)
├── Tool3:web_fetch(抓取网页)
└── Tool4:edit(精准编辑文件)
三、一张大图:五者是怎么协作的
当你对 OpenClaw Agent 说一句"帮我调研一下竞对 A 的产品,参考我们内部的产品手册,做个对比报告"时,背后的协作链路是这样的:
┌─────────────────────────────────────────────────────────────┐
│ 用户的消息 │
│ ”帮我对比竞品 A 和我们自己的产品,参考内部产品手册” │
└─────────────────────┬───────────────────────────────────────┘
▼
┌─────────────────────────────────────────────────────────────┐
│ 🧠 LLM(大脑 - 接收并拆解任务) │
│ • 理解意图:竞品对比 + 参考内部资料 │
│ • 拆解任务: │
│ ① 获取内部产品手册相关内容 → 走 RAG │
│ ② 搜索竞品 A 的公开信息 → 走 web_search │
│ ③ 生成对比报告 → 走 Skill”report-generator” │
│ • 决策:这是一个多步骤复合任务 │
└────────┬───────────────┬───────────────────┬─────────────────┘
│ │ │
┌────▼────┐ ┌─────▼──────┐ ┌──────▼──────┐
│ 📚 RAG │ │ 🛠️ Tool │ │ 📦 Skill │
│(知识检索)│ │ (执行操作) │ │ (流程编排) │
└────┬────┘ └─────┬──────┘ └──────┬──────┘
│ │ │
• Embedding • web_search • 汇总全部素材
• Qdrant检索 • read 手册PDF • 按模板组织
• Reranker精排 • web_fetch • 生成 Markdown
• 返回3个片段 • edit 报告 • 返回 Agent
└────┬────┘ └─────┬──────┘ └──────┬──────┘
│ │ │
└───────┬───────┴───────────────────┘
▼
┌─────────────────────────────────────────────────────────────┐
│ 👔 Agent(总指挥 - 汇聚各方结果) │
│ • RAG 提供了公司内部产品的 3 个核心卖点 │
│ • web_search 找到了竞品 A 的最新功能列表 │
│ • report-generator Skill 将它们整合成结构化的对比报告 │
│ • Agent 判断:全部素材齐了 → 可以交付 │
└─────────────────────┬───────────────────────────────────────┘
▼
┌─────────────────────────────────────────────────────────────┐
│ 🧠 LLM(最终回答生成) │
│ • ”以下是竞品对比报告。基于内部产品手册和公开信息……” │
│ • 每条结论后附带来源引用 │
└─────────────────────────────────────────────────────────────┘
各角色分工一览:
| 场景步骤 | RAG 负责 | Tool 负责 | Skill 负责 |
|---|---|---|---|
| 1. 理解问题 | — | — | — |
| 2. 找内部知识 | 向量检索知识库 | read 读取 PDF | — |
| 3. 找公开信息 | — | web_search 搜竞品 | — |
| 4. 整合素材 | 提供引用来源 | edit 写入报告 | 组织全文结构 |
| 5. 输出结果 | — | — | 格式化 + 交付 |
四、为什么这个五件套特别厉害?
1. Skill 把不确定性变成了确定性
没有 Skill 的时候,LLM 每次都"现想"怎么做——有时做得好,有时跑偏。
有了 Skill,执行路径被预定义好了。LLM 只需要触发Skill,不用操心每一步。就像:
没有 Skill:让一个人"随便做顿饭"——他可能煎蛋,也可能煮面,全看心情。有了 Skill:给一张标准菜谱——每次做出来的味道都一样稳。
2. RAG 让 AI 不再"闭卷考试"
传统 LLM 的问题是——它不知道的东西就会编。RAG 从根本上改变了游戏规则:
-
不靠记忆靠检索:
知识存在向量数据库里,随时查、随时更新。
-
答案有出处:
每个回答都能追溯到原始文档,不再是黑盒。
-
本地化部署:
企业机密文档不需要上传到云端,Qdrant 跑在内网就好。
3. Tool 解耦,Skill 可复用
一个 Skill 可以用 10 个不同的 Tool,一个 Tool 也可以被 100 个不同的 Skill 复用。
比如 web_search 这个 Tool:
- “竞品调研” Skill 用它来找竞品信息
- “舆情监控” Skill 用它来搜新闻
- “天气播报” Skill 用它来查天气数据
一次编写,处处复用。
4. Agent 不是模型,而是"模型 + 人设 + 记忆 + 技能 + 知识库"
同样一个 GPT-4o 模型:
- 配上"公众号爆文操盘手"的 SOUL.md → 它是写作专家
- 配上"SRE 工程师"的 SOUL.md → 它是运维专家
- 配上企业知识库(RAG)→ 它成为该领域的专业顾问
模型只是燃料,Agent 才是整车。
5. 五件套 = 无限组合
LLM 决定做什么 ──→ Agent 调度谁来干
│
├── Skill 封装复杂流程
│ └── Tool 执行原子操作
│
└── RAG 提供专属知识
└── embedding → 向量库 → 检索
五、实际案例对比:四层 vs 五层
❌ 只有四层(无 RAG)
用户:”根据公司产品手册第 3 版,我们的定价策略是什么?”
LLM 内心 OS:
”公司手册?我没见过……
可能是按客户规模分层定价?基础版每月 99……
(纯猜测,开始幻觉)”
→ 准确率:低
→ 可信度:零(完全凭感觉编)
✅ 加上 RAG 的五层
用户:”根据公司产品手册第 3 版,我们的定价策略是什么?”
Agent → 触发 RAG Skill
① 将问题向量化
② 在 Qdrant 中检索”定价策略””产品手册v3”
③ 找到手册第 3 版中的 2 个相关段落
RLM(带着检索到的原文):
”根据检索到的产品手册第 3 版第 15 页:
'基础版面向小微企业,定价为每月 99 元……'”
→ 准确率:高(基于真实文档)
→ 可信度:强(附有来源引用)
说真的,这两年看着身边一个个搞Java、C++、前端、数据、架构的开始卷大模型,挺唏嘘的。大家最开始都是写接口、搞Spring Boot、连数据库、配Redis,稳稳当当过日子。
结果GPT、DeepSeek火了之后,整条线上的人都开始有点慌了,大家都在想:“我是不是要学大模型,不然这饭碗还能保多久?”
我先给出最直接的答案:一定要把现有的技术和大模型结合起来,而不是抛弃你们现有技术!掌握AI能力的Java工程师比纯Java岗要吃香的多。
即使现在裁员、降薪、团队解散的比比皆是……但后续的趋势一定是AI应用落地!大模型方向才是实现职业升级、提升薪资待遇的绝佳机遇!
这绝非空谈。数据说话
2025年的最后一个月,脉脉高聘发布了《2025年度人才迁徙报告》,披露了2025年前10个月的招聘市场现状。
AI领域的人才需求呈现出极为迫切的“井喷”态势
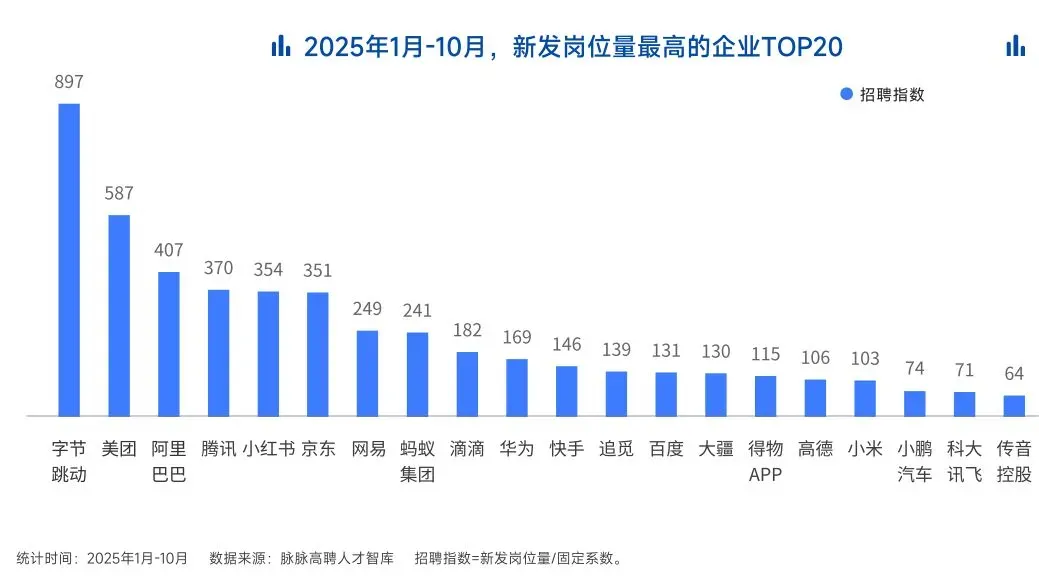
2025年前10个月,新发AI岗位量同比增长543%,9月单月同比增幅超11倍。同时,在薪资方面,AI领域也显著领先。其中,月薪排名前20的高薪岗位平均月薪均超过6万元,而这些席位大部分被AI研发岗占据。
与此相对应,市场为AI人才支付了显著的溢价:算法工程师中,专攻AIGC方向的岗位平均薪资较普通算法工程师高出近18%;产品经理岗位中,AI方向的产品经理薪资也领先约20%。
当你意识到“技术+AI”是个人突围的最佳路径时,整个就业市场的数据也印证了同一个事实:AI大模型正成为高薪机会的最大源头。
最后
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。
我整理出这套 AI 大模型突围资料包【允许白嫖】:
- ✅从入门到精通的全套视频教程
- ✅AI大模型学习路线图(0基础到项目实战仅需90天)
- ✅大模型书籍与技术文档PDF
- ✅各大厂大模型面试题目详解
- ✅640套AI大模型报告合集
- ✅大模型入门实战训练
这份完整版的大模型 AI 学习和面试资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
①从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
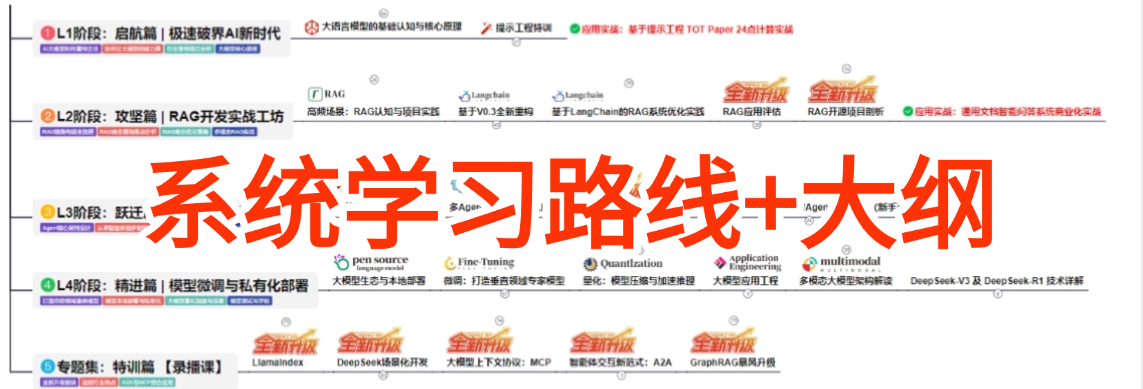
② AI大模型学习路线图(0基础到项目实战仅需90天)
全过程AI大模型学习路线
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
④各大厂大模型面试题目详解
⑤640套AI大模型报告合集
⑥大模型入门实战训练
👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐


 4
 0
- 0


 已为社区贡献7条内容

所有评论(0)