登录社区云,与社区用户共同成长
邀请您加入社区
通过自定义zzg命令将中转站Key导入Shell环境,并配置anya.config.toml文件,实现一键切换Codex使用指定API。执行zzg anya导出密钥后,运行codex --profile anya即可调用对应配置,便捷高效地接入自定义模型服务。
大模型(LLM)如ChatGPT、DeepSeek等,通过海量数据训练形成知识库,以Token为单位处理文本,回答具随机性。其上下文窗口有限,记忆依赖历史对话,超限则遗忘或中断。调用按Token计费,内容越长费用越高。虽能理解指令、生成内容,却无法直接执行操作,需人类介入。Agent技术通过RAG等手段扩展记忆与行动能力,实现“思考+执行”的协同,让大模型真正落地应用。
OpenAI 发布 GPT-6 Astra 并宣告"欢迎进入 AGI 时代";英伟达以 129.3 亿美元收购 Hugging Face 并承诺保持开放;柏林 IFA 开幕、中国品牌占展商近半;ChatGPT/Claude/Grok 集体宕机近 4 小时;工信部印发 AI 中小企业创业支持计划。一文速览昨日科技圈重磅。
第一次用 AI 写代码:Trae 从安装到上手的保姆级教程
实战AI大模型》详细介绍了从基本概念到实践技巧的诸多内容,全方位解读AI大模型,循序渐进、由浅入深。书中配有二维码视频,使读者身临其境,迅速、深入地掌握各种经验和技巧。本书还附带了丰富的额外资源:开源工具和库、数据集和模型案例研究和实际应用、在线交流社区等。读者可以综合利用这些资源,获得更丰富的学习体验,加速自己的学习和成长。《实战AI大模型》是一本旨在填补人工智能(AI)领域(特别是AI大模型)
借着ChatGPT的东风,我们来梳理下prompt范式的相关模型。本系列会以A Systematic Survey of Prompting Methods in Natural Language Processing这篇综述为基础,分门别类的整理下这几年比较有代表性的prompt模型。或许你还以其他形式看到过prompt概念,例如Demonstration,Instruction,In-Cont
聊到这儿,相信你对OpenAI微调API的全链路已经有了一个扎实的认知。从理解RAG的边界,到亲手准备JSONL数据,再到调用API、选型模型、融入RAG流水线,最后守住评估和成本的底线——这一路走下来,你会发现微调并没有传说中那么“高不可攀”,它只是需要你多花一点“业务理解的功夫”。很多新手总把大模型当成一个黑盒,要么盲目崇拜,要么彻底不信。其实它就是一个工具,一个需要你去调教、去磨合、去针对性
MuyuGPT是一个覆盖ChatGPT、Claude、Gemini和Grok的中文AI会员订阅协助与使用指南项目。本文记录我们如何建立产品分类、套餐字段、订单说明、安全文档和内容更新机制,并复盘为什么一套AI订阅知识库必须同时解决信息统一、用户决策和长期维护三个问题。
本文从嵌入式开发者视角实测 DeepSeek v4 flash,横向对比 ChatGPT 与 Claude 在代码生成、驱动解析、内存泄漏排查和技术文档翻译中的表现。测试发现,DeepSeek v4 flash 在基础嵌入式 C 代码、串口驱动分析、Bug 排查等场景表现稳定,核心优势在于极低的 API 调用成本,能显著降低个人开发者和小团队使用大模型的门槛。不过,它目前仍不支持多模态,复杂系统架
ChatGPT是一款高效强大的语言模型,能够给我们的生活带来极大的改变。无论是学习知识还是工作效率,ChatGPT都能为我们提供有力的帮助。它可以帮助我们快速获取所需的知识,同时可以帮助我们提高工作效率,包括写文章、文案、推荐策略、生成代码、写周报,流程图等等。此外,它还可以成为您智能的助手,帮您打理日常事务,如一键预约、贴心提醒等。对于小朋友们来说,他还可以为他们写作文。总之,ChatGPT是一
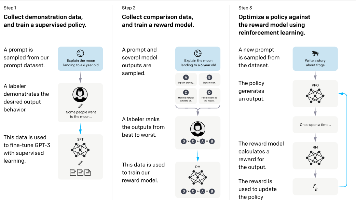
本文是对 OpenAI 于 2022 年 3 月发表在 arXiv 上的论文《Training language models to follow instructions with human feedback》(Ouyang 等,arXiv:2203.02155)的系统性精读。该论文是 ChatGPT 技术路线的直接前身,首次将"基于人类反馈的强化学习"(Reinforcement Learn
AI写作高效工作流:基于Kulaai平台的提示词链实战指南 摘要 本文提出了一套基于Kulaai聚合AI平台的"提示词链"写作工作流,通过将写作流程拆解为规划、生成、精炼三个阶段,显著提升AI辅助写作的效率和质量。核心方法包括: 结构化大纲生成:使用Claude模型构建逻辑严谨的三级大纲 分级内容展开:通过GPT-5.5模型从论证骨架逐步扩展为完整章节 多模型协同润色:结合Gemini的联网核查与
本文介绍了InstructGPT如何通过人类反馈微调语言模型,使其输出更符合用户意图。核心方法分为三步:首先用人工标注的高质量答案对GPT-3进行监督微调(SFT);然后训练奖励模型(RM),通过人类对多个回答的排序学习偏好;最后使用近端策略优化(PPO)算法,让语言模型根据RM的分数不断优化输出。这种SFT+RM+PPO的范式解决了GPT-3仅追求文本续写而忽视用户真实需求的问题,使模型能更好地
这篇论文介绍了InstructGPT,这是从GPT-3到ChatGPT演进的关键一步。核心问题是:大语言模型参数增加并不自动意味着更符合人类意图。作者提出通过人类反馈强化学习(RLHF)来优化模型,包括三个步骤:监督微调(SFT)让模型学会基本回答模式;训练奖励模型(RM)学习人类偏好;使用PPO强化学习进一步优化。实验显示,1.3B参数的InstructGPT在人类评估中优于175B的GPT-3
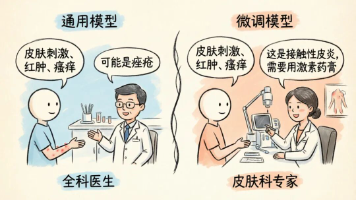
本文系统介绍了AI模型微调技术及其应用价值。微调通过将通用模型(如GPT-3)改造为专用模型(如ChatGPT),显著提升模型在特定任务中的表现。相比提示词工程,微调能让模型真正学习数据而非简单"看到"数据,具有学习新知识、提高输出可靠性、减少幻觉等优势。文章详细阐述了微调的必要性、实施流程(数据准备、训练、评估)、实用技巧及LoRA高效微调方法,并指出微调在隐私保护、成本控制方面的价值。最后强调