登录社区云,与社区用户共同成长
邀请您加入社区
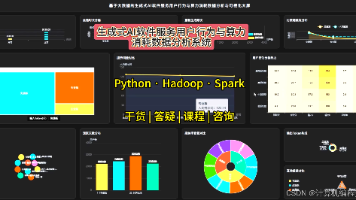
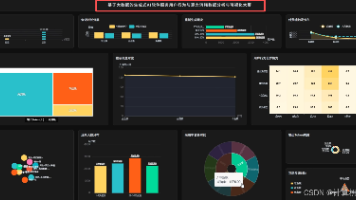
本系统基于Hadoop生态,构建生成式AI SaaS用户行为与算力消耗分析平台,整合9800名用户数据,实现从数据采集、清洗到可视化全链路管理。通过K-Means聚类与关联分析,挖掘用户分群、行为模式及异常算力,结合Echarts大屏与多维看板,直观呈现用户结构、算力消耗、付费转化等核心指标,助力精细化运营与风控决策。技术栈涵盖Python、Django、Spark、MySQL、Vue等,支持定制
本系统是一个基于Spark的生成式AI软件服务用户行为与算力消耗数据分析与可视化系统。技术采用Python语言,依托Hadoop与Spark框架处理海量数据,结合Django和Vue实现前后端搭建。系统覆盖套餐占比、Token消耗、采纳率等分析功能,并融合K-Means、FP-Growth及Isolation Forest算法对用户分群、关联规则与异常算力进行挖掘,最终通过Echarts直观呈现数
本系统是一个基于Hadoop的生成式AI软件服务用户行为与算力消耗数据分析与可视化平台。后端采用Django框架,前端使用Vue和Echarts,大数据层依托HDFS存储与Spark计算引擎。系统实现了套餐占比、活跃分布、Token消耗排行、采纳率差异等12个基础统计分析维度,以及K-Means用户分群、FP-Growth行为关联挖掘、Isolation Forest异常算力识别3个机器学习算法模
本文构建了一套基于HDFS与Spark的生成式AI SaaS用户行为与算力消耗大数据分析系统,涵盖数据上传、预处理、分布式统计、行为挖掘及付费升级预测全流程。通过K-Means聚类、FP-Growth关联规则与Isolation Forest异常检测,实现用户分群与行为模式识别;结合XGBoost模型,对用户付费倾向进行精准预测,输出多维度评估指标与结构化结果,为运营决策提供科学支撑。
2027届计算机毕设应聚焦大模型、多模态、生成式AI、多模型协同与大数据智能预测等前沿方向。推荐100个高含金量选题,涵盖系统类、小程序类、深度学习与大数据四大类别,强调技术亮点、场景落地与数据可得性。避坑普通传统系统,优先选择融合AI创新的课题,确保论文有内容、答辩有亮点,助力一次通过、斩获优秀。
本文整理了2027届毕业设计100个新颖实用选题,涵盖网站系统、小程序APP与大数据分析三大方向。选题聚焦文化传承、社会热点与垂直场景,如宋文化闯关系统、非遗手工艺宣传、反诈平台、智能老年管理、新能源碳足迹追踪及生成式AI算力分析等,避免“图书管理”“外卖平台”等烂大街题目,强调创新性、落地性与答辩亮点,助力学生高效选题、脱颖而出。
基于Spark的生成式AI用户行为分析与算力异常检测研究是基于 Hadoop/HDFS 与 Spark 构建,实现用户行为与算力消耗数据的上传、清洗、预处理和分布式统计分析,围绕用户套餐、近30天活跃天数、会话时长、提示词数量、输入/输出 Token、重新生成率、采纳输出率、点赞点踩、配额使用率和付费墙触发次数等指标生成多维分析结果,并通过 K-Means 用户行为分群、FP-Growth 关联规
Agent Loop 有一个非常现实的问题:每做一次 Tool Call,都可能产生新的 Context。读取文件运行 Test读取另外一个文件搜索代码Git DiffContext↓越来越大。