
想做行业垂直大模型,可能卡在数据上
第四种:合成数据。
合成,这个词儿,大家肯定不陌生。它指的是人工造出来的,不是自然产生的。
比如,你穿的衣服,布料可能是合成纤维,不是棉花羊毛这些天然材料;
比如,你吃的糖果,可能加了合成甜味剂,不是从甘蔗里榨出来的糖;
再比如,你听的音乐,可能用了合成器音色,不是真实乐器弹出来的。
……
这些“合成”的东西,不是“假的”。它们只是说明了,有些东西不是直接来自现实,而是通过某种方式“造”出来的。
合成数据,道理也一样。
合成数据,就是为了特定目的,用算法、模型或仿真环境生成的、不是从真实世界直接采集的数据。
简单说,就是用算法“造”出来的数据。
它不来自真实世界的记录,而是通过生成模型、仿真引擎等方式,人工创造出符合真实数据统计规律和结构特征的“虚拟数据”。

比如,你想训练一个医疗影像诊断模型。但某种罕见病的片子,全国一年也就十几个,你拿不到足够多的样本。
怎么办?
你用算法生成不同大小、不同形态、不同位置的病灶,各种年龄段、各种背景的虚拟病理影像。这些影像,不是从真实病人身上拍的,是“造”出来的,但它们可以用来训练模型。
这就是合成数据。它的核心逻辑就是:当真实世界给不了足够的数据时,你就要自己“造”。
一句话,数据不够,AI来凑。
那,AI是怎么“凑”出来的?
合成数据,常见的生成方式,有以下几种。
第一种,生成式AI合成。
这是目前最主流的“数据合成”的方式。
它的原理不复杂,简单说就是:让AI先看大量的真实数据,从里面学会“规律”,然后根据这个规律,造出新的数据。
专业一点的描述,是这样的:用GAN、扩散模型这些生成式AI技术,从真实数据里学习分布规律,然后生成全新的、不重复的样本。
举个栗子。
你先给AI看几千张真实的缺陷图片,它从这些图里学会了“缺陷长什么样”、“正常长什么样”、“缺陷有哪些类型”。
然后,它根据学到的“规律”,生成新的图片。而这些新图片,跟真实图片不一样,但符合真实图片的“规律”。
这种合成方式,比较适合“你已经有了一部分真实数据,但不够多,不够全”的场景。AI模型从你已经有的真实数据里学到规律,然后帮你“扩写”出更多数据样本。
那,如果你没有真实数据,该怎么合成呢?
这就是“仿真引擎合成”要做的事儿,咱们往下看。

第二种,仿真引擎合成。
什么叫仿真?
仿真,就是用一个虚拟的“副本”,来模拟真实世界。它不是真的,但它是按照真实世界的物理规律来运行的。
比如,飞行模拟器。
飞行员,不会一上来就开真飞机的。他先在一个虚拟驾驶舱里练。这个虚拟驾驶舱里的仪表盘、操纵杆、窗外风景,全都是根据真实世界的物理规律,模拟出来的。你拉杆,飞机就抬头;你推杆,飞机就俯冲……几乎跟真飞机一样。
这个虚拟驾驶舱,就是一种仿真。

那,什么又叫引擎?
这里的“引擎”,指的不是“发动机”,而是一套核心程序,负责驱动整个虚拟世界运转。
你玩过赛车游戏吧?车会打滑、会撞坏、会漂移……这些不是事先拍好的动画,是“游戏引擎”实时算出来、渲染出来的。它根据物理规律,算出塞车该怎么动、轮胎该怎么滑、车身该怎么变形……。
这里的“游戏引擎”,就是一种仿真引擎。
所以,仿真引擎合成,就是按真实世界的物理规律,在电脑里建一个运行的虚拟世界,让虚拟的机器、车辆、设备、人,在这个虚拟世界里面运行,从而生成数据。
它本质上就是:在电脑里,造一个跟真实世界一样讲物理规律的“平行世界”。然后,在这个平行世界里做实验、跑数据。

举个栗子。
比如,你建一个虚拟工厂,让虚拟机器人在里面抓取零件。机器人每次抓取的动作、力度、角度、结果,都被记录下来。抓成功是数据,抓失败也是数据。
这就是仿真引擎合成。
这种方式,比较适合那些真实世界里“试错成本太高”,或“根本试不了”的场景。
像自动驾驶、机器人、工业制造等这些场景,你不可能为了训练一个模型,真的去撞车,去搞真实破坏,去制造事故的。
可以说,仿真引擎合成的最大优势,是把“试错”这件事的成本,几乎降到零。
你想让车撞一万次,就撞一万次,不用赔一分钱。你想让设备坏一百次,就坏一百次,不用担心停产。
但它也有个根本性问题,那就是:即便虚拟世界非常趋近真实世界,但两者还是有区别的。这种差别,就是“虚实鸿沟”。

比如,你模拟的摩擦力、接触力、物体形变,是用公式算出来的。而真实世界里的这些力,受到的影响因素无数且复杂,两者不可能百分百一样。也就是说,你在虚拟世界里练得再好,到了真实世界,还有可能会废掉的。
所以你看,仿真引擎合成,没有真实数据也能生成。但生成的数据,要靠真实数据来校验的。
也就是说,你不需要先有几千条真实数据才能合成。你可以建个虚拟场景,设好物理参数,让虚拟设备、车、机器人跑起来,它们跑起来的每一条数据,都是合成的。
但是,跑出来的数据,能不能用,好不好用,还得拿到真实世界来验证的。对不上,那就调参数;调完后,再跑一遍……直到趋于接近真实。
这就是仿真引擎合成的核心逻辑:先在虚拟世界里“造”,再拿到真实世界里“校”。
不过,建这个虚拟世界,本身就是一个大工程。你要建模、要设置参数、要调物理引擎,投入肯定不小。
所以,不是所有“没有真实数据”的场景,都值得这么干的。
那,有没有一种方式,不需要建虚拟世界,不需要生成式AI,就能快速“造”出数据?
有,这就是第三种方式:数据增强合成。
第三种,数据增强合成。
这种方式,是最简单、成本最低的。
它不需要生成式AI,不需要虚拟世界,只需要对已有的真实数据“动动手脚”。
什么意思?
比如,你有一张真实的缺陷图片。你可以把它旋转一下,生成一张“新”的图片;你可以把它裁剪一下,生成另一张“新”的图片;你还可以把它调亮一点、调暗一点、加点噪声、改个对比度……这样就能生成几十张“新”的图片。
这些图片,本质上还是那张真实的缺陷图片。但是,模型看到的却是“不同角度、不同亮度、不同裁剪”的版本。模型学到的,是“这个缺陷图片,在不同条件下都长这样”。
这种合成方式的核心逻辑是:不创造新的“内容”,只创造新的“变体”。就是说,它不改变数据的本质,只改变数据的形式。
旋转、裁剪、调色、加噪、换词、改句式……这些都是“变换”。变换完了,数据还是那个数据,但模型看到的样本变多了。

数据增强合成,它适合什么场景?
适合你已经有一批真实数据,但数量不够多、多样性不够好。你不需要像“生成式AI合成”那样,“造出”新的东西,你只需要把已有的东西“变一变”,让模型看到更多的可能性。
比如,你想训练一个图像识别模型,但手头的图片太少。你可以把现有的每张图,旋转、裁剪、调色……这样,你就可以生成几十倍的样本量。
比如,你想训练一个文本分类模型,但训练数据不够。你可以把现有的每句话,换同义词、改句式、调语序……这样就能生成几十倍的样本量。
这种方式的优势,比较明显:简单、快速、成本低。你不需要复杂的技术,不需要大量的算力,不需要虚拟环境。
当然,它也有局限,主要体现在以下几个方面。
第一,多样性有限。
你旋转、裁剪、调色……变来变去,还是那张图。模型学到的,还是那个缺陷、那个场景、那个模式。你的这些动作,变不出真正“新”的东西。
第二,可能引入噪声。
亮度调得太狠,图片很可能失真;换同义词换得不准确,语义很可能变了……你的这些“变体”,不但没帮上忙,反而给模型投喂了“假数据”,引入了噪声。
第三,它只能解决“量不够”,解决不了“质不够”。
这种方式只是增加了“形变”,没增加“神变”。如果你缺的是“罕见缺陷样本”,那数据增强帮不了你。因为,你手里根本就没有那个罕见缺陷的数据,再怎么增强,也变不出来。

所以,数据增强合成,适合的场景,就是我上面说的:有数据,但不够多,尤其是多样性”的情况,它不适合“根本没数据”的情况。
OK,到这里,合成数据常见的几种主流的合成方式,聊完了。
简单总结下:生成式AI合成,是从真实数据里学,然后“创作”;仿真引擎合成,是在虚拟环境里“模拟”,然后在真实环境“校验”;数据增强合成,是对已有数据做“变换”,然后“扩写”,它不是“变种”,解决不了“质不够”。
你看,每种方式,都有它的适用边界。选哪种,取决于你有什么、你要什么、你的场景是什么。
另外,合成数据,它不是用来“取代”真实采集的,它是用来“补齐”真实采集做不到的事儿。两者不是替代关系,是互补关系。
那,合成数据值不值得用,取决于它的“性价比”判断。
第一,你的真实数据够不够用? 够用就不需要合成。不够用,才需要考虑;
第二,你缺的数据是“量”还是“质”? 缺量,合成数据可以补;缺质,合成数据不一定能解决。因为,合成数据只能模仿真实数据的分布,如果真实数据的质量本身就有问题,合成数据只会把问题放大;
**第三,你有能力验证合成数据的质量吗?**如果没有验证手段,造出来的数据就是“盲盒”——你不知道它好不好,你只能赌。
**总之,合成数据是工具,不是魔法。**它能解决真实数据解决不了的问题,但它也会带来真实数据不会带来的新问题。
用得对,事半功倍;用不对,事倍功半。
这就是合成数据。
到这里,开源数据集、企业自有数据、专业采集、合成数据,我们聊完了。放在一起看,你会发现:它们都是“自己动手”采集,走的都是“自力更生”的路子。
自力更生,很好。但它们是有天花板的,你不可能什么都自己捡、自己盘,自己采,自己造。
有些数据,你还是采不到、造不出、盘不出来的。
那,这时候,最划算的方式,可能不是“自己动手”,而是“花钱买”。
这就是数据获取的最后一条路径:数据采购。
那,数据采购怎么“采”?和前面几种有什么不同?
AI行业迎来前所未有的爆发式增长:从DeepSeek百万年薪招聘AI研究员,到百度、阿里、腾讯等大厂疯狂布局AI Agent,再到国家政策大力扶持数字经济和AI人才培养,所有信号都在告诉我们:AI的黄金十年,真的来了!
在行业火爆之下,AI人才争夺战也日趋白热化,其就业前景一片蓝海!
我给大家准备了一份全套的《AI大模型零基础入门+进阶学习资源包》,包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。😝有需要的小伙伴,可以VX扫描下方二维码免费领取🆓
人才缺口巨大
人力资源社会保障部有关报告显示,据测算,当前,****我国人工智能人才缺口超过500万,****供求比例达1∶10。脉脉最新数据也显示:AI新发岗位量较去年初暴增29倍,超1000家AI企业释放7.2万+岗位……
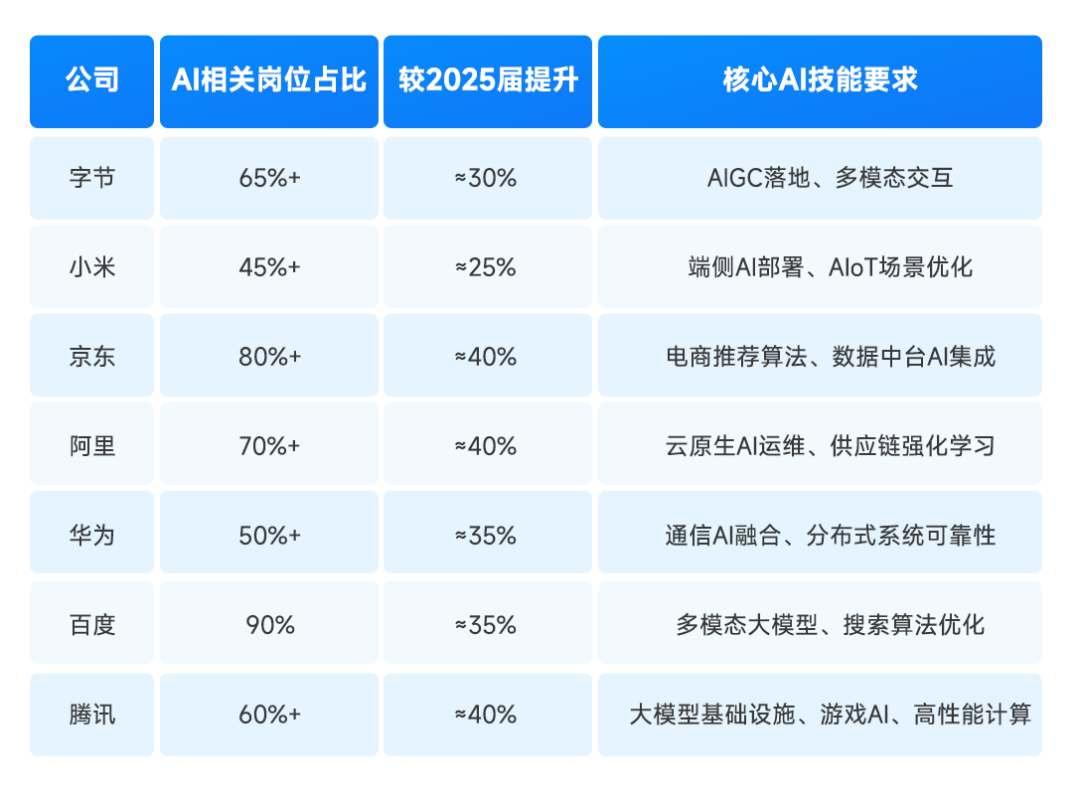
单拿今年的秋招来说,各互联网大厂释放出来的招聘信息中,我们就能感受到AI浪潮,比如百度90%的技术岗都与AI相关!
就业薪资超高
在旺盛的市场需求下,AI岗位不仅招聘量大,薪资待遇更是“一骑绝尘”。企业为抢AI核心人才,薪资给的非常慷慨,过去一年,懂AI的人才普遍涨薪40%+!
脉脉高聘发布的《2025年度人才迁徙报告》显示,在2025年1月-10月的高薪岗位Top20排行中,AI相关岗位占了绝大多数,并且平均薪资月薪都超过6w!
在去年的秋招中,小红书给算法相关岗位的薪资为50k起,字节开出228万元的超高年薪,据《2025年秋季校园招聘白皮书》,AI算法类平均年薪达36.9万,遥遥领先其他行业!
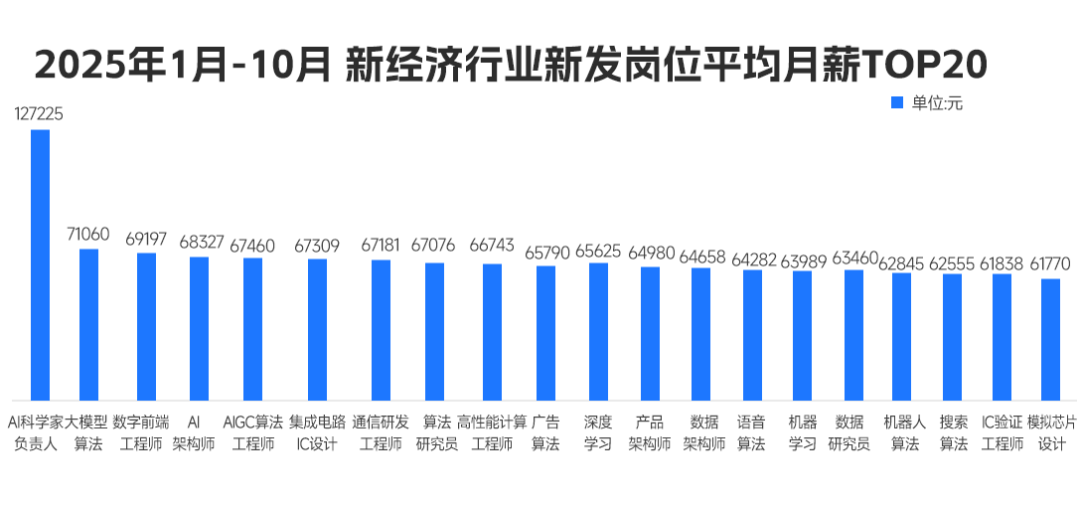
总结来说,当前人工智能岗位需求多,薪资高,前景好。在职场里,选对赛道就能赢在起跑线。抓住AI风口,轻松实现高薪就业!
但现实却是,仍有很多同学不知道如何抓住AI机遇,会遇到很多就业难题,比如:
❌ 技术过时:只会CRUD的开发者,在AI浪潮中沦为“职场裸奔者”;
❌ 薪资停滞:初级岗位内卷到白菜价,传统开发3年经验薪资涨幅不足15%;
❌ 转型无门:想学AI却找不到系统路径,83%自学党中途放弃。
他们的就业难题解决问题的关键在于:不仅要选对赛道,更要跟对老师!
我给大家准备了一份全套的《AI大模型零基础入门+进阶学习资源包》,包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。😝有需要的小伙伴,可以VX扫描下方二维码免费领取🆓
AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 2
 0
- 0


 已为社区贡献10条内容

所有评论(0)