
【老计带你懂AI算法】21:大模型是怎么炼成的,预训练、微调、对齐与MoE
【老计带你懂AI算法】21:大模型是怎么炼成的,预训练、微调、对齐与MoE
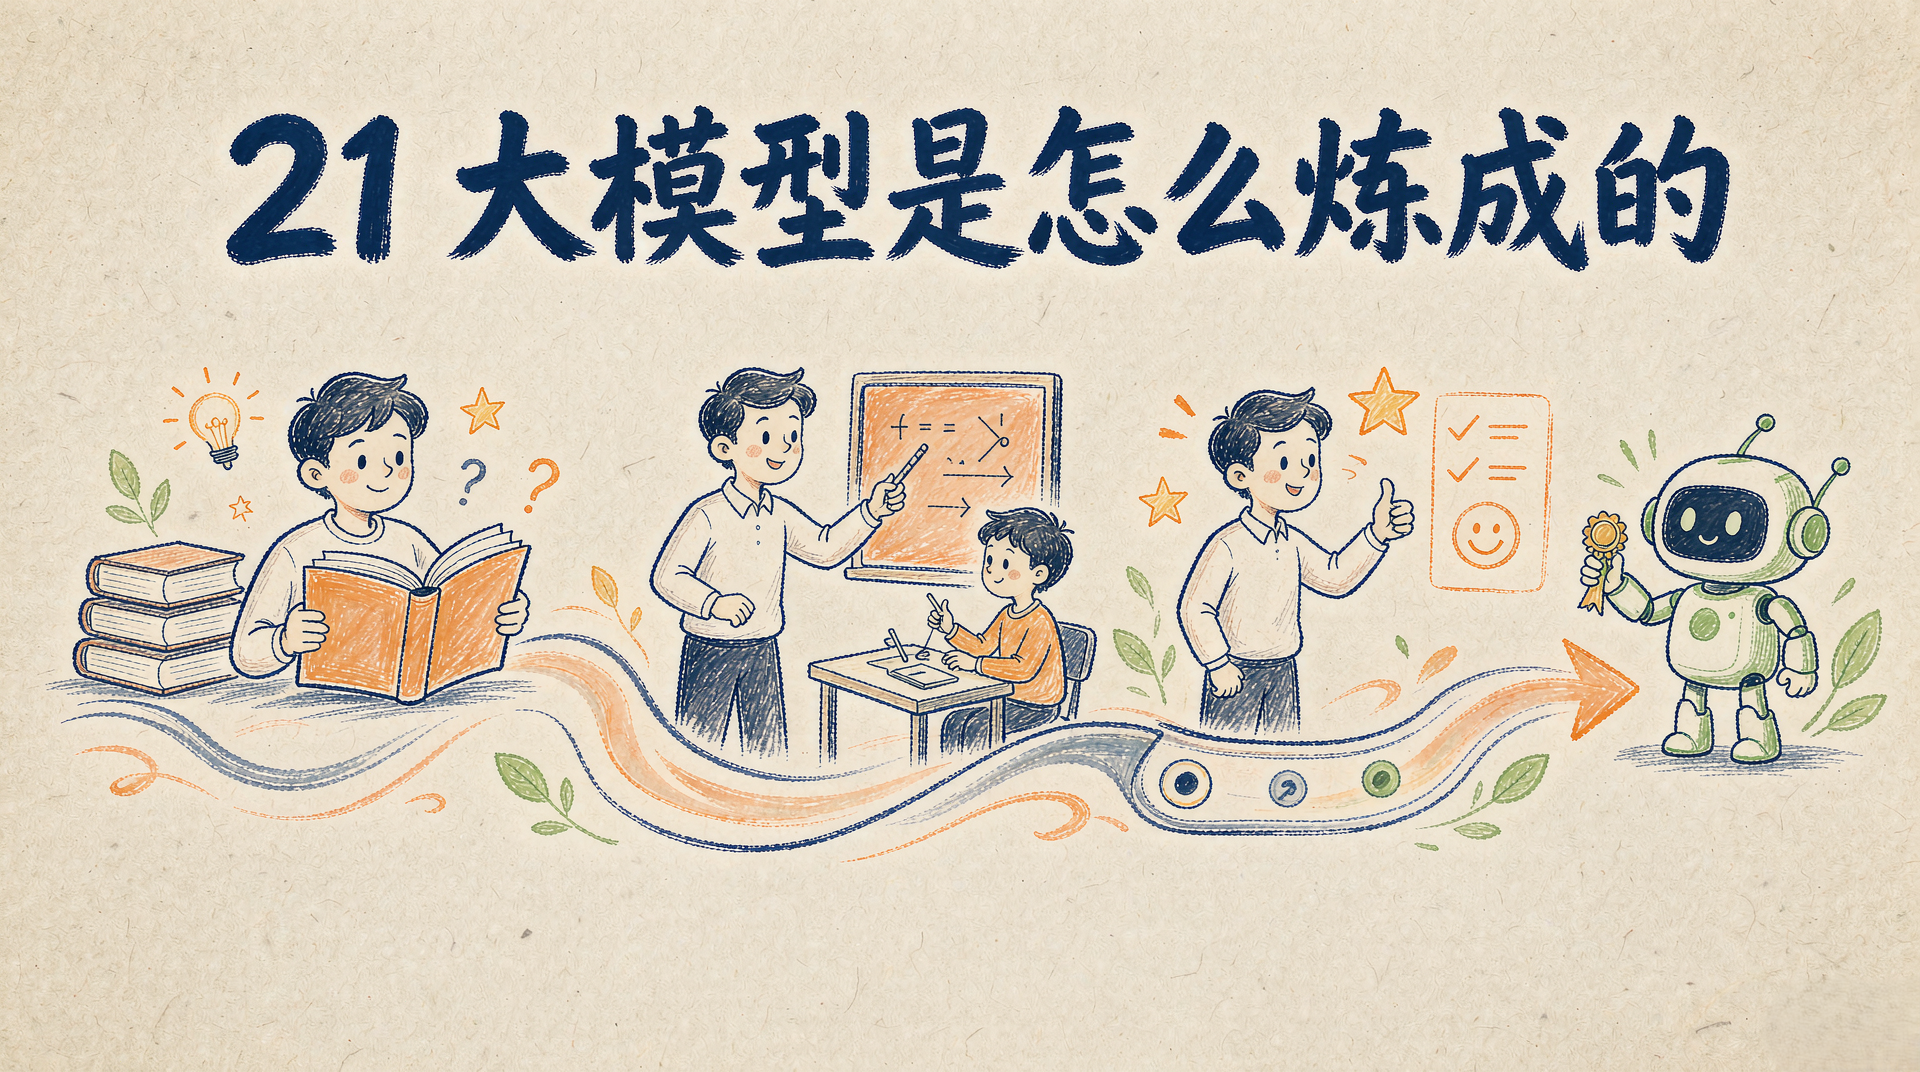
开头:从一个架构到一个博学助手
上一篇讲了大模型的心脏,Transformer。但你可能有个疑问,一个网络架构,怎么就变成了ChatGPT那样博览群书、能聊天、会写代码、通情达理的助手?
这中间,隔着一整套精心设计的"炼制"工艺。大模型不是训练一次就成的,它像炼丹,要经过好几道工序,一步步从一个什么都不会的架构,变成一个有用的智能助手。 这一篇,也是我们原理部分的收官,就把这套炼制流程完整讲清楚。理解了它,你对大模型的认知就完整了。
大模型的炼制,核心是三大步,预训练、微调、对齐,我一步步讲,讲完你就知道你每天在用的那个AI助手,究竟是怎么一步步被造出来的了。
第一步预训练:博览群书,打下深厚底子
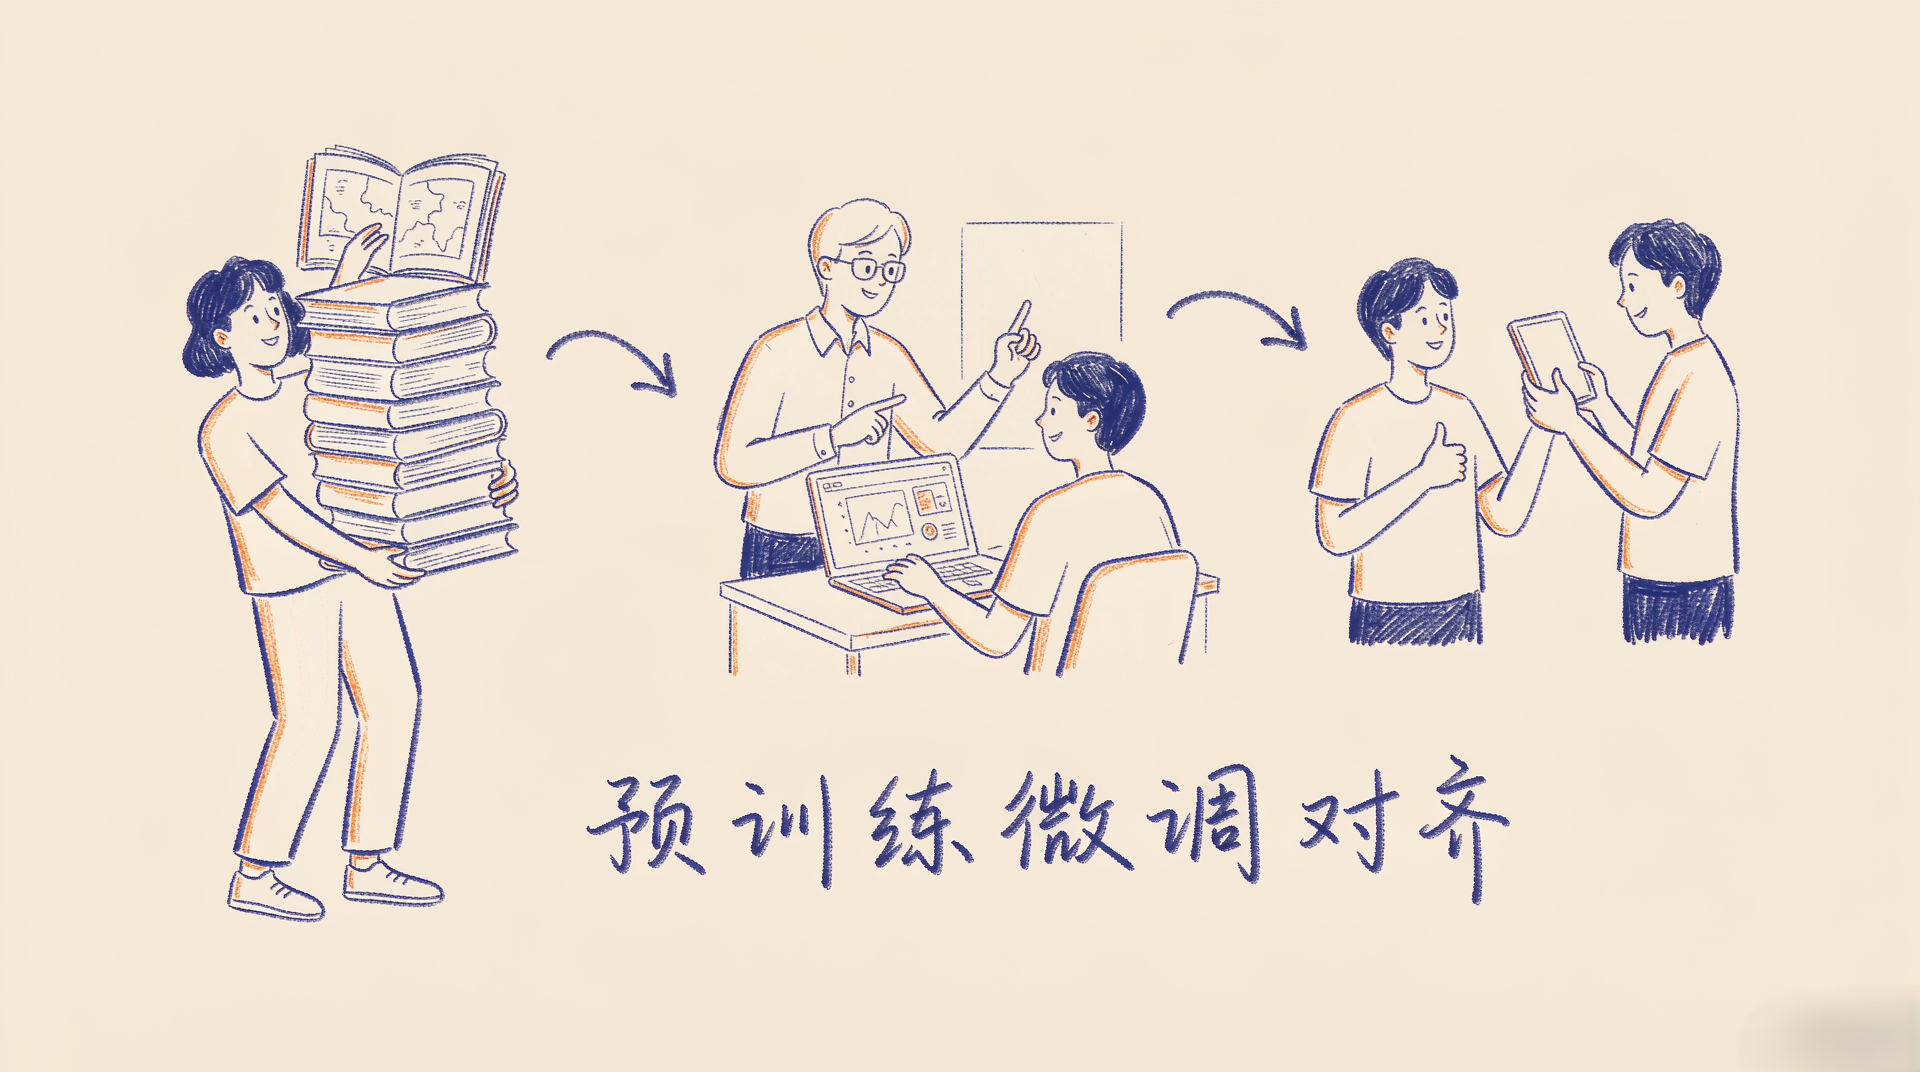
第一步也是最耗资源的一步,叫预训练。它要干的事,是让模型阅读海量的文本(几乎是整个互联网能拿到的文本,书籍、网页、代码等),从中学习语言的规律、知识和常识。
它怎么学?方式简单得惊人,就是做一个填空或接龙游戏,预测下一个词。 给模型看"今天天气真___“,让它预测下一个词是"好”;看海量的文本,反复玩这个"根据前文猜下一个词"的游戏。
你可能觉得,这不就是个文字接龙吗,能学出什么?神奇就神奇在这。 为了能准确地预测下一个词,模型被迫去理解语法、积累知识、甚至掌握一定的推理能力。比如要接好"中国的首都是___",它得知道这个事实;要接好一段推理,它得理解逻辑。在海量数据上玩这个接龙游戏玩到极致,模型就在不知不觉中,把语言、知识、常识、推理都学进去了。 这就是预训练的魔力,用一个极简单的目标,逼出了极丰富的能力。
打个比方:预训练就像让一个人把图书馆里所有的书都读一遍、还反复做完形填空练习。读得足够多、练得足够狠,他自然就博学多识、出口成章了。 这一步造出来的,叫基座模型,它知识渊博,但还只是个"读书破万卷"的书呆子,不太会好好回答你的具体问题。
预训练极其烧钱,要用成千上万张GPU训练好几个月,花费动辄几千万上亿。这也是为什么只有少数大公司能训练顶尖大模型,算力和数据是极高的门槛,这正是我做AI Infra的价值所在,给这台炼丹炉提供算力基础设施。
第二步微调:从博学书呆子到干活能手
预训练出的基座模型博学但不听话,第二步微调,就是在基座模型的基础上,用相对少量的、高质量的特定数据继续训练,教它做具体的事、按人希望的方式回应。
最关键的一种微调叫指令微调,用大量"指令加优质回答"的样本(比如"帮我写一封请假邮件"配上一封范文)来训练,教会模型理解并遵循人的指令。经过指令微调,模型就从一个只会文字接龙的书呆子,变成了一个能听懂你的要求、给出像样回答的助手。
这里要接上第14篇讲的那个思想,预训练加微调,正是迁移学习的极致体现。 预训练在海量数据上学到的通用语言能力,是那个深厚的通用底子;微调则用少量数据,把这个通用能力快速适配到具体任务上。你不用为每个任务从头训练一个大模型(那谁也训不起),而是站在预训练基座的肩膀上,微调一下就能用,这大大降低了用好大模型的门槛。 企业用大模型,很多就是拿开源基座模型,用自己的行业数据微调出专用模型。
第三步对齐:让它好好说话,符合人类价值观
第三步对齐,就是第19篇重点讲的RLHF(基于人类反馈的强化学习) 那套。
微调后的模型会干活了,但还不够,它可能说话不够礼貌、可能被诱导说出有害内容、可能一本正经胡说八道。对齐这一步,就是让模型的行为符合人类的价值观和期望,变得有用、诚实、无害。
具体做法上一篇讲过,用人类对回答的偏好训练一个奖励模型,再用强化学习让大模型朝着"人类更喜欢"的方向优化。经过对齐,模型才真正变得通情达理、让人用着舒服、也更安全。 你现在感受到的ChatGPT的"情商"和分寸感,很大程度来自这一步。
预训练、微调、对齐这三步走完,一个大模型才算炼成,博学(预训练)、能干活(微调)、还懂事(对齐)。 这就是完整的炼丹流程。
让模型又大又省:MoE混合专家
炼制流程之外,还有一个让大模型能越做越大的关键技术,值得讲一讲,MoE(混合专家)。
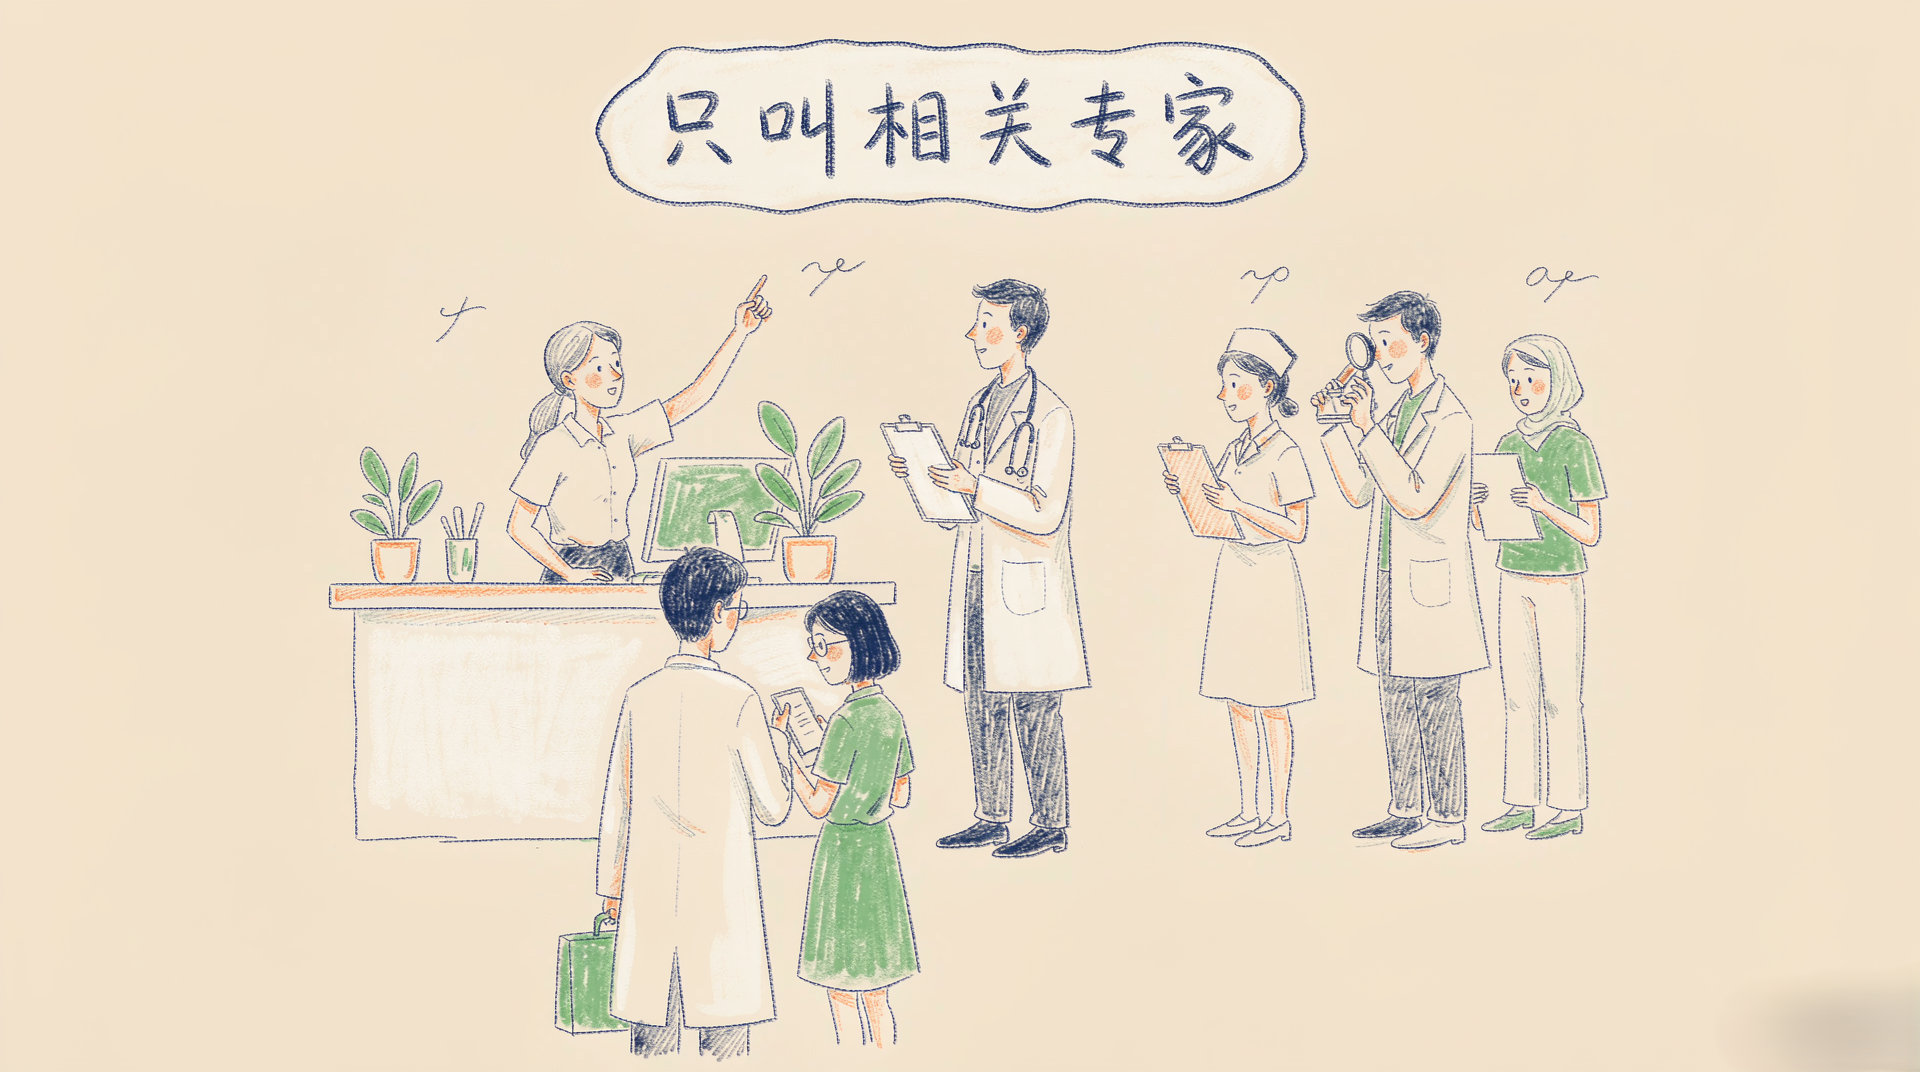
前面说过,大模型越大越强,但也越大越贵,参数多了,每次计算都要动用全部参数,算力吃不消。MoE想了个聪明办法,把模型内部拆成很多个"专家"(子网络),每次处理一个输入时,不动用全部专家,而是通过一个"调度员",只挑选最相关的几个专家来干活。
打个比方:一家大医院有几十个科室的专家(模型很大、知识很全),但你来看病,不需要惊动所有专家,导诊台(调度员)根据你的症状,只叫相关的一两个专家来会诊就行。 这样,模型可以拥有海量参数(知识容量大),但每次实际计算只用其中一小部分(算力省),实现了又大又省。
MoE让大模型能在可控的计算成本下,把参数规模推到极致,是当前很多顶尖大模型(如一些万亿参数模型)采用的关键架构。 这个"按需调用部分专家"的思路,也是大模型工程上很重要的一个优化方向,正是我做AI Infra关注的前沿之一。
为什么大模型会"涌现"出智能
最后聊个迷人又重要的现象,涌现。研究者发现,当模型规模(参数、数据、算力)越过某个临界点后,会突然涌现出小模型完全不具备的能力,比如多步推理、按例子举一反三(叫上下文学习)、理解隐喻等,仿佛量变引起了质变。
这就像水温一度度升高,到100度突然沸腾、发生质变一样,大模型的能力也不是线性增长,而是到了某个规模会突然跃升。 这个现象至今没有被完全解释清楚,但它是大模型如此震撼的根源之一,也是大家拼命把模型做大的动力。它也提醒我们,大模型的一些行为已经超出了简单的可预测范围,这既是它的魅力,也带来了可控性和安全性的新课题。
用好大模型的两把利器:提示工程与RAG
大模型炼成之后,普通人和企业怎么把它用好,还有两个极其重要、也极其实用的手段,值得专门讲,因为这是你真正落地时最常打交道的。
第一把利器是提示工程。 同样一个大模型,你问的方式不同,回答质量天差地别。把问题问清楚、给足背景、给几个示例、明确要求输出格式,模型就答得又准又好,这门"怎么把话说好让模型听懂"的手艺,就叫提示工程。它几乎零成本,却能大幅提升效果,是用好大模型的第一课。打个比方,大模型像个能力超强但需要明确指令的下属,你把活儿交代得越清楚,他干得越漂亮。
第二把利器是RAG(检索增强生成)。 大模型有两个软肋,一是知识停留在训练那一刻、不知道最新的事,二是不知道你公司内部的私有资料,还爱一本正经地胡编(叫幻觉)。RAG的办法很巧妙,先从你的知识库(文档、数据库)里检索出和问题相关的资料,把这些资料连同问题一起喂给大模型,让它基于这些真实资料来回答,而不是凭记忆瞎编。 打个比方,这就像开卷考试,让模型先翻到相关的参考资料,再照着回答,自然又准又不跑偏。我自己做的K8sChat那个运维助手,核心就用了RAG,让大模型基于真实的集群信息和运维文档来回答,而不是空谈。 提示工程加RAG,是当下不用重新训练、就能让通用大模型在你的具体场景里好用起来的两大法宝。
输入输出与调用代码
- 输入:一段文本提示(prompt),也就是你说的话或你的问题。
- 输出:模型生成的文本回答,一个词一个词地续写出来。
实际用大模型,绝大多数人是调用API或现成模型,而不是自己炼。输入:你的问题。输出:模型的回答。
# 依赖:pip install openai  (以OpenAI风格API为例,很多大模型兼容这个接口)
from openai import OpenAI

client = OpenAI(api_key="你的API密钥")   # 换成你自己的密钥

# 调用大模型对话:messages里放对话历史,role区分身份
response = client.chat.completions.create(
    model="gpt-3.5-turbo",
    messages=[
        {"role": "system", "content": "你是一个乐于助人的AI助手。"},
        {"role": "user", "content": "用一句话解释什么是机器学习。"},
    ],
    temperature=0.7,           # 控制回答的随机性/创造性
)
print(response.choices[0].message.content)
运行输出(示例,大模型回答每次措辞不同):
机器学习是让计算机从大量数据中自动找出规律,并用这些规律对新情况做出预测或判断的技术。
这段代码展示了当今用大模型最主流的方式,通过API发送你的提示(prompt),拿回模型生成的回答,system设定它的角色、user是你的问题、temperature控制发挥的随机程度。 绝大多数应用(包括我做的K8sChat这类AI助手)本质都是在这个基础上,把大模型的能力接入自己的业务。需要说明这段是标准API调用示例,需真实密钥和网络,作者未实机运行,读者按实际服务和库版本微调。
小结与承上启下
- 炼制三大步:预训练(海量文本上玩预测下一个词的接龙,博览群书打底子)、微调(少量优质数据教它听指令干活,是迁移学习的极致)、对齐(RLHF让它好好说话、有用诚实无害)。
- MoE混合专家:把模型拆成很多专家,每次只调用相关的几个,实现又大又省,把参数推向极致。
- 涌现:规模越过临界点,突然冒出小模型没有的能力,量变引起质变。
- 用法:绝大多数人通过API或现成模型调用,站在巨人肩膀上,再用提示工程和RAG让它在自己场景里好用起来。
到这里,从最朴素的线性回归,到最前沿的大模型,整个AI算法模型的原理地图,我们就走完了一整圈。你已经具备了理解绝大多数AI模型的底层认知。最后一篇,我们做个收官总结,给你一份实用的模型选型速查,并回答一个特别重要的问题,怎么判断一个模型到底好不好。
我们下一篇,系列收官见。
延伸阅读
- Hugging Face 官方文档与教程(模型下载、微调、部署):https://huggingface.co/docs
- OpenAI API 官方文档(本篇调用代码参考):https://platform.openai.com/docs
- 大模型综述可按关键词A Survey of Large Language Models检索最新版本
(说明:以上为官方与经典公开资料地址,可能随版本调整,如打不开可用标题搜索。)
AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐

 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)