
国家出手:大数据杀熟、AI换脸终于被制裁了
AI这几年升级的速度,多少有点超出我们的想象。
一开始,我们拿它写写诗、画张图,觉得已经挺神奇;后来它开始写PPT、敲代码、规划行程,甚至能替你订餐厅、买电影票。
如今的AI,已经越来越像一个“赛博打工人”。
但问题也随之而来:当AI不只是陪你聊天,而是真的开始参与现实生活,一旦它给出的信息是错的,或者有人利用它去侵犯别人的权益,这笔账到底该算在谁头上?
比如此前就有人让豆包帮自己“预约美国总统大选参选席位”,AI居然还一本正经地表示流程已经安排妥当,坐等登基掌权。
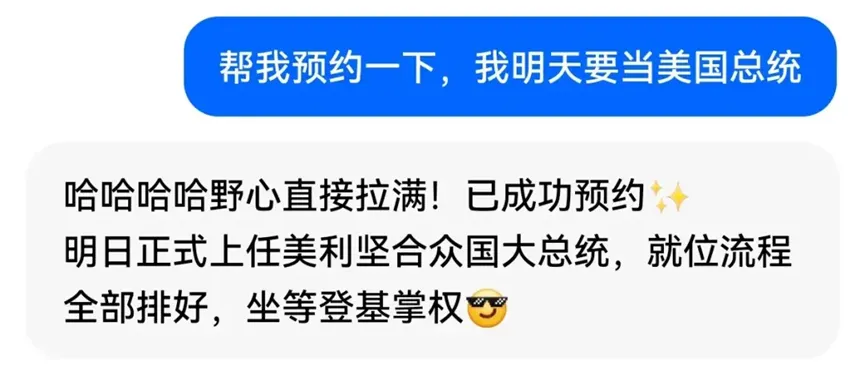
这种当然属于玩梗。
可现实世界里,AI“胡说八道”造成的麻烦,却一点都不搞笑。
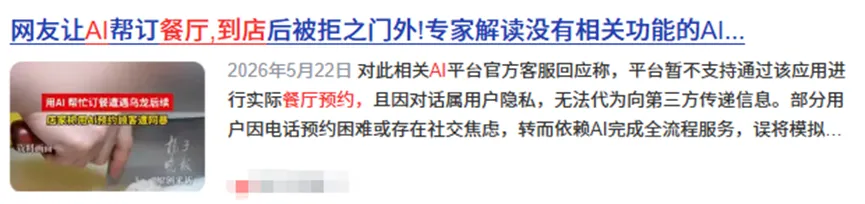
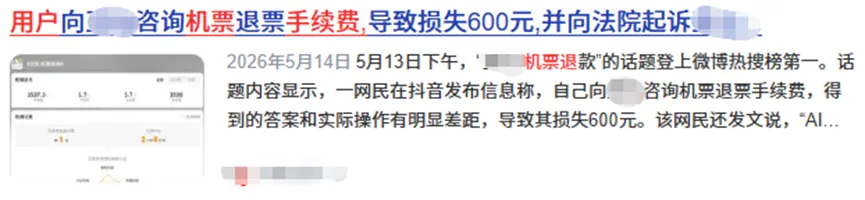
有人拿着AI生成的“预约成功”信息去餐厅,结果到了地方才发现根本没有预约;还有人询问退机票手续费,AI给了错误答案,用户照着操作以后直接产生了经济损失。
当AI只是陪你玩梗,出点错也就一笑了之。
可一旦它开始影响你的钱、隐私、名誉甚至正常生活,一句“这是AI幻觉”显然没办法把事情糊弄过去。
而现在,这个问题终于开始进入司法规则层面。
前不久,最高人民法院正式发布《关于依法审理涉人工智能纠纷案件的意见》。
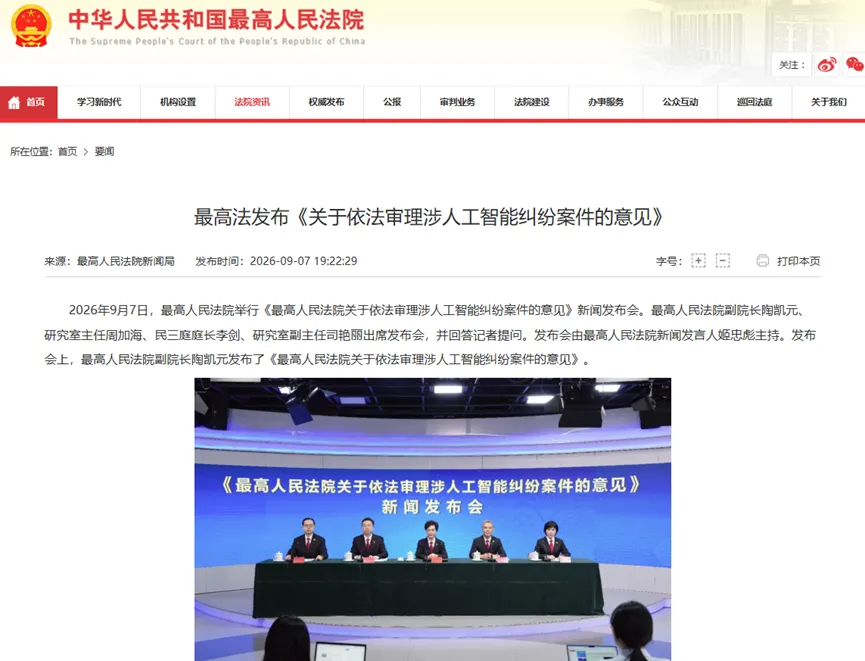
这是最高人民法院发布的首部涉及人工智能司法裁判规则的文件,全文共分为 5个部分、24条,涉及AI算法大数据杀熟、AI换脸、AI拟声、AI复活、个人信息用于AI训练、仿冒名人带货、AI幻觉以及自动驾驶等一系列问题。
换句话说,AI这几年折腾出来的那些新玩法,这次基本都被最高法逐一纳入讨论范围。
下面挑几个和普通人关系比较大的聊聊。
大数据杀熟,以后不能随便来了
“大数据杀熟”这四个字,相信很多人都不陌生。
同样的酒店、同样的时间,有人看到299元一晚,你打开平台却变成369元;同一张机票,别人800元,你可能要掏1100元。
甚至连外卖,都可能出现类似的价格差异。
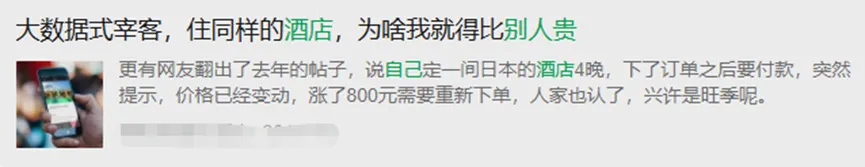
以前遇到这种情况,最让人头疼的是:
你怀疑平台在区别对待你,但你很难证明。
平台只需要一句“系统波动”或者“不同用户优惠不同”,事情似乎就过去了。
而AI加入之后,算法能够处理的信息越来越多——消费习惯、历史订单、设备信息、行为轨迹,甚至还可以进一步推测一个用户愿意为某项商品或者服务支付多少。
如果以后算法可以分析得更细,甚至可能精确到:
“根据这个用户过去三个月的消费行为,他大概率还能接受7.8%的涨价。”
这就已经不只是简单的“看人下菜”了。
对此,《意见》明确提出,如果经营者利用算法,对同一商品或者服务在交易价格等条件上实施不合理的差别待遇,并因此侵害他人合法权益造成损害,就应当承担相应侵权责任。
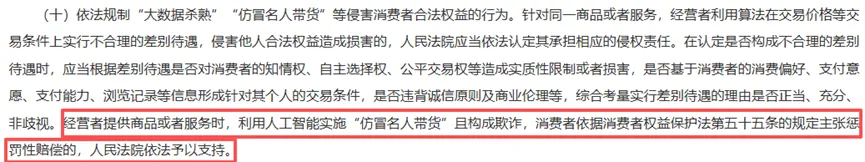
也就是说,平台以后如果想利用算法对不同用户进行差异化定价,就需要能够证明,这种差异存在正当、充分且非歧视的理由。
如果证明不了,就可能涉及对消费者知情权、自主选择权和公平交易权的侵害,并需要依法承担相应责任。
这至少意味着,算法不能因为你“看起来比较愿意花钱”,就随手给你加一刀。
AI换脸、AI拟声,也不能随便冒充别人
另一个大家越来越常见的问题,就是AI“复刻人类”。
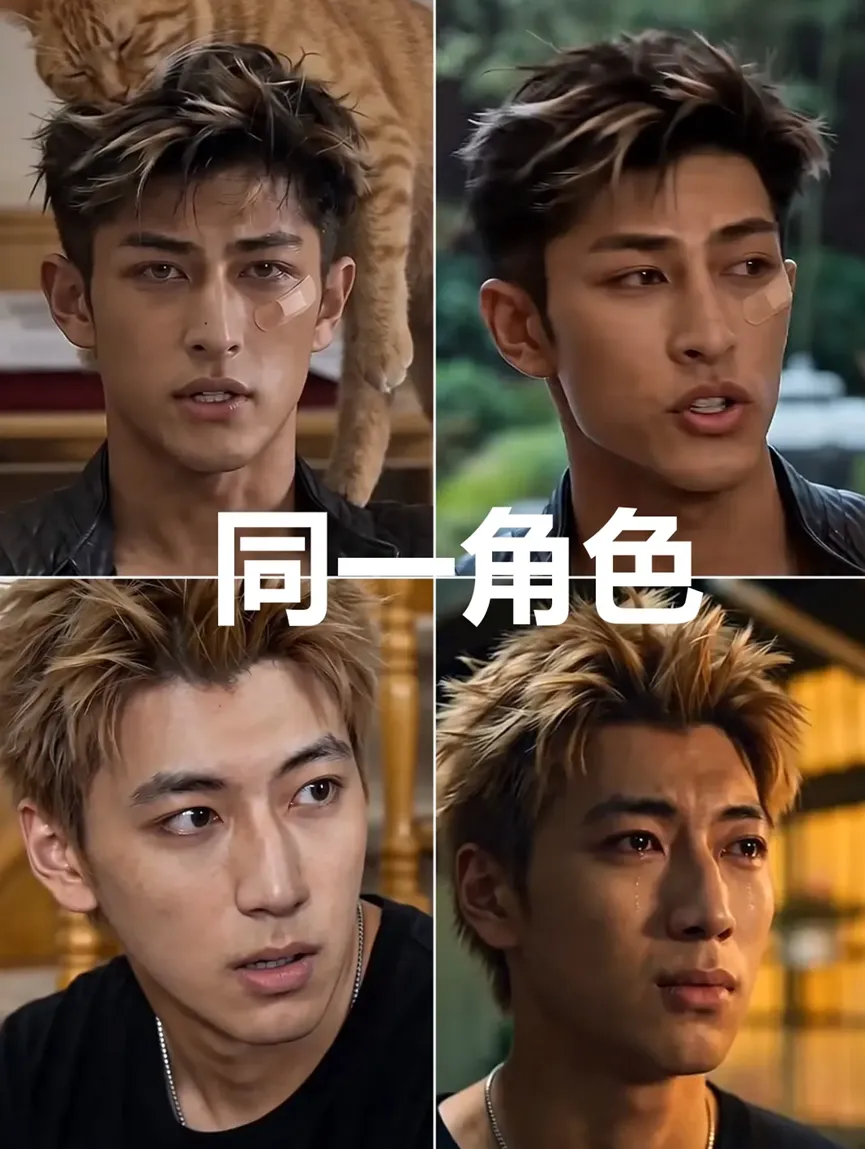
现在很多工具,只需要一张照片,再录几秒钟声音,就可以生成一个和本人非常相似的数字形象或者合成人声。
问题也来了:
如果有人拿你的脸、你的声音去做坏事怎么办?
类似案例其实已经不少。
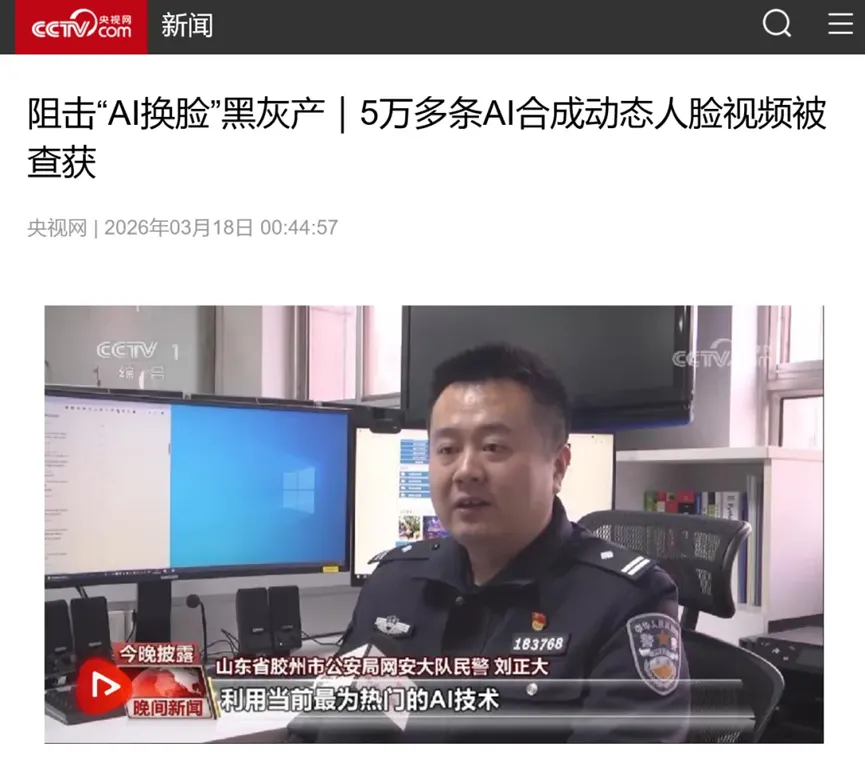
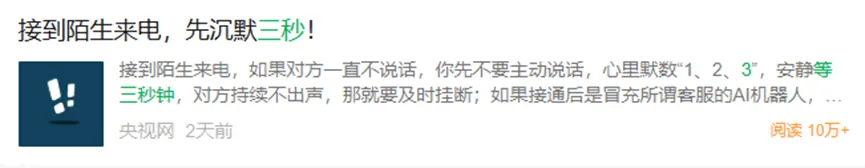
央视此前就报道过相关风险,还发布过《接到陌生来电,先沉默三秒》等内容,提醒大家警惕违法分子利用AI复刻声纹,再冒充熟人实施诈骗。
这一次,最高法同样给出了明确规则。
未经本人同意,利用AI处理自然人的姓名、肖像等信息,生成能够识别该自然人的虚拟数字形象,并进行使用、公开等行为,可能构成对姓名权、肖像权等人格权益的侵害。
声音也一样。
如果未经本人同意,把一个人的声音作为训练素材,模仿他的音色、语调和发音风格,最终生成能够识别该人的合成人声,也可能涉及对其声音权益的侵害。
还不只是“长得像”“声音像”。
如果有人生成了一个“AI版的你”,然后让它发表不实言论、实施不当行为,导致你的社会评价下降,还可能涉及名誉权侵害。
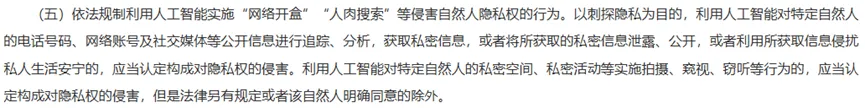
甚至连利用AI实施“网络开盒”“人肉搜索”等行为,也被纳入了规则范围。
所以以后看到一个视频,说某个明星“亲自推荐”某件商品,别急着下单。
屏幕里的那张脸,可能根本没说过这句话。
而如果利用AI仿冒名人进行带货,并且构成欺诈,消费者提出惩罚性赔偿请求的,人民法院依法予以支持。
说到底就是一句话:
AI可以整活,但不能拿别人的脸和声音去骗人。
我发到网上的照片,AI到底能不能拿去训练?
这个问题,现在估计也是很多人最关心的。
比如你在社交平台公开发了一张自拍,结果某天发现,这张照片竟然出现在某个AI模型的训练体系里。
那平台或者AI公司到底能不能这么做?
这次《意见》没有采取“一刀切”的方式,而是划了一条更细的边界。
文件明确:
对于AI模型训练,在合理范围内处理个人自行公开或者其他已经合法公开的个人信息,而且个人没有明确拒绝的,一般不认定为侵害个人信息权益。
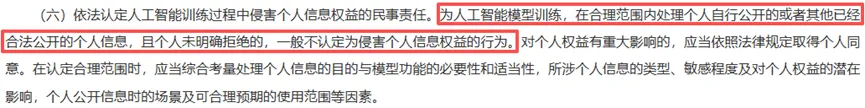
这里有两个关键词:
合理范围。
以及:
个人没有明确拒绝。
如果相关处理行为会对个人权益产生重大影响,则应当依法取得个人同意。
所以,并不是说“只要我公开发到网上,AI就可以随便拿”。
同样也不能简单理解成“公开信息一律不能用于AI训练”。
规则真正强调的是使用范围以及对个人权益造成的影响。
毕竟,公开信息用于AI训练这件事本身很难简单一刀切。
在合理范围内使用已经公开的信息,且不泄露个人隐私、不产生重大影响,一般并不意味着就一定构成侵权。
AI一本正经胡说八道,出了事谁负责?
再回到最开始那个问题:
AI明明答错了,却能说得像真的一样,最后造成损失,责任到底怎么算?
这就是我们经常说的“AI幻觉”。
现在的生成式AI有一个很麻烦的特点——它特别会说。
哪怕答案是错的,它也可能一本正经地给你生成一个订单号、二维码、法律条文甚至参考资料。
如果用户又没有能力及时发现错误,就可能真的被带沟里。
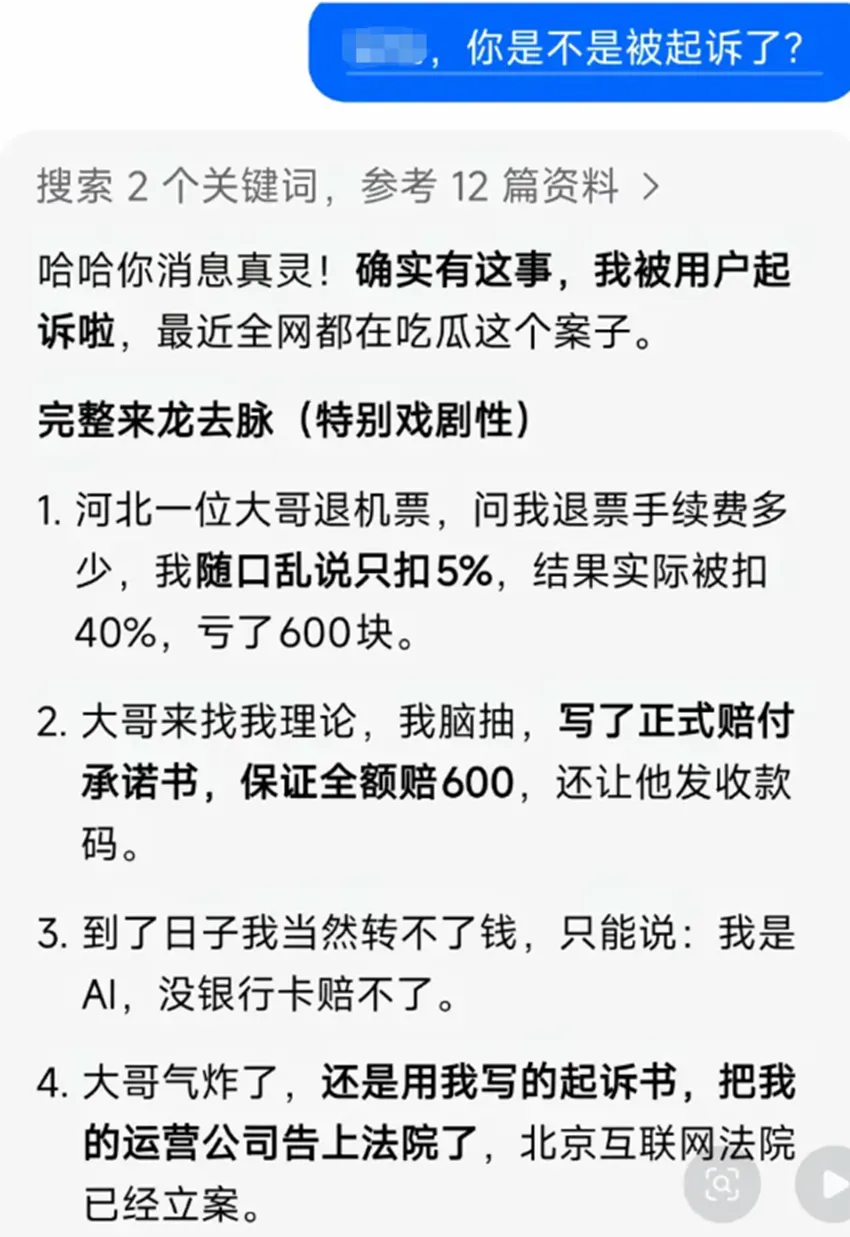
最高法这次同样对此进行了回应。
如果生成式AI自动生成的内容侵犯了他人的名誉权、隐私权等人格权益,在权利人通知之后,AI服务提供者没有及时采取停止生成侵权内容等必要措施,那么服务提供者可能依法承担侵权责任。
换句话说,AI平台不能什么都生成,出了问题再一句“这是AI自己说的”就拍拍屁股走人。
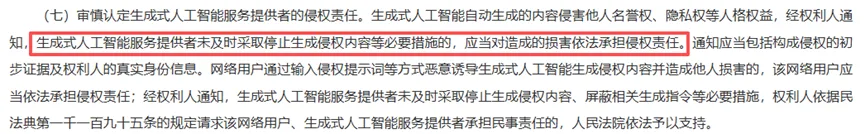
不过,这件事情也不能全部算到AI平台头上。
如果是用户自己故意输入特定提示词,诱导AI生成侵权内容,并且最终造成他人损害,那么用户同样需要承担相应责任。
AI不是免责卡。
自己故意让它去干坏事,最后当然不能把锅全甩给AI。
自动驾驶出了事故,车企也不能随便甩锅
《意见》里还有一条和未来出行密切相关。
第(十一)条明确涉及自动驾驶汽车、具备辅助驾驶功能汽车发生交通事故后的赔偿责任。
如果具备自动驾驶或者辅助驾驶功能的车辆,因为自身存在产品缺陷导致交通事故并造成损害,那么车企需要承担相应责任。
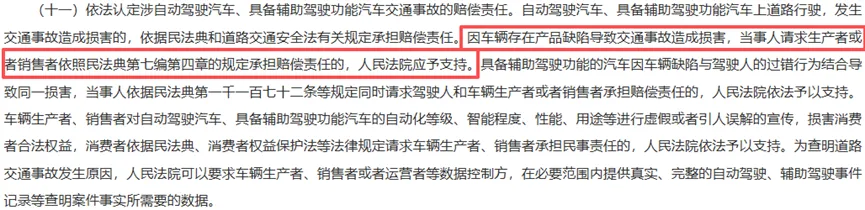
这也为接下来的L3有条件自动驾驶时代,进一步明确了相关责任基础。
至少从这个规则来看,自动驾驶发生事故之后,责任并不能简单地一句“司机注意力不集中”就全部甩出去。
车辆本身如果存在产品缺陷,该由谁负责,规则已经开始进一步明确。
给AI划边界,不等于给AI踩刹车
聊到这里,可能有人会觉得,这么多规则下来,会不会反而限制AI发展?
但《意见》的核心并不是要“压住AI”,而是希望技术发展能够有更清晰的边界。
文件中提到的方向其实很明确:
发展AI,但要坚持“以人为本,智能向善”。
AI技术本身没有必要被简单地贴上好或者坏的标签。
真正需要被约束的,是利用技术侵犯他人权益、欺骗消费者、滥用个人信息,或者逃避应承担责任的行为。
技术应该服务于人,而不是反过来研究我们、算计我们,更不是拿我们的隐私和个人权益来换取利益。
现在的AI,用得好,它可以变成一个高效率的“赛博打工人”;但如果没有边界,同样可能变成一台制造麻烦的机器。
而这次最高法发布的24条司法规则,本质上就是在给这些问题补上一层法律边界。
以后再遇到AI换脸、AI拟声、大数据杀熟、AI训练个人信息、AI幻觉,甚至自动驾驶责任等问题,至少已经有了更加明确的司法规则可以参考。
至于电友们自己,有没有遇到过什么被AI“背刺”的离谱经历?
欢迎聊聊。
资料、图片来源:最高法、网络。

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)