
【AI 大模型】国内各平台 AI 大模型 价格、性能 对比分析 ② ( 智谱 BigModel | 腾讯云 TokenHub | 千问 AI 平台 )
文章目录
AI 大模型平台 :
- 腾讯云 TokenHub : https://console.cloud.tencent.com/tokenhub/models
- 火山方舟 : https://console.volcengine.com/ark/
- 千问 AI 平台 : https://www.qianwenai.com/
- 智谱 BigModel : https://bigmodel.cn/
- DeepSeek : https://platform.deepseek.com/usage
- KIMI : https://platform.kimi.com/
一、智谱 BigModel
1、定价简介
智谱 BigModel 大模型平台 : https://bigmodel.cn/
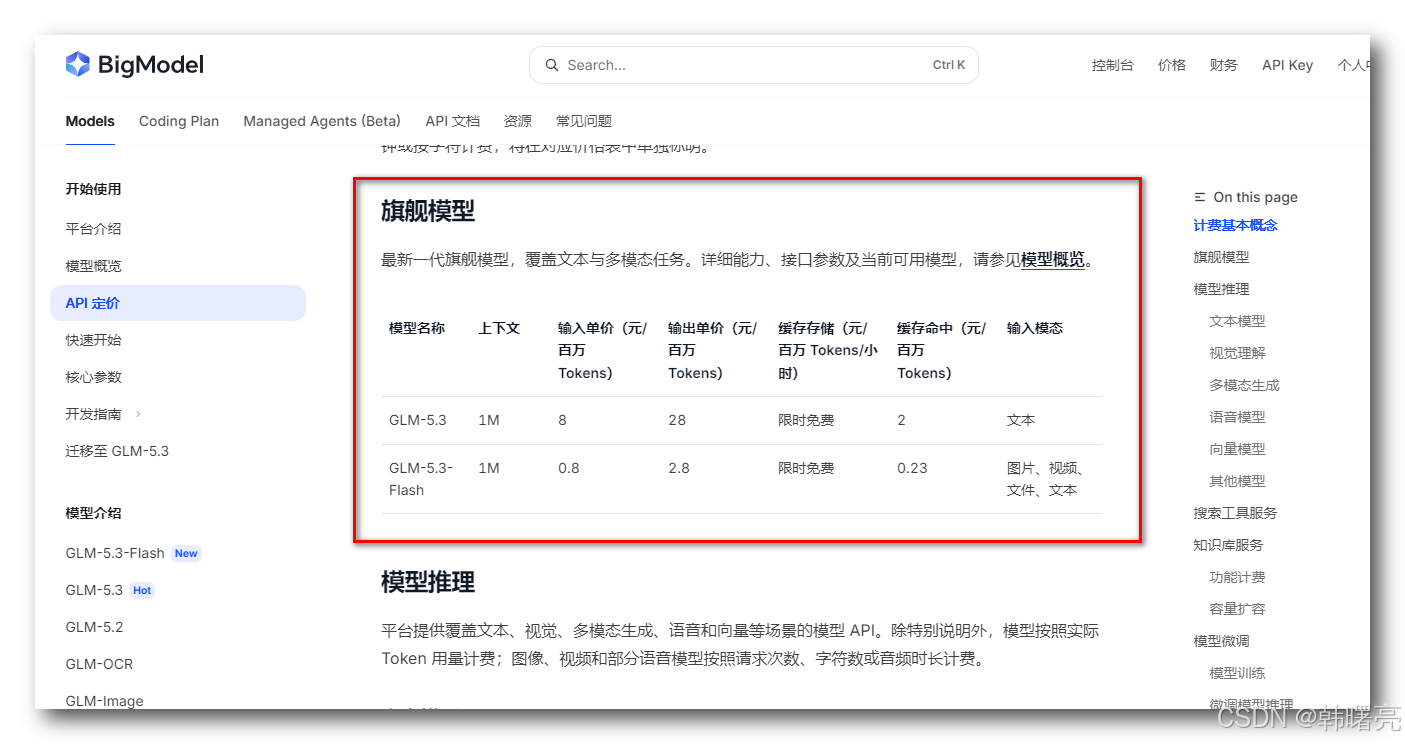
智谱 GLM-5.3 大模型定价 : https://docs.bigmodel.cn/cn/guide/start/pricing
2、智谱大模型多维度对比
智谱 大模型 多维度对比 : GLM-5.3、GLM-5.3-Flash、GLM-5.2、GLM-5.1、GLM-5-Turbo、GLM-5 大模型多维度对比 ;
| 维度 | GLM-5.3 | GLM-5.3-Flash | GLM-5.2 | GLM-5.1 | GLM-5-Turbo | GLM-5 |
|---|---|---|---|---|---|---|
| 发布时间 | 2026.08.14 | 2026.08.26 | 2026.06.16 | 2026.04.08 | 2026.03.16 | 2026.02.12 |
| 是否开源 | ✅ MIT | ✅ MIT | ✅ MIT | ✅ MIT | ❌ 闭源 | ✅ MIT |
| 总参数 / 激活 | 744B / ~40B | 320B / 18B | 744B / 40B | 744B / 40B | 744B / 40-44B | 744B / 40B |
| 上下文窗口 | 1M | 1M | 1M | 200K | 200K | 200K |
| 注意力设计 | DSA + 后训练Scaling | 线性 + 稀疏混合 | IndexShare稀疏注意力 | DSA | MoE (80层/256专家) | DSA |
| 多模态 | ❌ 仅文本 | ✅ 图/视频/文件 | ❌ 仅文本 | ❌ 仅文本 | ❌ 仅文本 | ❌ 仅文本 |
| 综合智能指数 | 未单独公布 | 57分 ( AA v4.1 ) | 51分 ( AA v4.1 ) | 未公布 | 未公布 | 50分 ( AA v4.0 ) |
| 输入价 ( 国内/百万tokens ) | ¥8 | ¥0.8 ( 5折¥0.4 ) | ¥8 | ¥6 ( <32K ) / ¥8 ( ≥32K ) | ¥5 ( <32K ) / ¥7 ( ≥32K ) | ¥4 ( <32K ) / ¥6 ( ≥32K ) |
| 输出价 ( 国内/百万tokens ) | ¥28 | ¥2.8 ( 5折¥1.4 ) | ¥28 | ¥24 / ¥28 | ¥22 / ¥26 | ¥18 / ¥22 |
| 海外输入/输出 ( $/百万 ) | $1.4 / $4.4 | $0.15 / $0.50 | $1.4 / $4.4 | $1.4 / $4.4 | $0.96-1.20 / $3.20-4.00 | $1.0 / $3.2 |
3、编程能力
GLM-5.3 是目前写代码最强的开源大模型 , 在智谱自家的 Z.ai Code Bench 测试里 , 它 比上一代 GLM-5.2 的代码能力直接提高了一半 ;
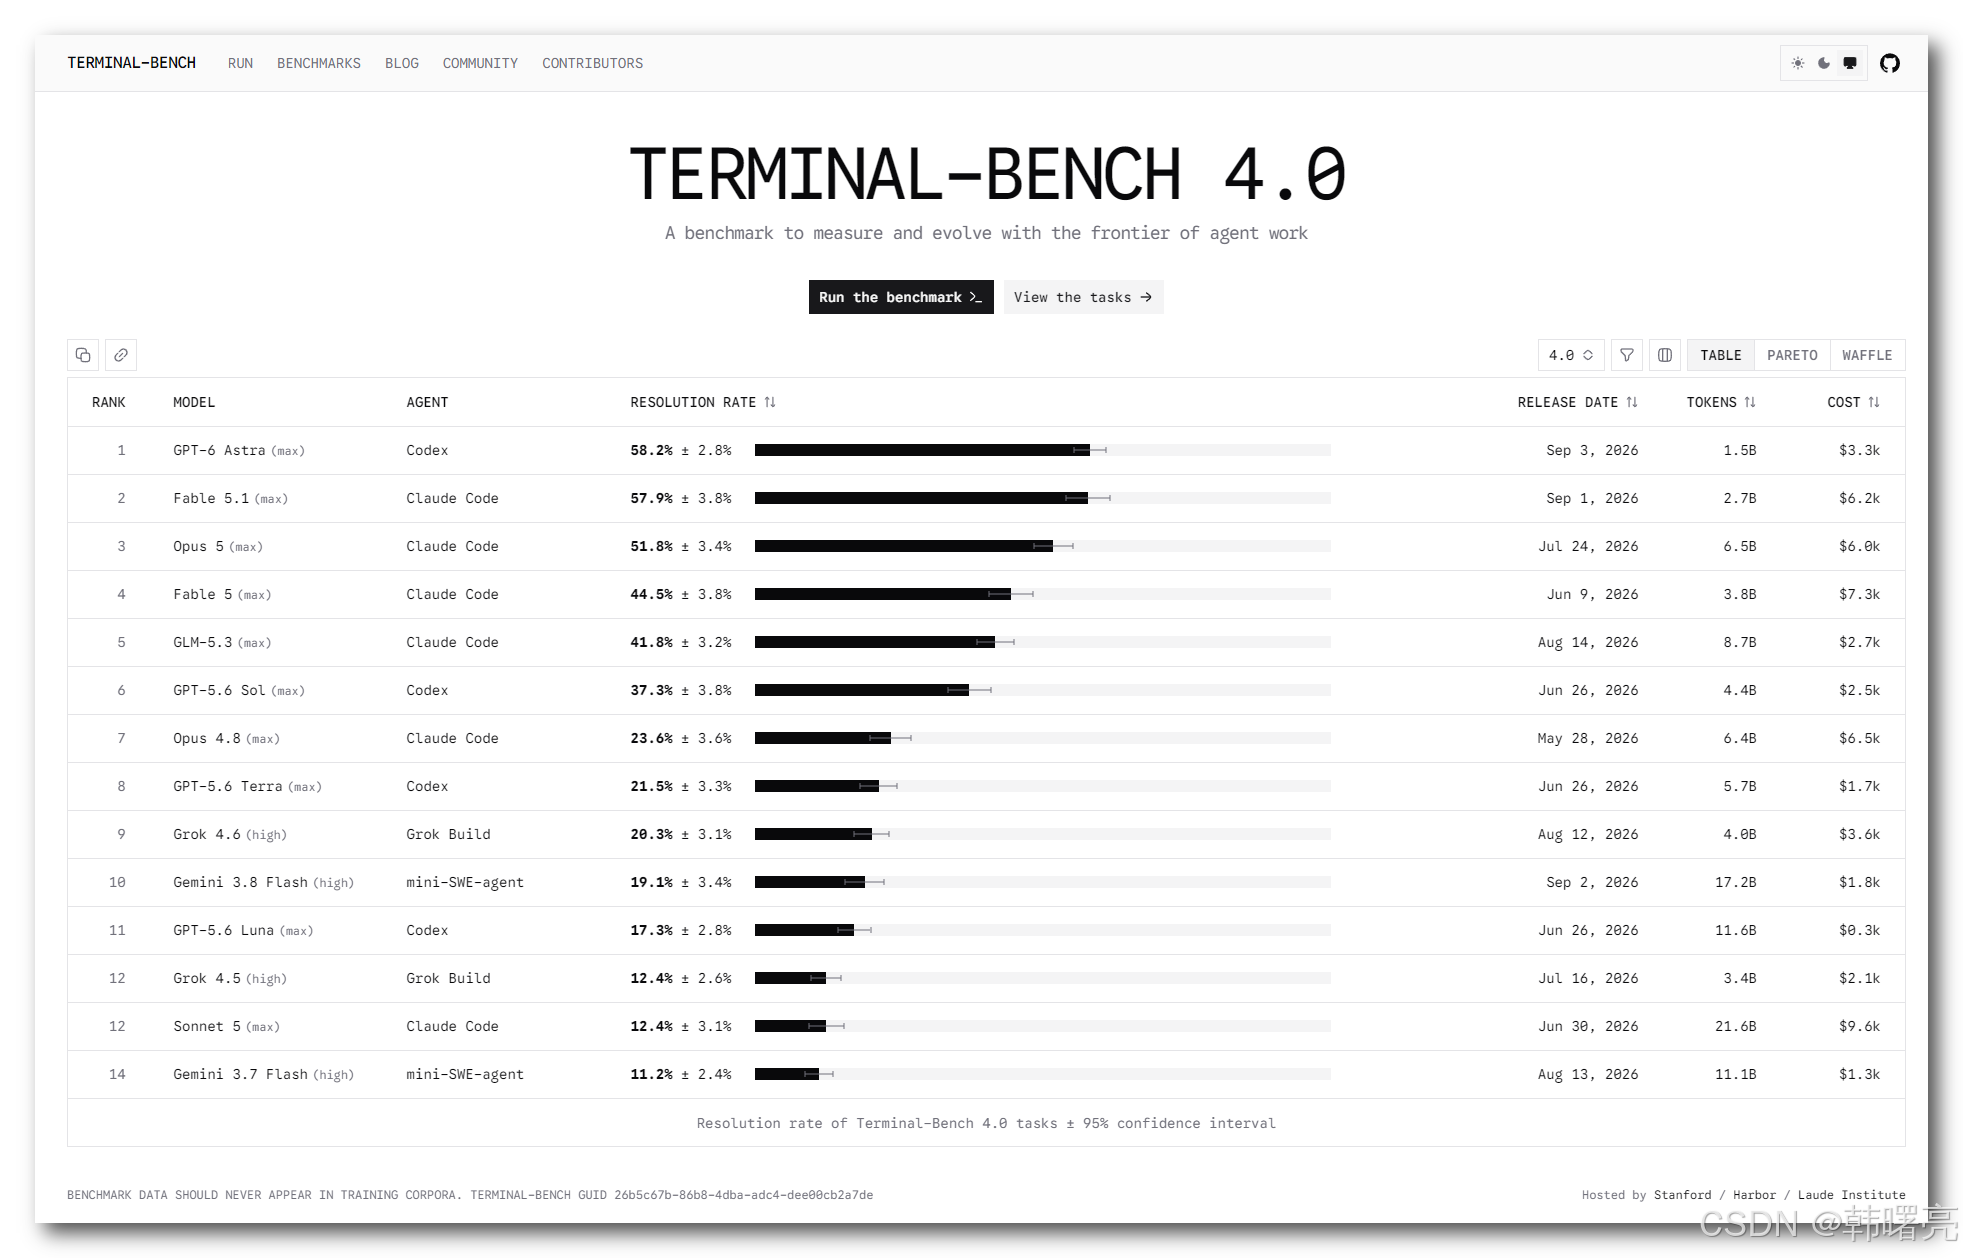
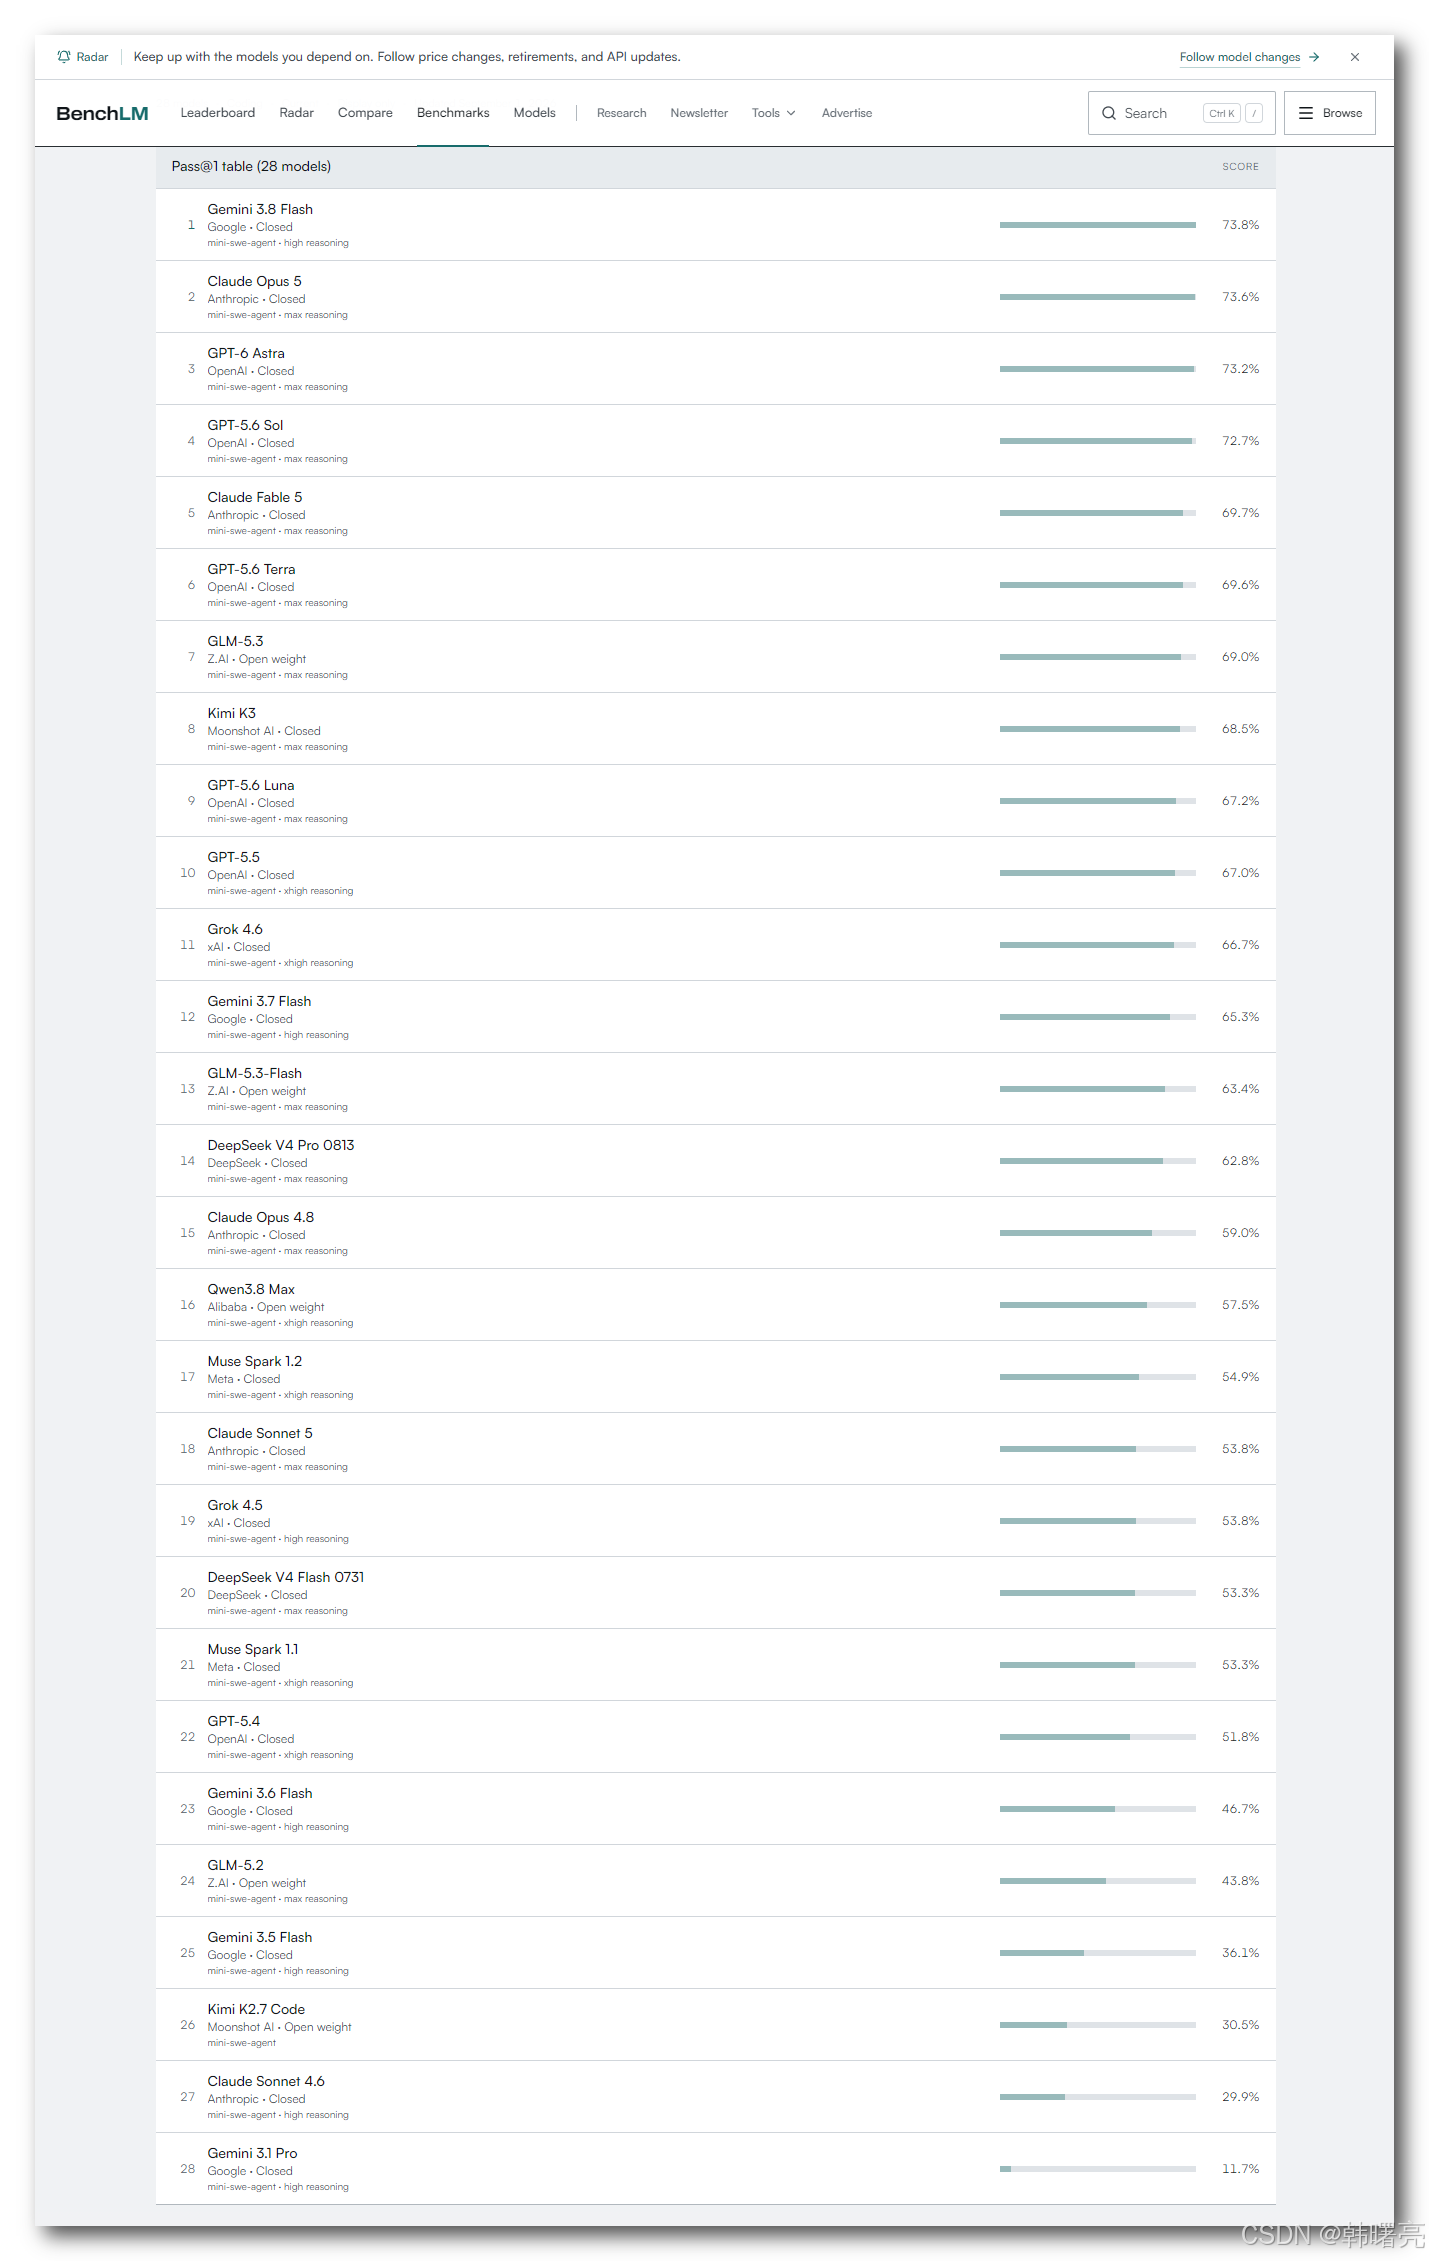
Terminal-Bench 3.0 这个测试集上 , GLM-5.2 原来只有 4.6 分 , GLM-5.3 一下子冲到 28.3 分 ; 另外两个重要编码测试 : DeepSWE v1.1 从 46.2 涨到 66.9 , Agents‘ Last Exam 从 23.8 涨到 28.5 ; 这两项核心代码测评 , 它都是开源模型里第一名 ;
- Terminal-Bench 4.0 大模型编程能力测试 : 评估 AI 智能体 在真实命令行环境 ( 终端 ) 中执行高难度、端到端任务的能力 , https://www.tbench.ai/
- DeepSWE 编程能力测试 : 评估 AI 代理 在真实、复杂的软件工程任务中的表现 , 尤其强调 " 零污染 " 和原创性 , 像一场软件工程的 " 竞技体育 " , 专测模型在代码层面的极限能力 , 任务边界清晰 ; https://benchlm.ai/coding ;
- Agents’ Last Exam 编程能力排名 : 旨在 衡量 AI 在长期、具有经济价值的真实工作流程中的表现 , 更像一场真实职业的 " 资格认证考试 " , 它关注 AI 在复杂、多步骤的真实工作流中 , 能否综合运用包括编码在内的各种技能来交付最终成果 ; https://agents-last-exam.org/leaderboard
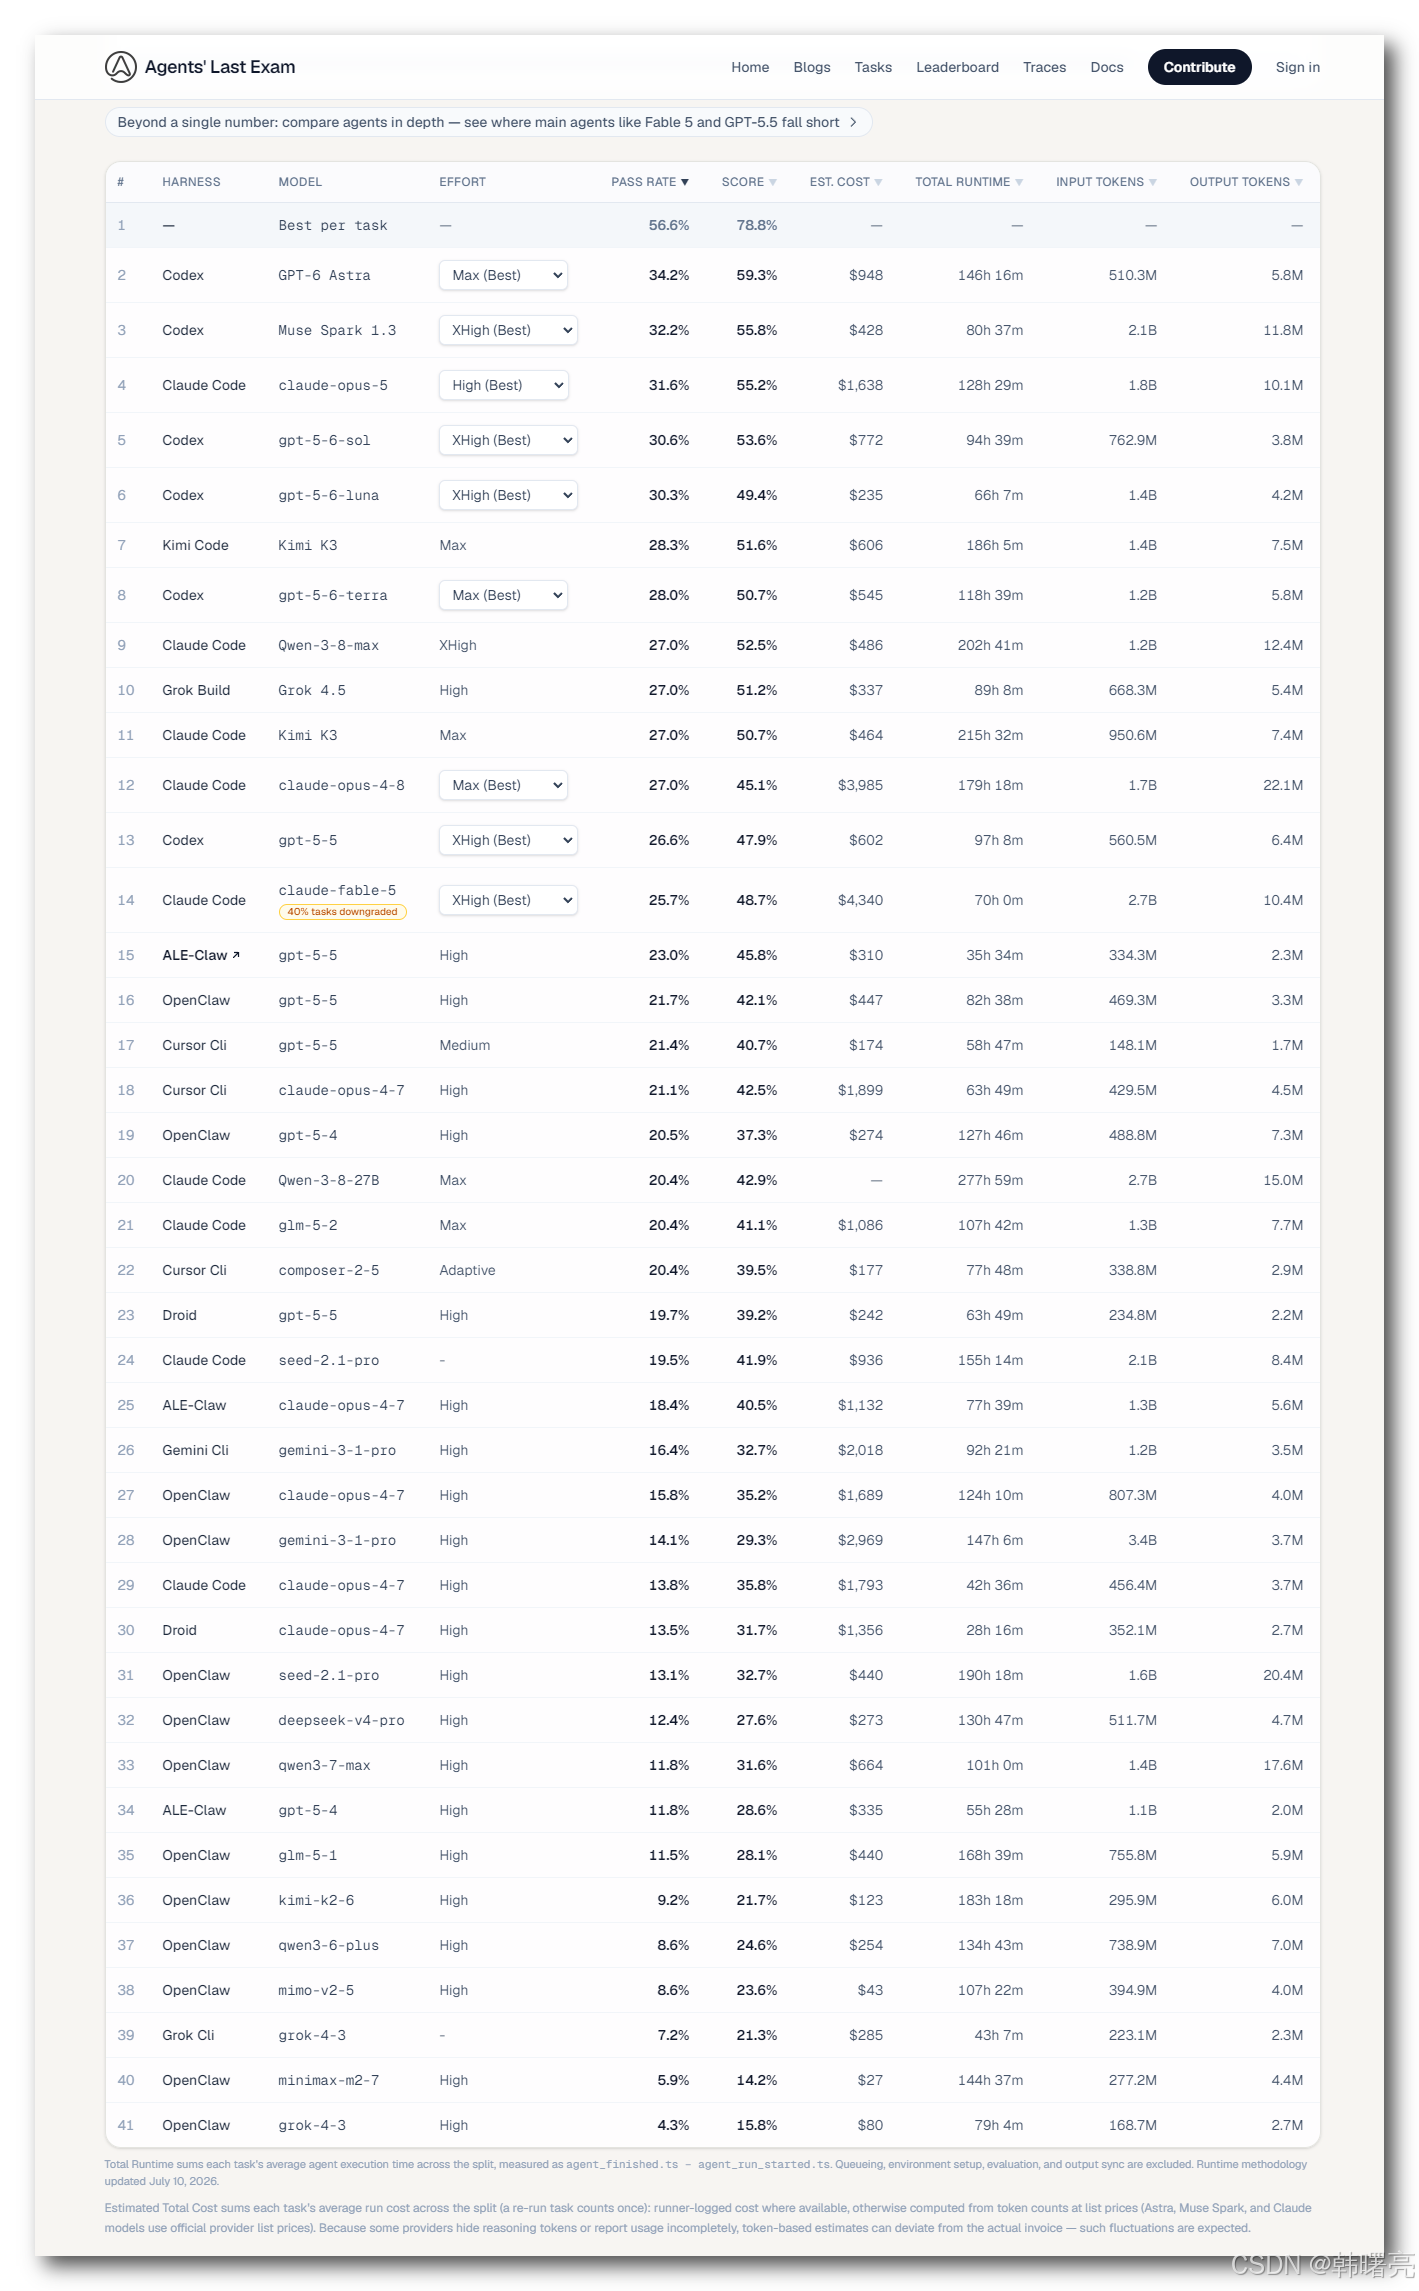
上面这些排名看看就行 , 大模型 token 卖那么贵 , 具体使用可以逐个测试后 , 采用性价比最高的那个即可 ;
调到最高精度档位跑的时候 , GLM-5.3 的正确率有 31.4% , 比 Claude Opus 4.8 的最高档 ( 29.5% ) 还要高 ; 而且它完成每个任务平均只输出约 5 万 token , Claude Opus 4.8 却要 12 万 token , 思考和执行的步骤短很多 ;
GLM-5.3-Flash , 虽然定位是轻量化小模型 , 但写代码的实力并不弱 ; 它把 看图能力直接整合进写代码的流程里 , 可以自己看页面渲染效果 , 一边看一边改 ; 做前端页面、写小游戏这类场景 , 能形成完整的自我迭代闭环 , 这点很有优势 ;
顺带往前看几代 :
- GLM-5.2 在 Terminal-Bench v2.1 拿到 78% , 比 GLM-5.1 高 16 个点;SWE-bench Pro 得分 62.1 , 代码能力相比老版本提升非常明显 ;
- GLM-5.1 在 SWE-bench Pro 拿到 58.4 , 当年直接刷新这个榜单记录 , 比 GPT-5.4、Claude Opus 4.6 这些不开源的模型成绩还好 ;
GLM-5-Turbo 专门针对 OpenClaw 这类 AI 智能体场景做了优化 , 重点加强了调用工具、听懂指令、跑长串复杂任务的能力 ; 在智谱自研的 ZClawBench 测评里 , 它在国产模型中排第一 ;
4、开通 API Key
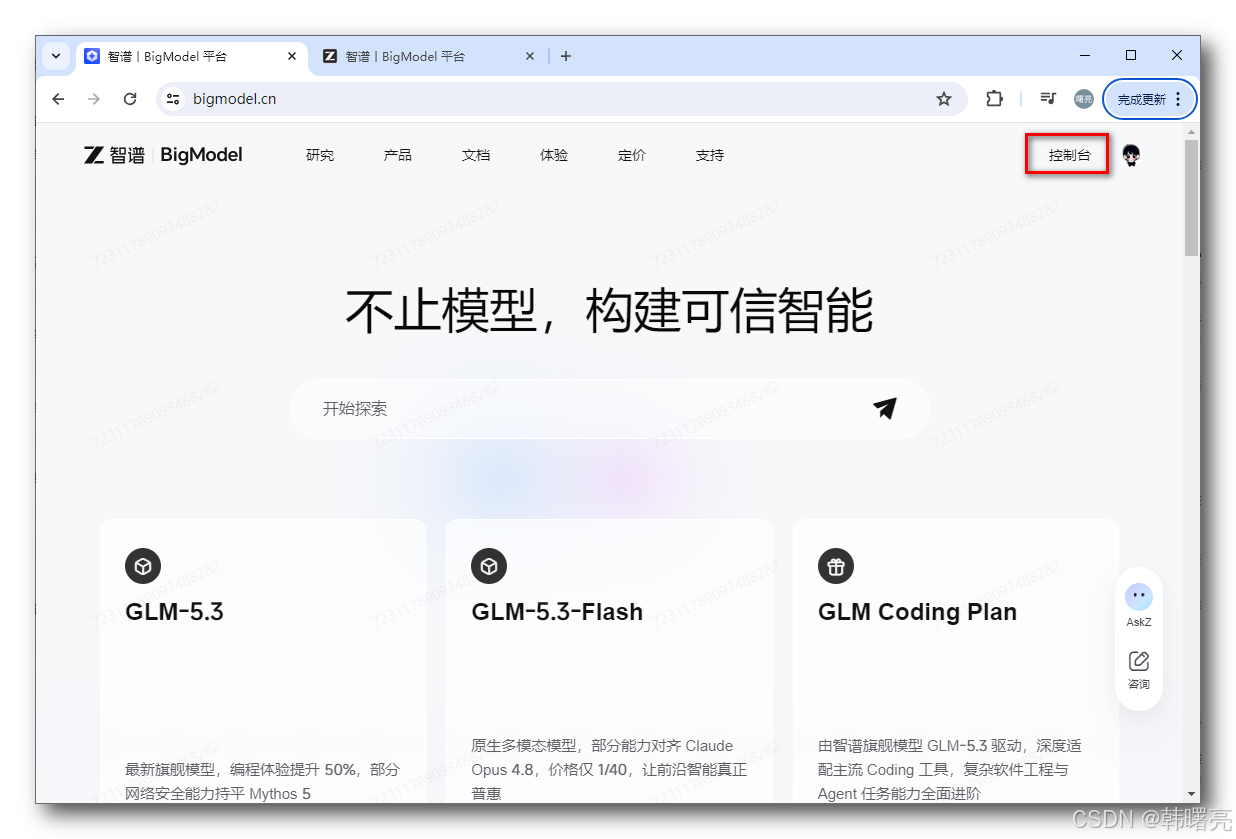
在 https://bigmodel.cn/ 页面 , 点击右上角 " 控制台 " 按钮 , 进入控制台 ;
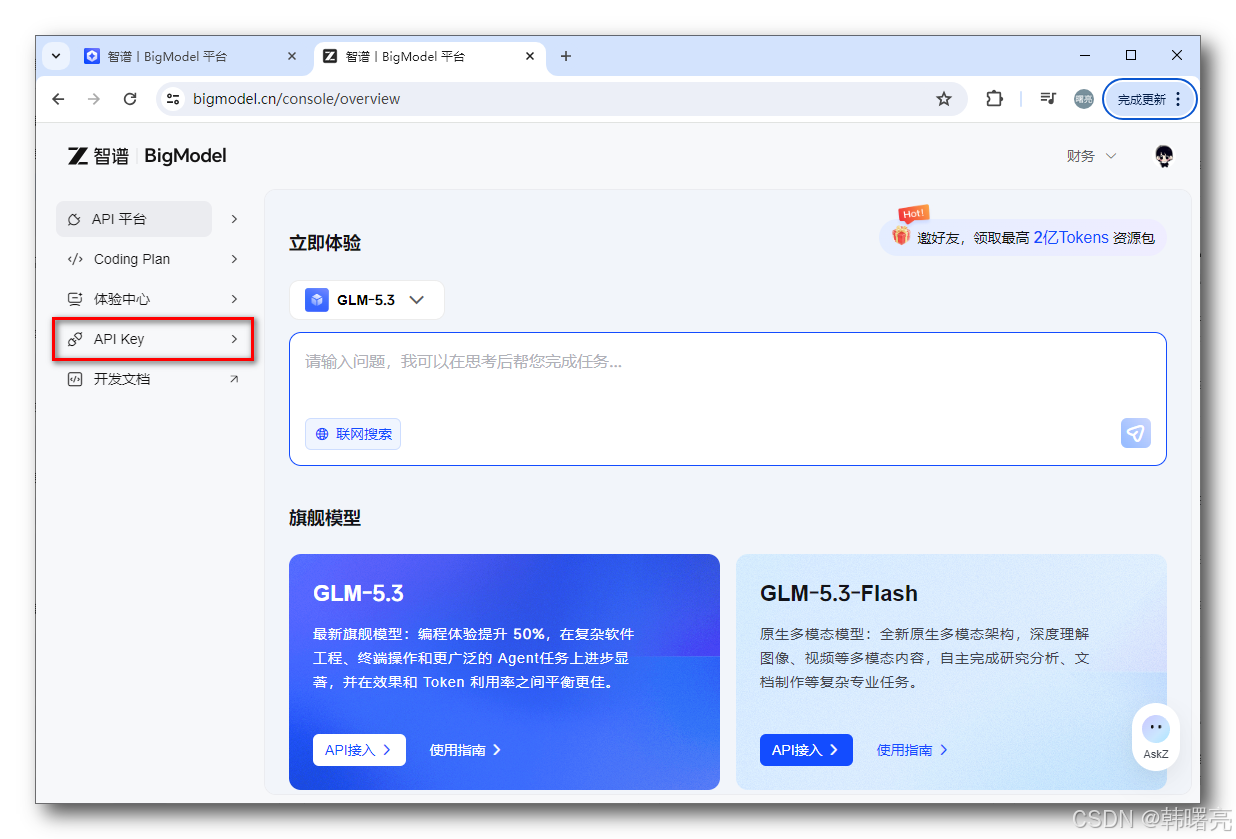
选择 API Key ,
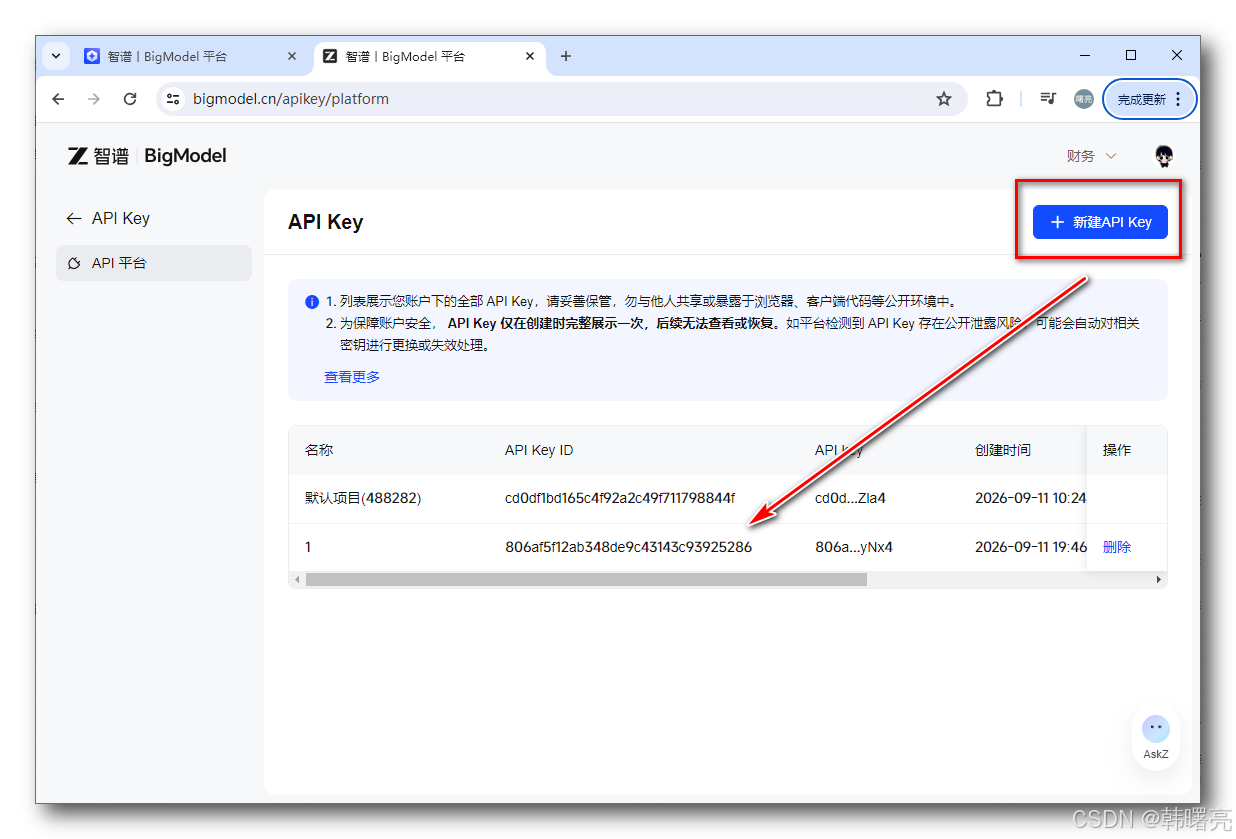
创建一个 API Key ;
5、接入 TraeCode
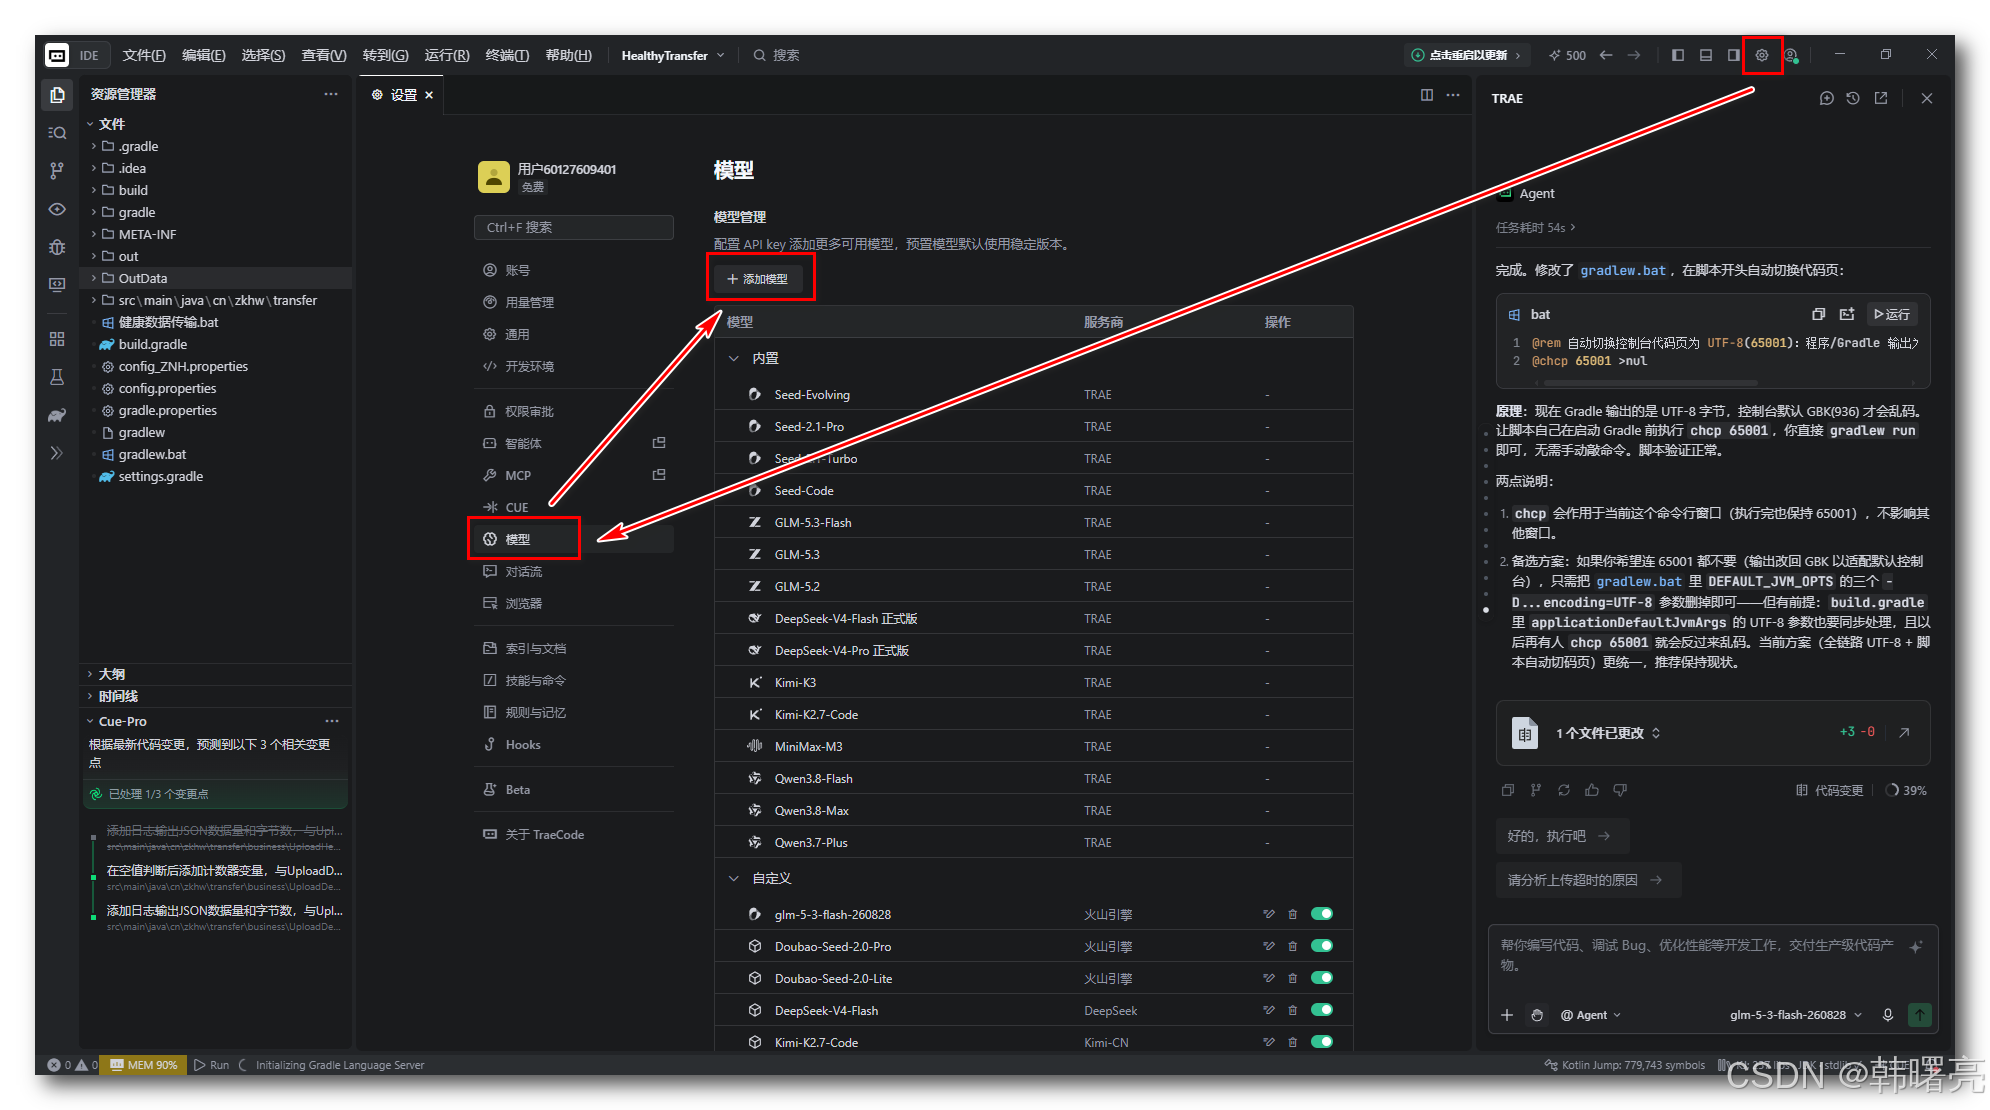
在 TraeCode 中 , 选择 设置 | 模型 | 添加模型 ;
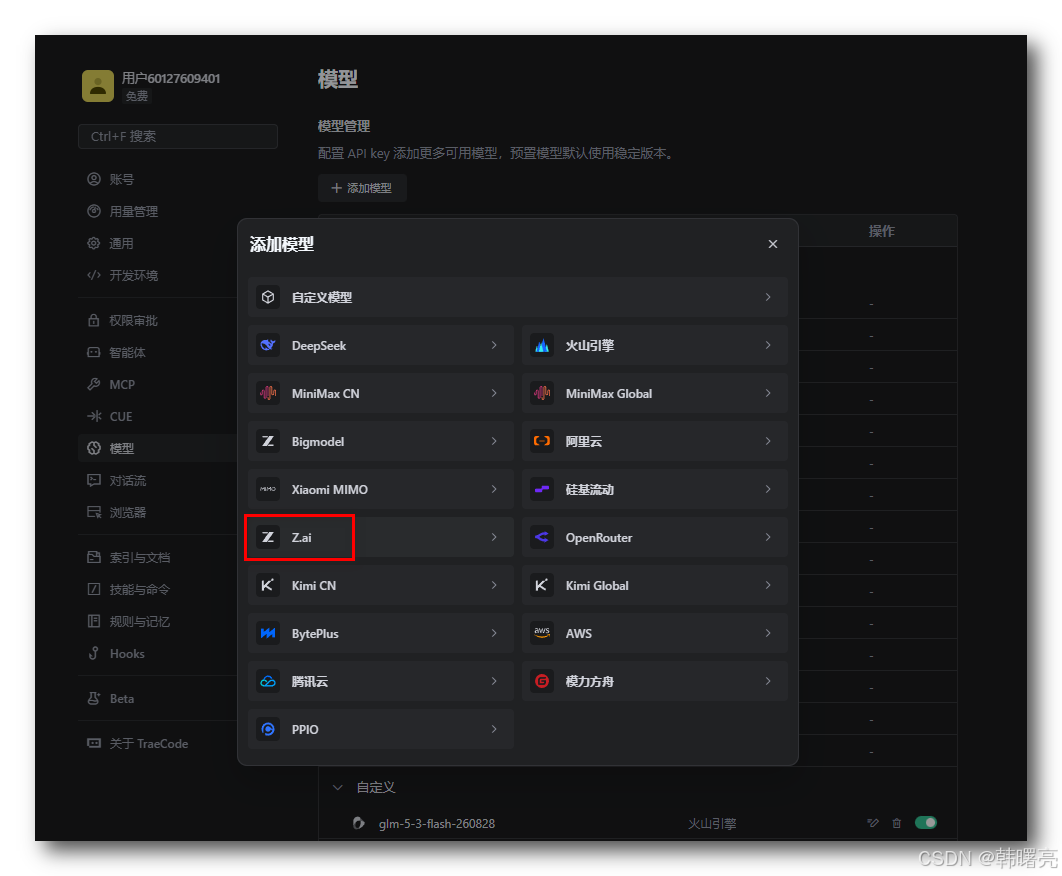
选择 Z.ai 平台 , 这是 智谱 平台 ;
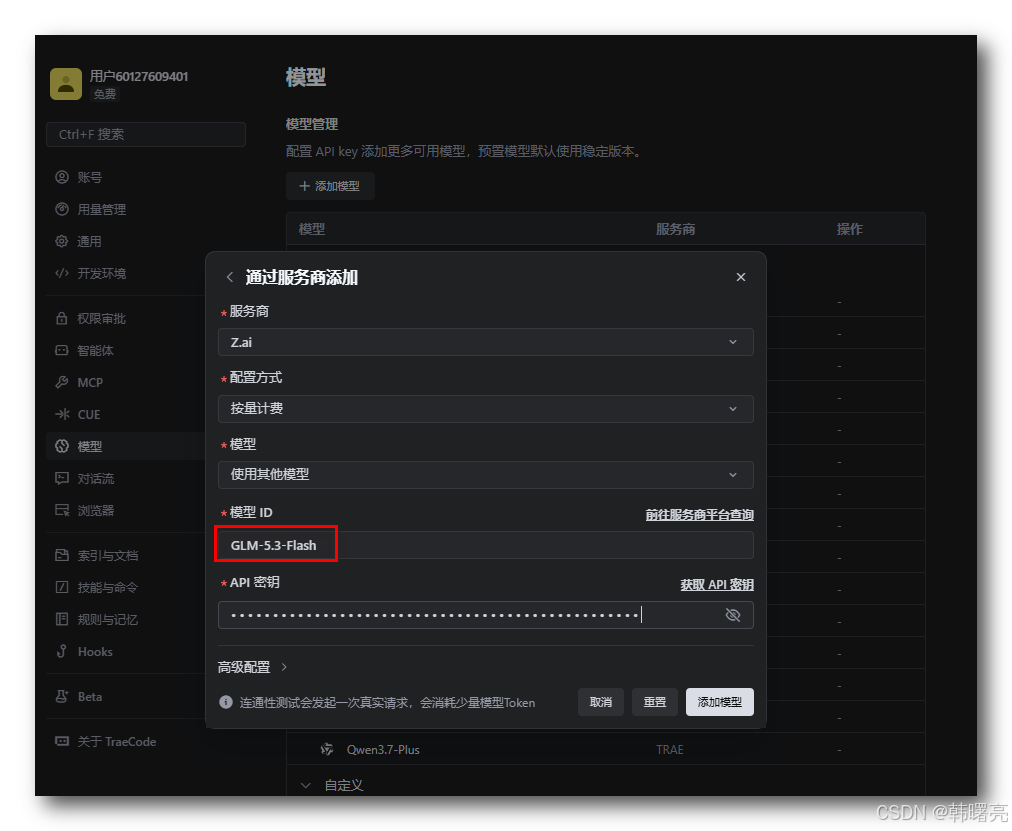
需要手动添加 模型 ID , GLM-5.3-Flash , 然后拷贝 之前申请的 API Key ;
二、腾讯云 TokenHub
1、价格简介
进入 腾讯云 首页 https://cloud.tencent.com/ , 选择 顶部 " 产品 / 人工智能与机器学习 / 大模型服务平台 TokenHub " ;
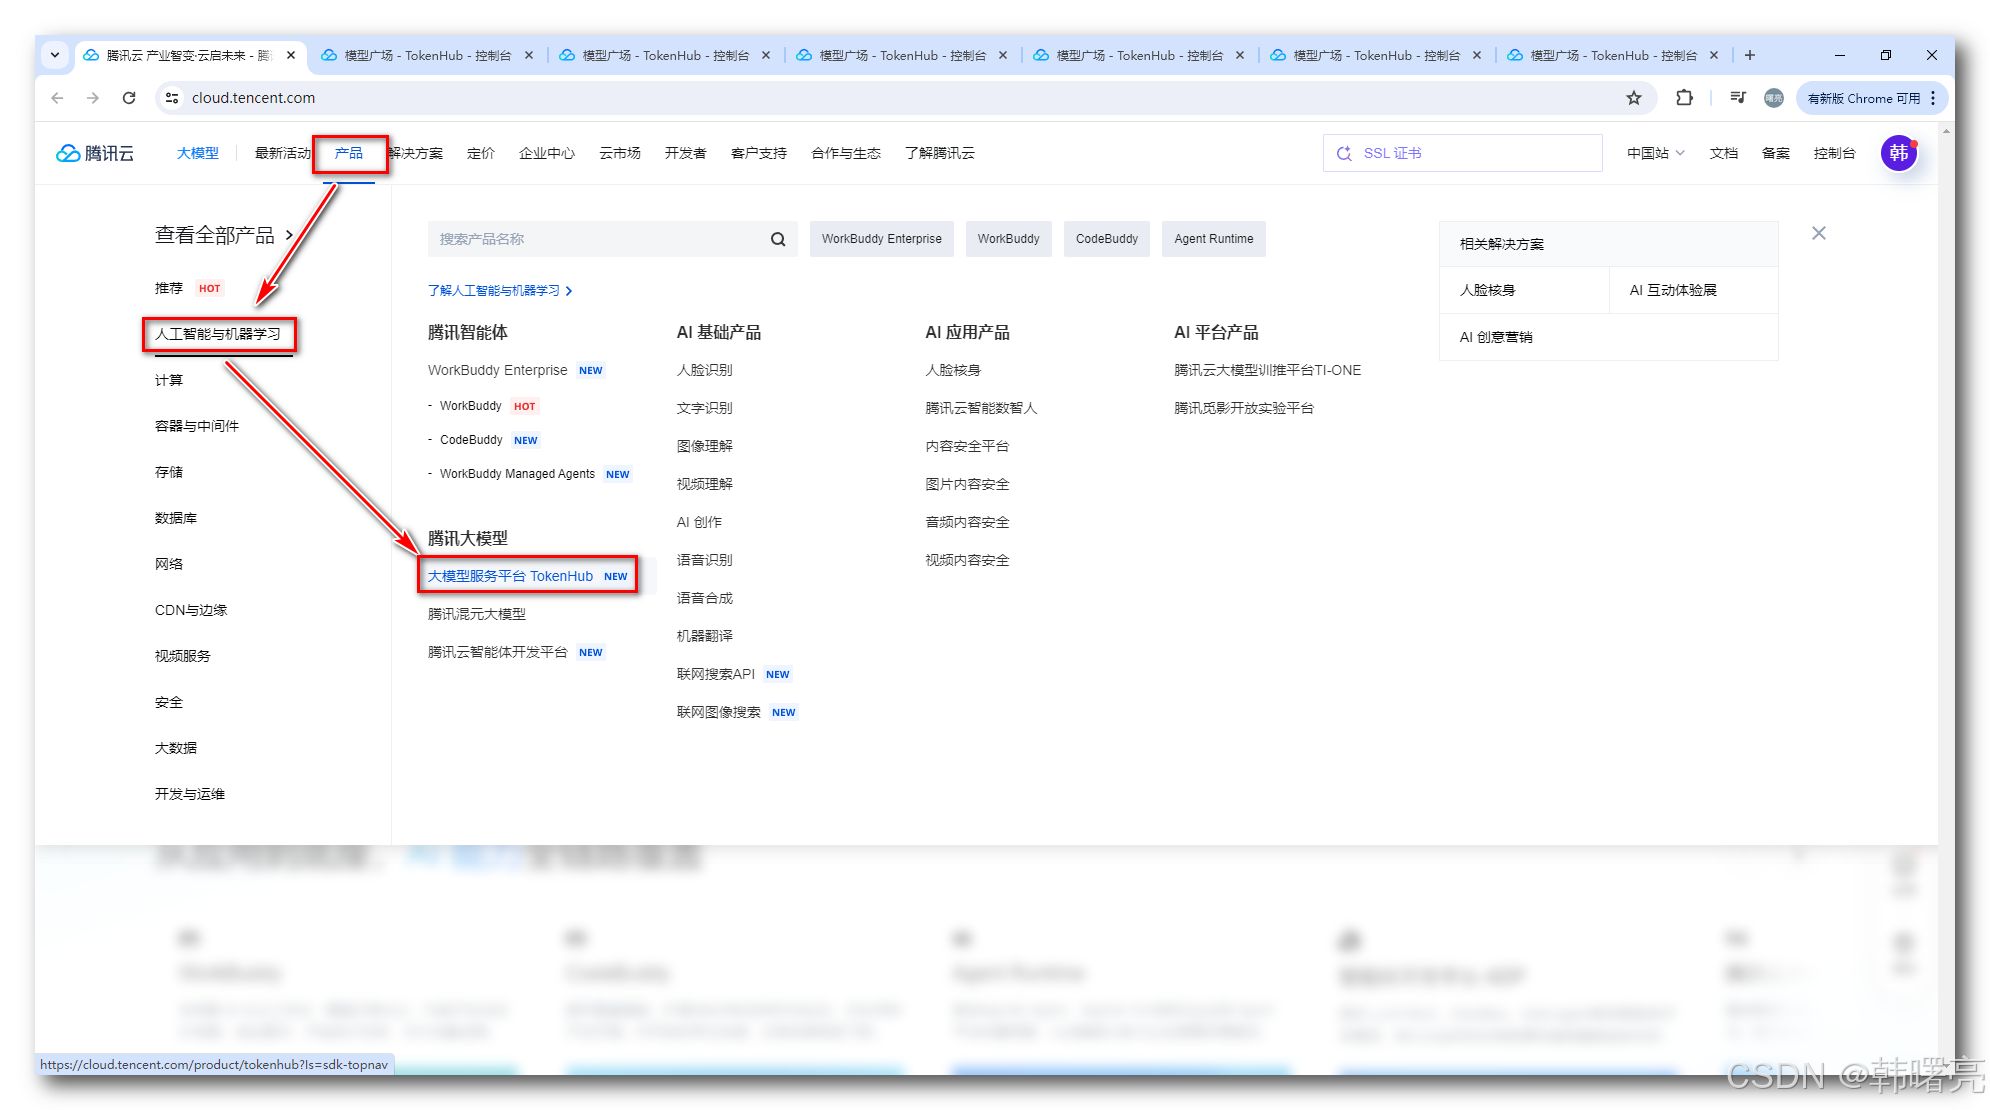
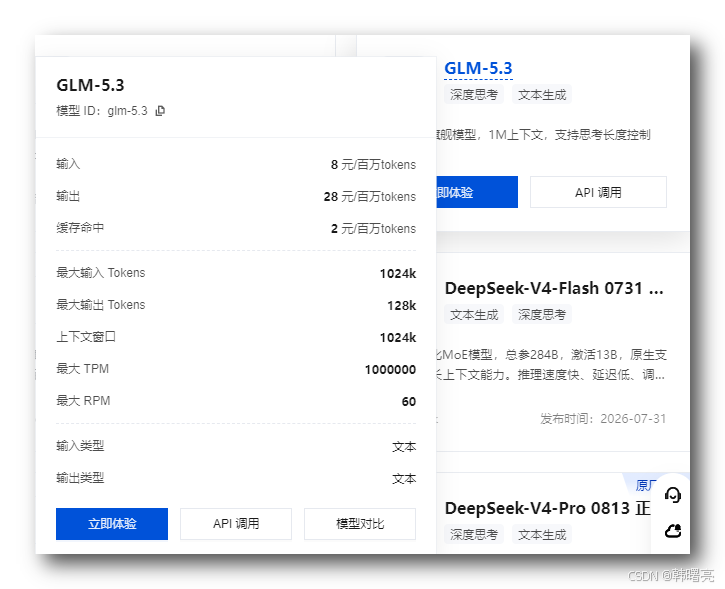
进入 TokenHub 之后 , 点击左侧的 " 模型广场 " , 进入 模型广场界面 https://console.cloud.tencent.com/tokenhub/models ;
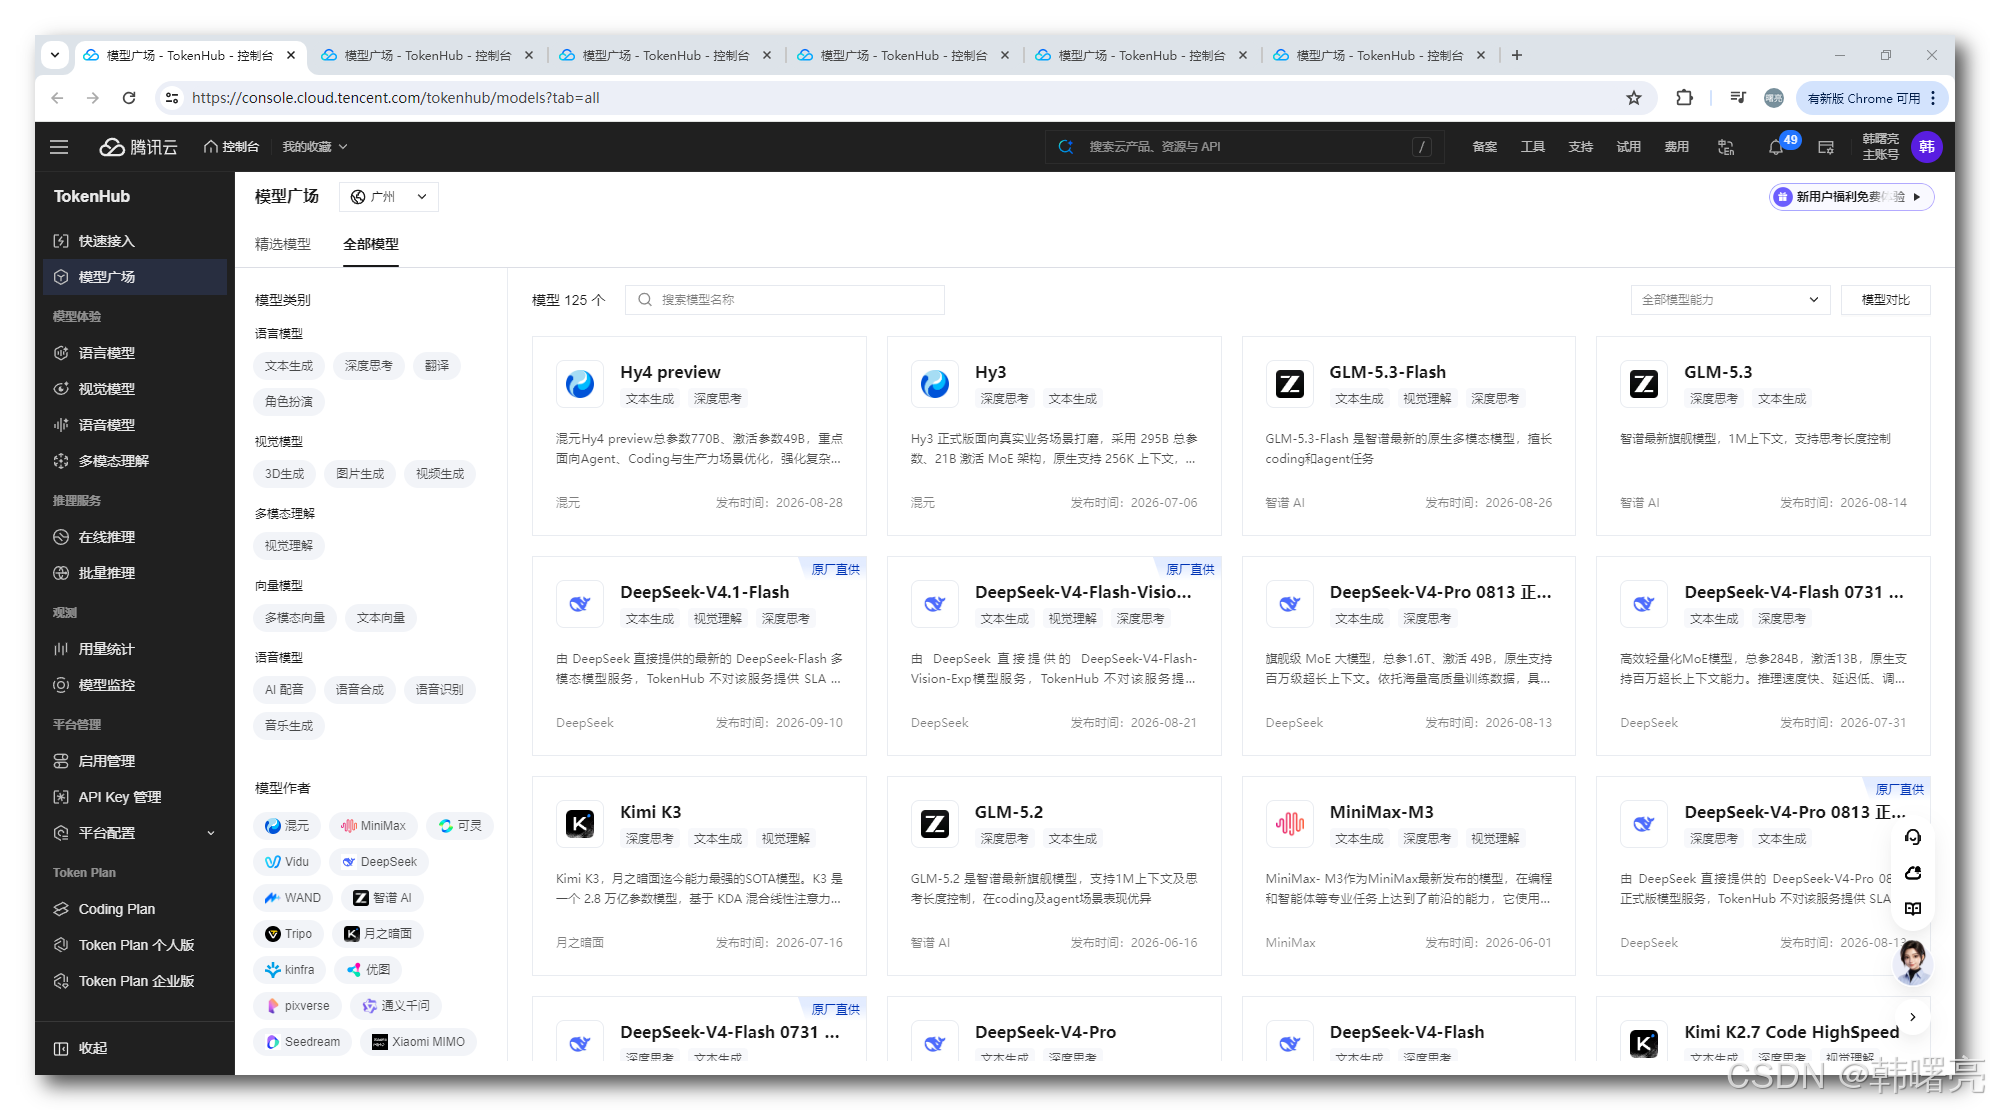
查看几个关键的模型价格 :
- Hy4 preview : 百万 tokens 18 元 ;
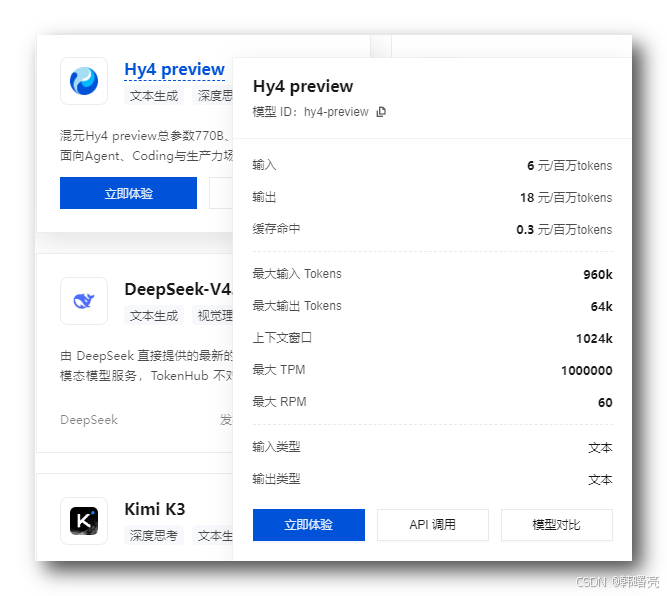
- Hy3 : 百万 tokens 4 元 ;
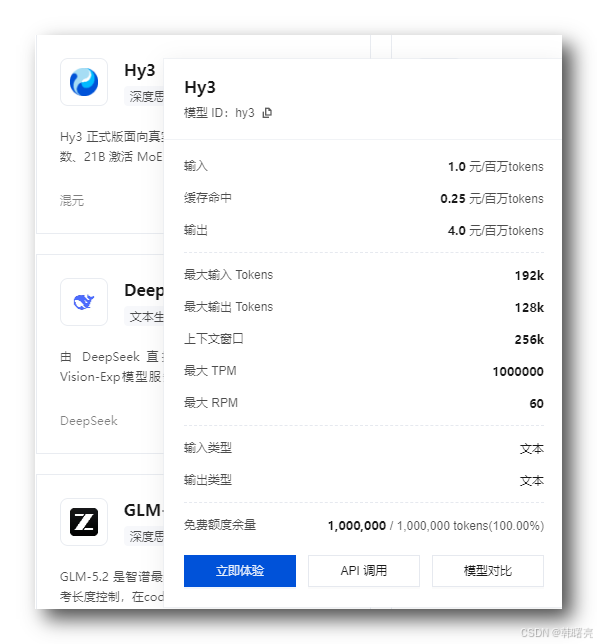
- GLM-5.3-Flash : 百万 tokens 2.8 元 , 这个最便宜 ;
- GLM-5.3 : 百万 tokens 28 元 ;
2、大模型多维度对比
| 维度 | Hy4 preview | Hy3 | GLM-5.3 | GLM-5.3-Flash | DeepSeek-V4.1-Flash | DeepSeek-V4.1-Pro |
|---|---|---|---|---|---|---|
| 发布时间 | 2026-08-28 | 2026-07-06 | 2026-08-14 | 2026-08-26 | 2026-09-10 | 尚未正式发布 ( 开发中 ) |
| 参数架构 | 770B MoE / 49B 激活 , 78层 | 295B MoE / 21B 激活 , 含3.8B MTP层 | ~744B MoE / ~40B 激活 , 与 GLM-5.2 同基座 | 320B MoE / 18B 激活 , 45层 , 多模态底座 | 552B MoE / 输入激活8B·输出激活16B , CED 非对称架构 | 预计基于 V4-Pro ( 1.6T MoE / 49B 激活 ) 迭代 |
| 注意力设计 | Gated DeepSeek Sparse Attention + IndexCache 跨层稀疏索引复用 | 未公开具体细节 | DSA 稀疏注意力 , 2048-token top-k indexer | 首个稀疏注意力 + 线性注意力混合架构 , 单Token注意力计算量降3.01倍 , KV缓存减少4.44倍 | Compressed Sparse Attention 2 ( CSA2 ) , FP4主KV缓存 , 890 bytes/token , 相对V1缩小437倍 | 预计沿用 V4-Pro 的 MoE + 稀疏注意力架构 |
| 上下文窗口 | 1M | 256K | 1M 输入 / 128K 输出 | 1M 输入 / 128K 输出 | 1M 输入 / 384K 输出 | 1M ( V4基线维持 ) |
| 是否开源 | ✅ Apache 2.0 | ✅ Apache 2.0 | ⚠️ 权重承诺开源 , 截至搜索时尚未公开 | ✅ MIT | ✅ MIT | ⚠️ 待定 |
| 多模态 | ❌ 预览版暂不支持 , 正式版将补齐 | ❌ 纯文本 | ❌ 纯文本 | ✅ 原生多模态 ( 文本+图像+视频 ) , 视觉编码能力 | ✅ 原生多模态 , 视觉编码器从零训练 | 预计支持 |
| 深度思考 | ✅ reasoning 默认 " high " , 支持多档调节 | ✅ 快慢思考融合 | ✅ 三档 : low / high / max ( 不可关闭 ) | ✅ 三档 : low / high / max ( 不可关闭 ) | ✅ 可连续控制 ( 1–100 ) , 可选 low/high/max/非思考模式 | 预计支持 |
| 编程能力 | DeepSWE v1.1 : 64.3;Terminal-Bench 2.1 : 85.4;SWE Atlas Refactoring : 53.3;内部盲测2.99/4.00 | DeepSWE : 28.0;Terminal-Bench 2.1 : 约70.8 | Terminal-Bench 3.0 : 28.3;DeepSWE v1.1 : 66.9;Agents’ Last Exam : 28.5;Z.ai Code Bench 准确率31.4% | 对标 Claude Opus 4.8 , 编程表现与 Opus 4.8 相当 | DeepSWE v1.1 : 74.2;Terminal-Bench 2.1 : 90.6;Codeforces : 3471 | 尚未发布 , 无数据 |
| Agent 能力 | Toolathlon-Verified : 74.1;APEX-Agents pass@1 : 37.1;AutomationBench : 32.1% | 任务解决率90% ( Preview版72% ) , 系统稳定性95.1%;ClawEval : 68.5 | AutomationBench : 48.2%;支持长程 Agent、工具执行 | Toolathlon-Verified : 78.4%;AutomationBench : 48.8% | AutomationBench : 54.8%;Agent’s Last Exam 详见基准 | 尚未发布 , 无数据 |
| 综合智能指数 | 未公布统一指数;盲测略优于 GLM-5.3 | — | Artificial Analysis 综合智能指数 : 45分 | AA指数 : 57分 ( 与 Claude Opus 4.8 持平 ) | AA指数 : 40分 ( 高于 V4 Pro 0813 的36分 ) | 尚未发布 , 无数据 |
| 参考价格 | 输入 ¥6/M;输出 ¥18/M;缓存命中 ¥0.3/M | WorkBuddy 免费期延长至9月30日 | 未命中输入 ¥8/M;输出 ¥28/M;缓存命中 ¥2/M | 2.8元/百万tokens输出 | 空闲 : 缓存命中 ¥0.02/M、未命中 ¥1/M、输出 ¥4/M;高峰翻倍 | 当前 V4-Pro 高峰输出 ¥27/M;V4-Pro 将于9月14日下线 , 请求路由至 V4.1-Flash |
| 适用场景 | 长文档分析、办公生产力、游戏开发、科研;1M上下文+深度思考 | 轻量 Agent 任务、小规模部署、成本敏感场景 | 专业编程、仓库级重构、网络安全研究 | 多模态前端/游戏开发、低成本高频调用、视觉编码任务 | 高吞吐 Agent 负载、自动化工作流、长上下文缓存密集场景 | 待发布后评估 |
3、接入 API Key
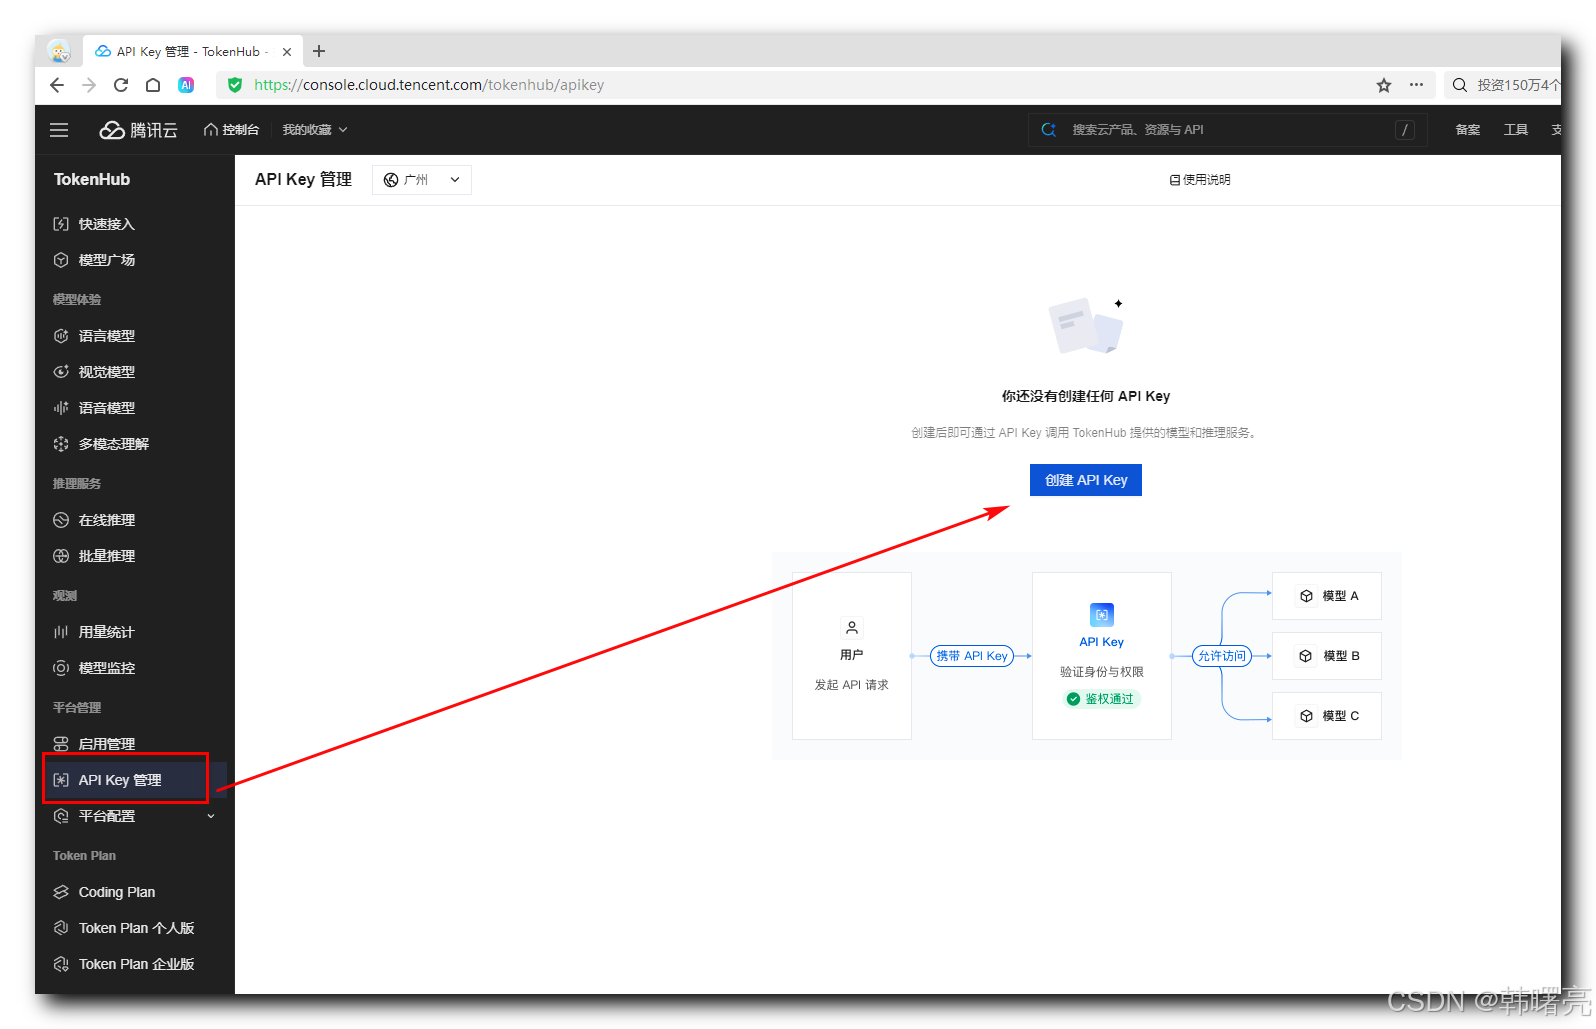
在 TokenHub 的 控制台 中 , 选择 " 平台管理 | API Key 管理 " , 进入 API Key 管理 页面 https://console.cloud.tencent.com/tokenhub/apikey , 点击 " 创建 API Key " 按钮 ;
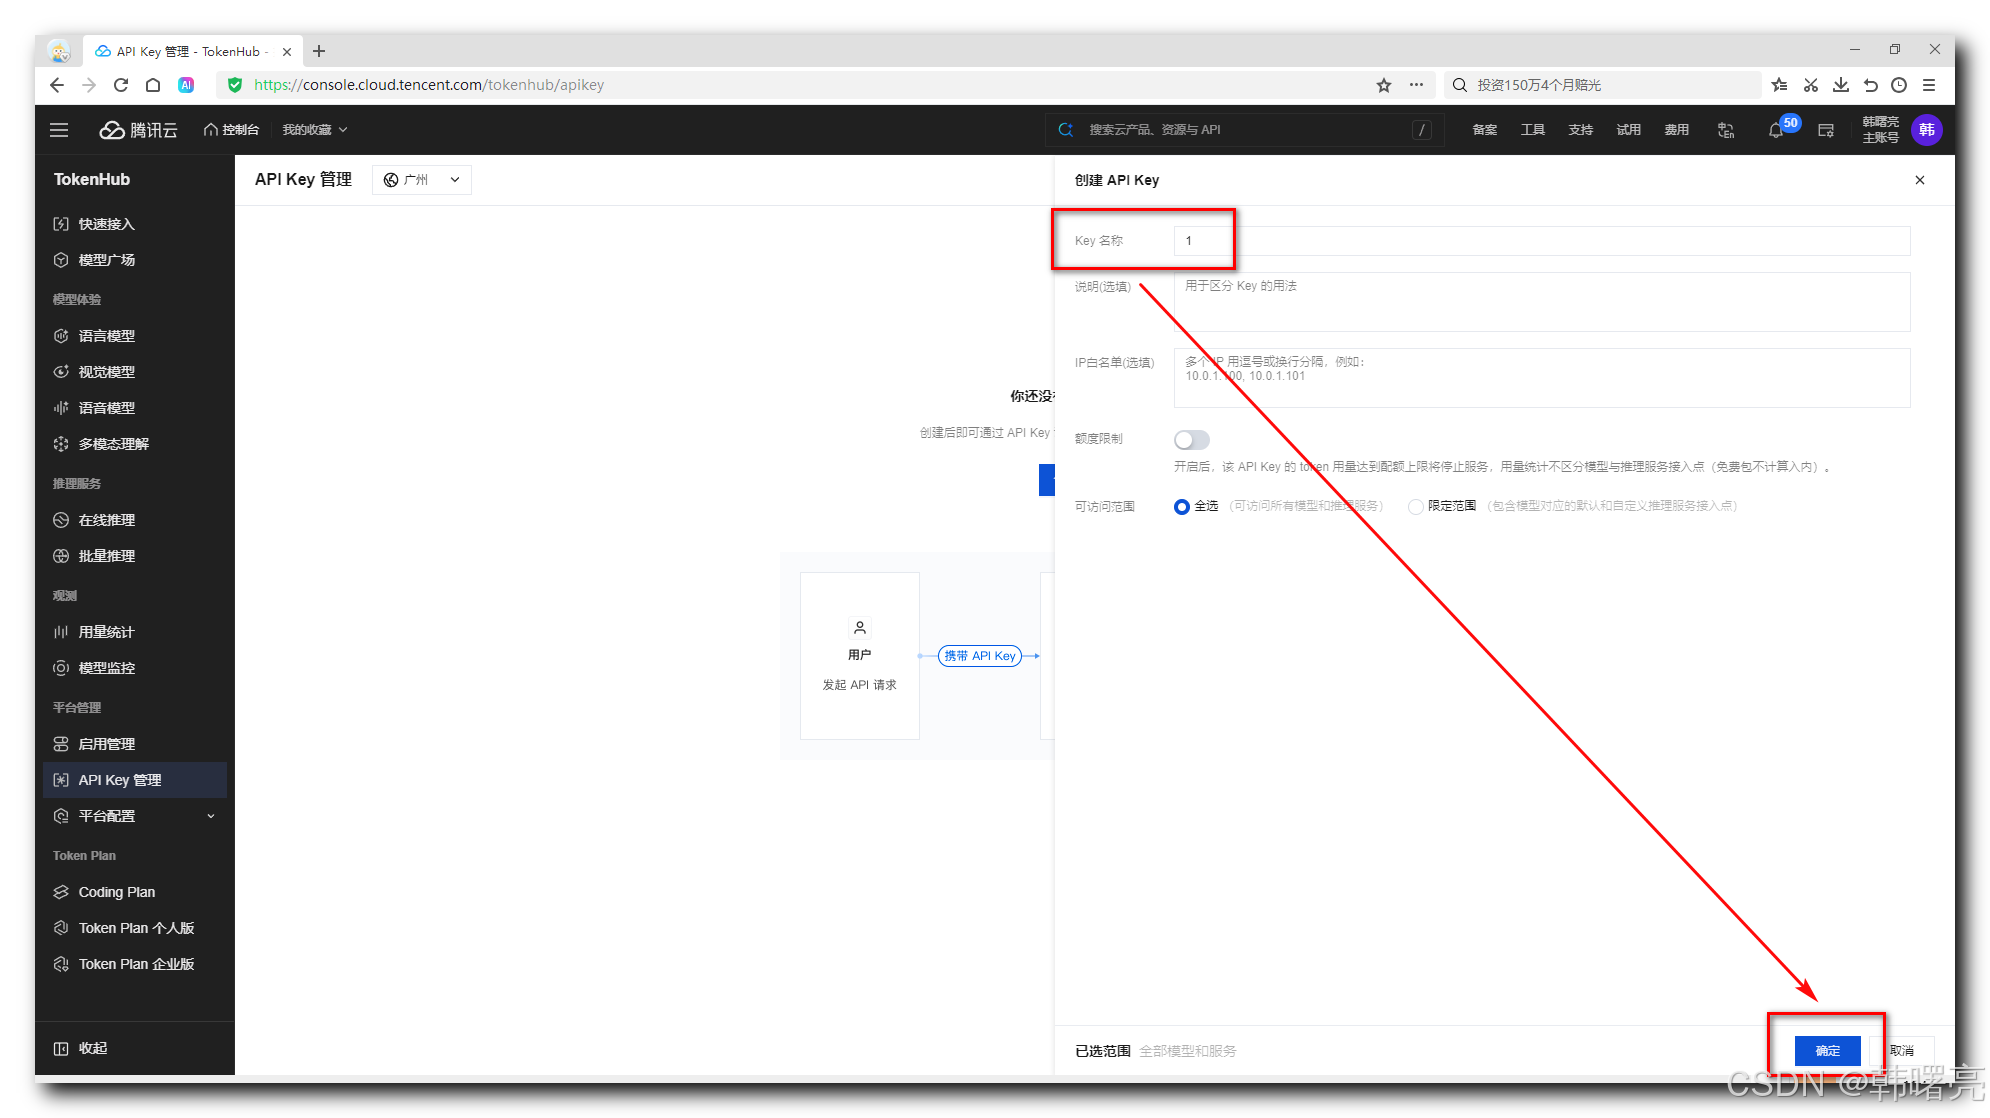
在弹出的对话框中 , 输入 Key 名称 , 其它空着就行 , 然后点击 " 确定 " 完成 API Key 创建 ;
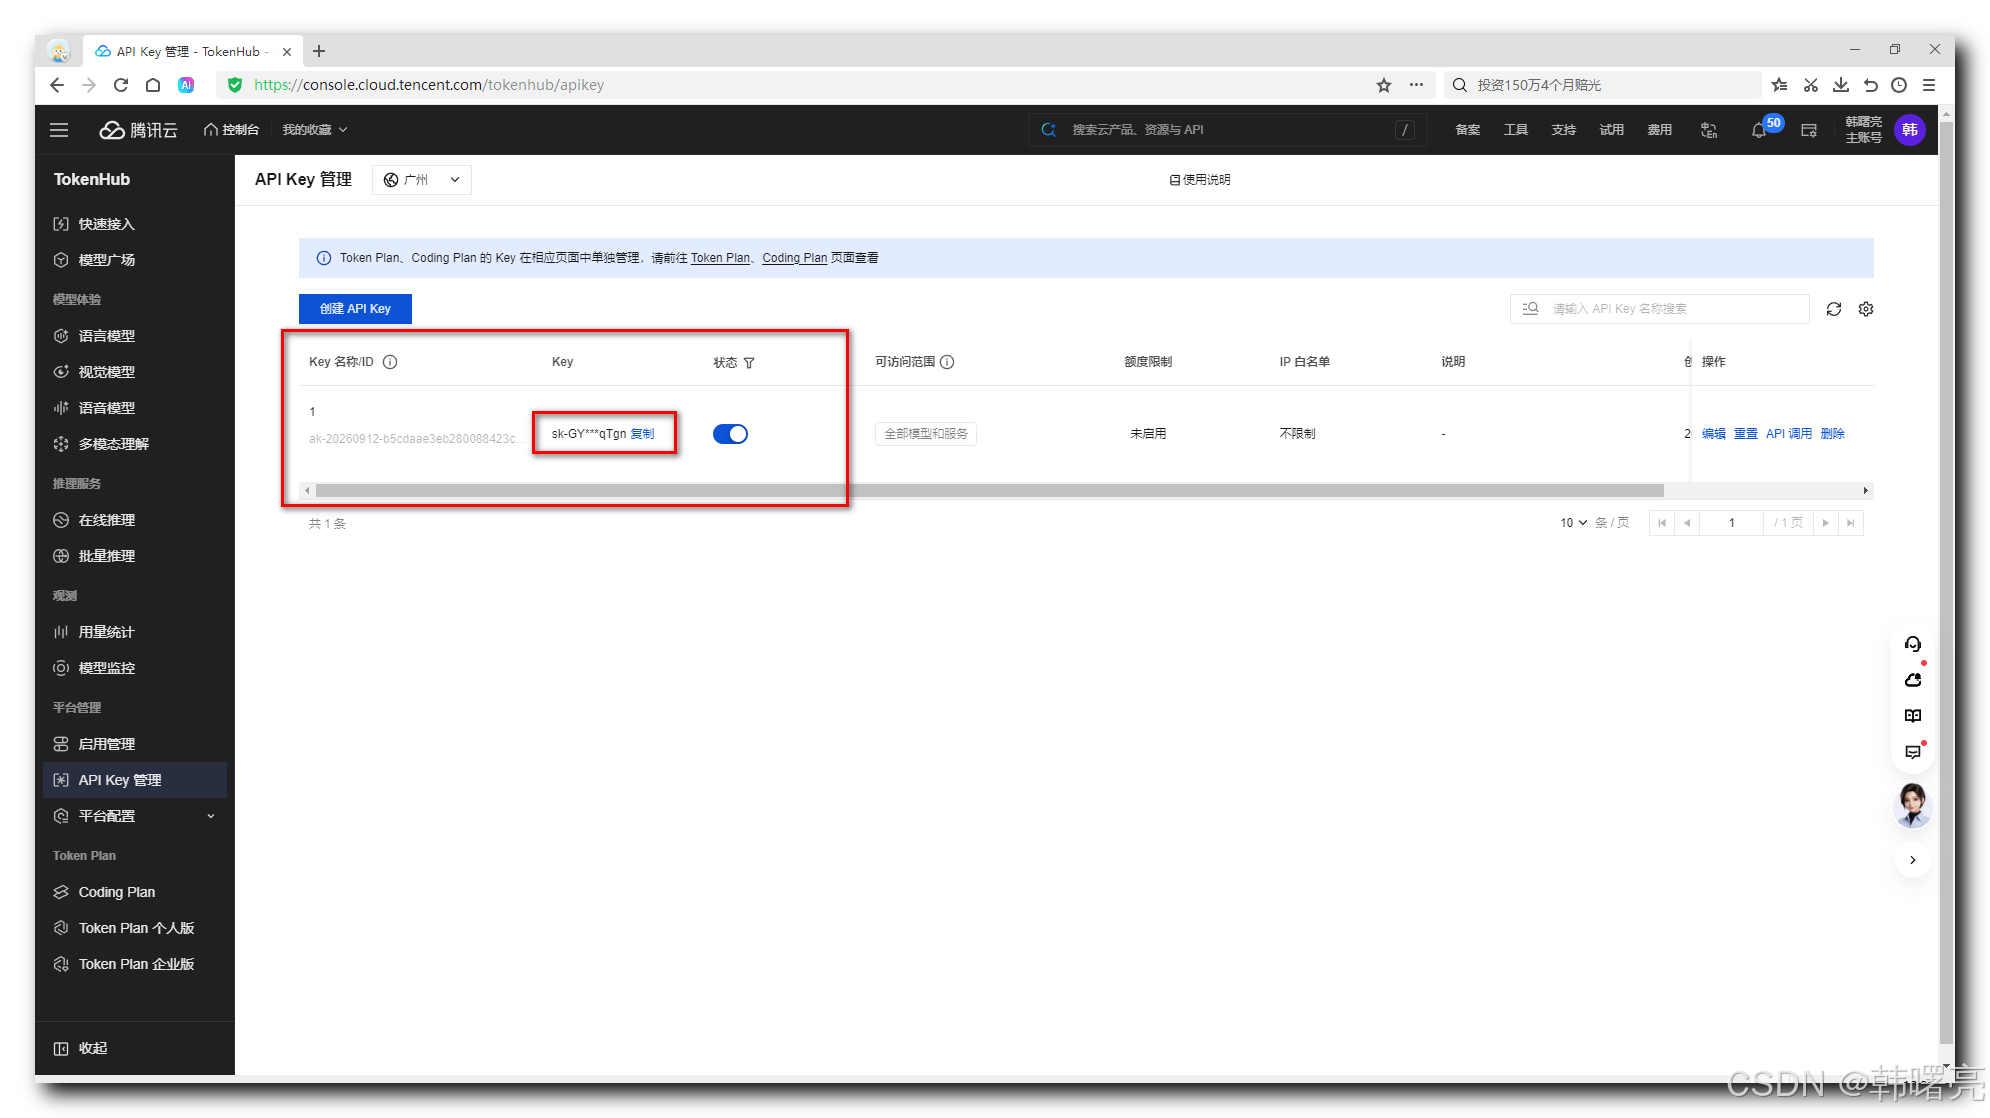
创建 后的 API Key 如下 , 点击 " 复制 " 按钮 , 可以复制该 Key ;
进入 TraeCode , 选择添加自定义模型 ,
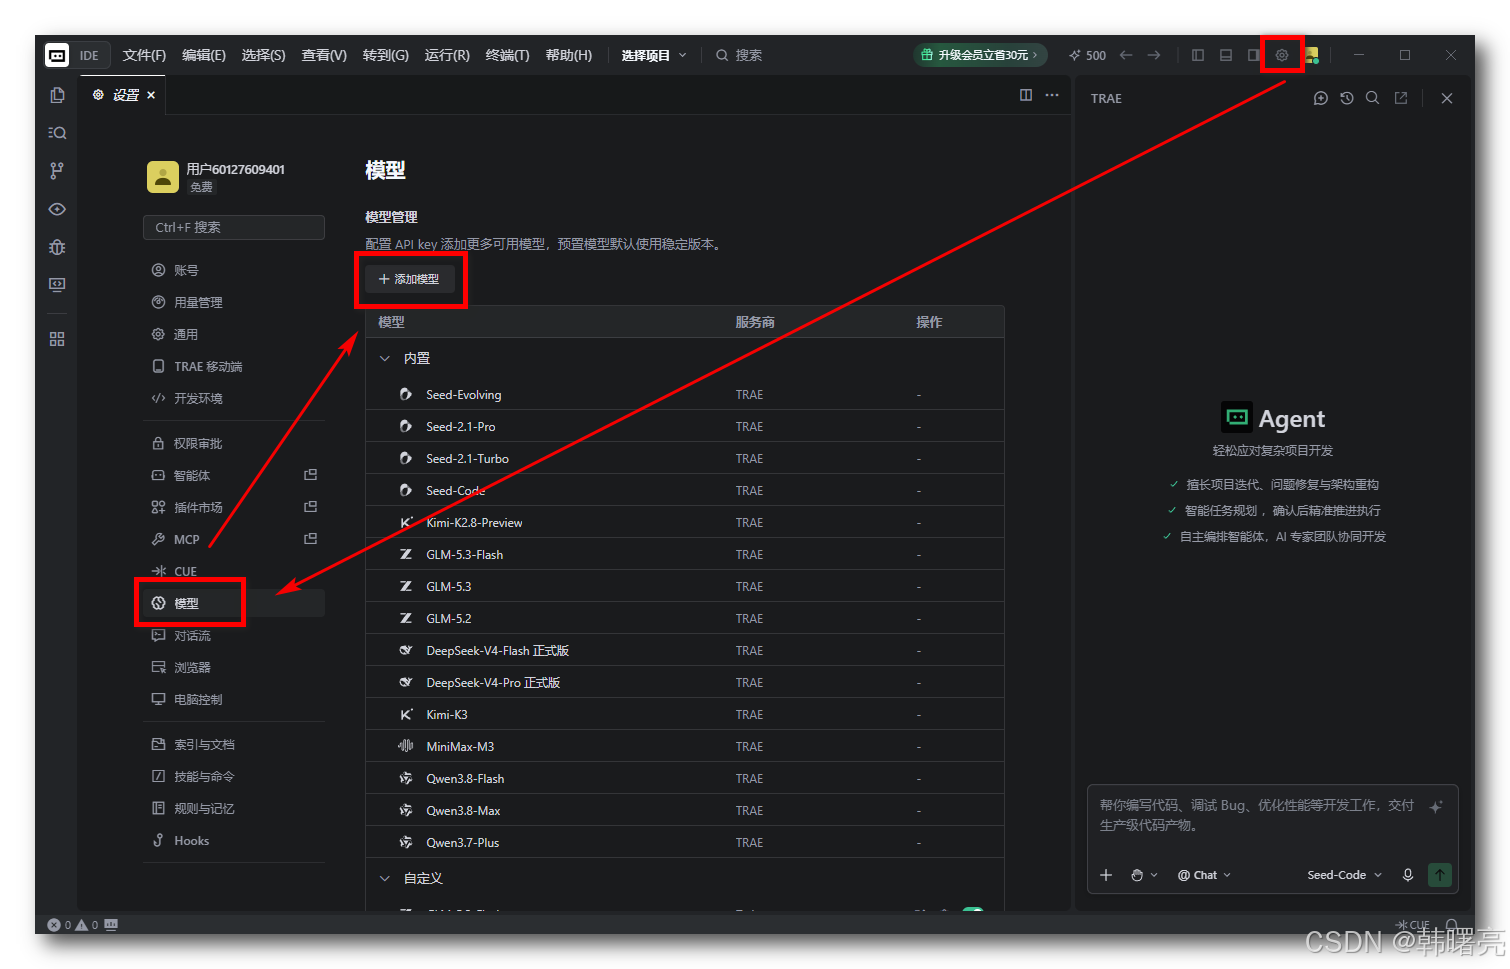
选择 腾讯云 平台 ,
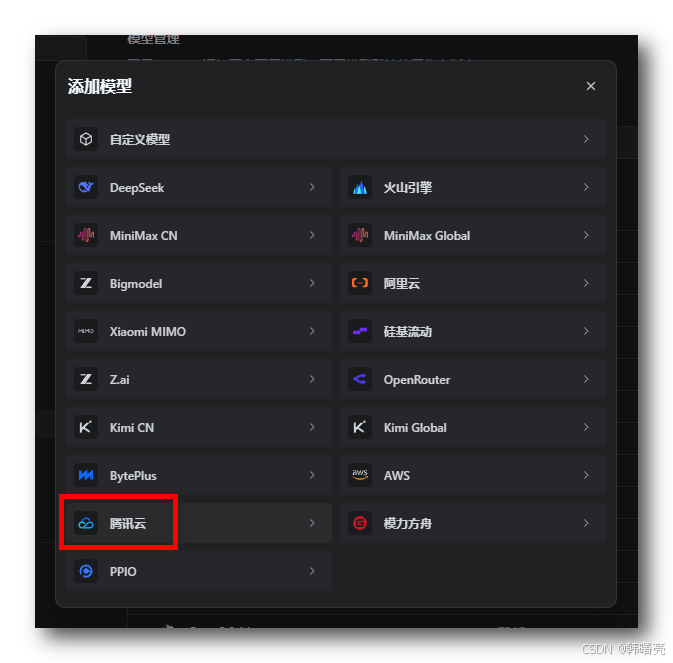
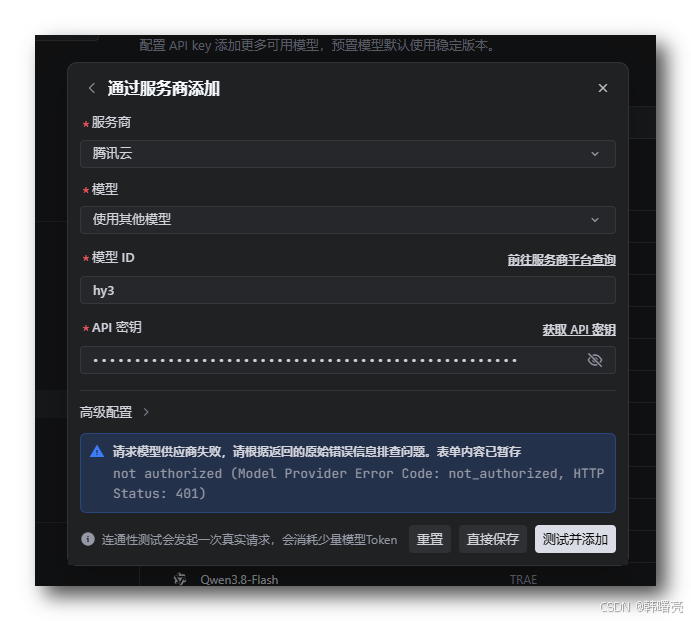
目前 TraeCode 不能接入 腾讯的 hy3 大模型 , 这几个大厂挺会玩 ;
三、千问 AI 平台
1、定价简介
千问 AI 平台 : https://www.qianwenai.com/
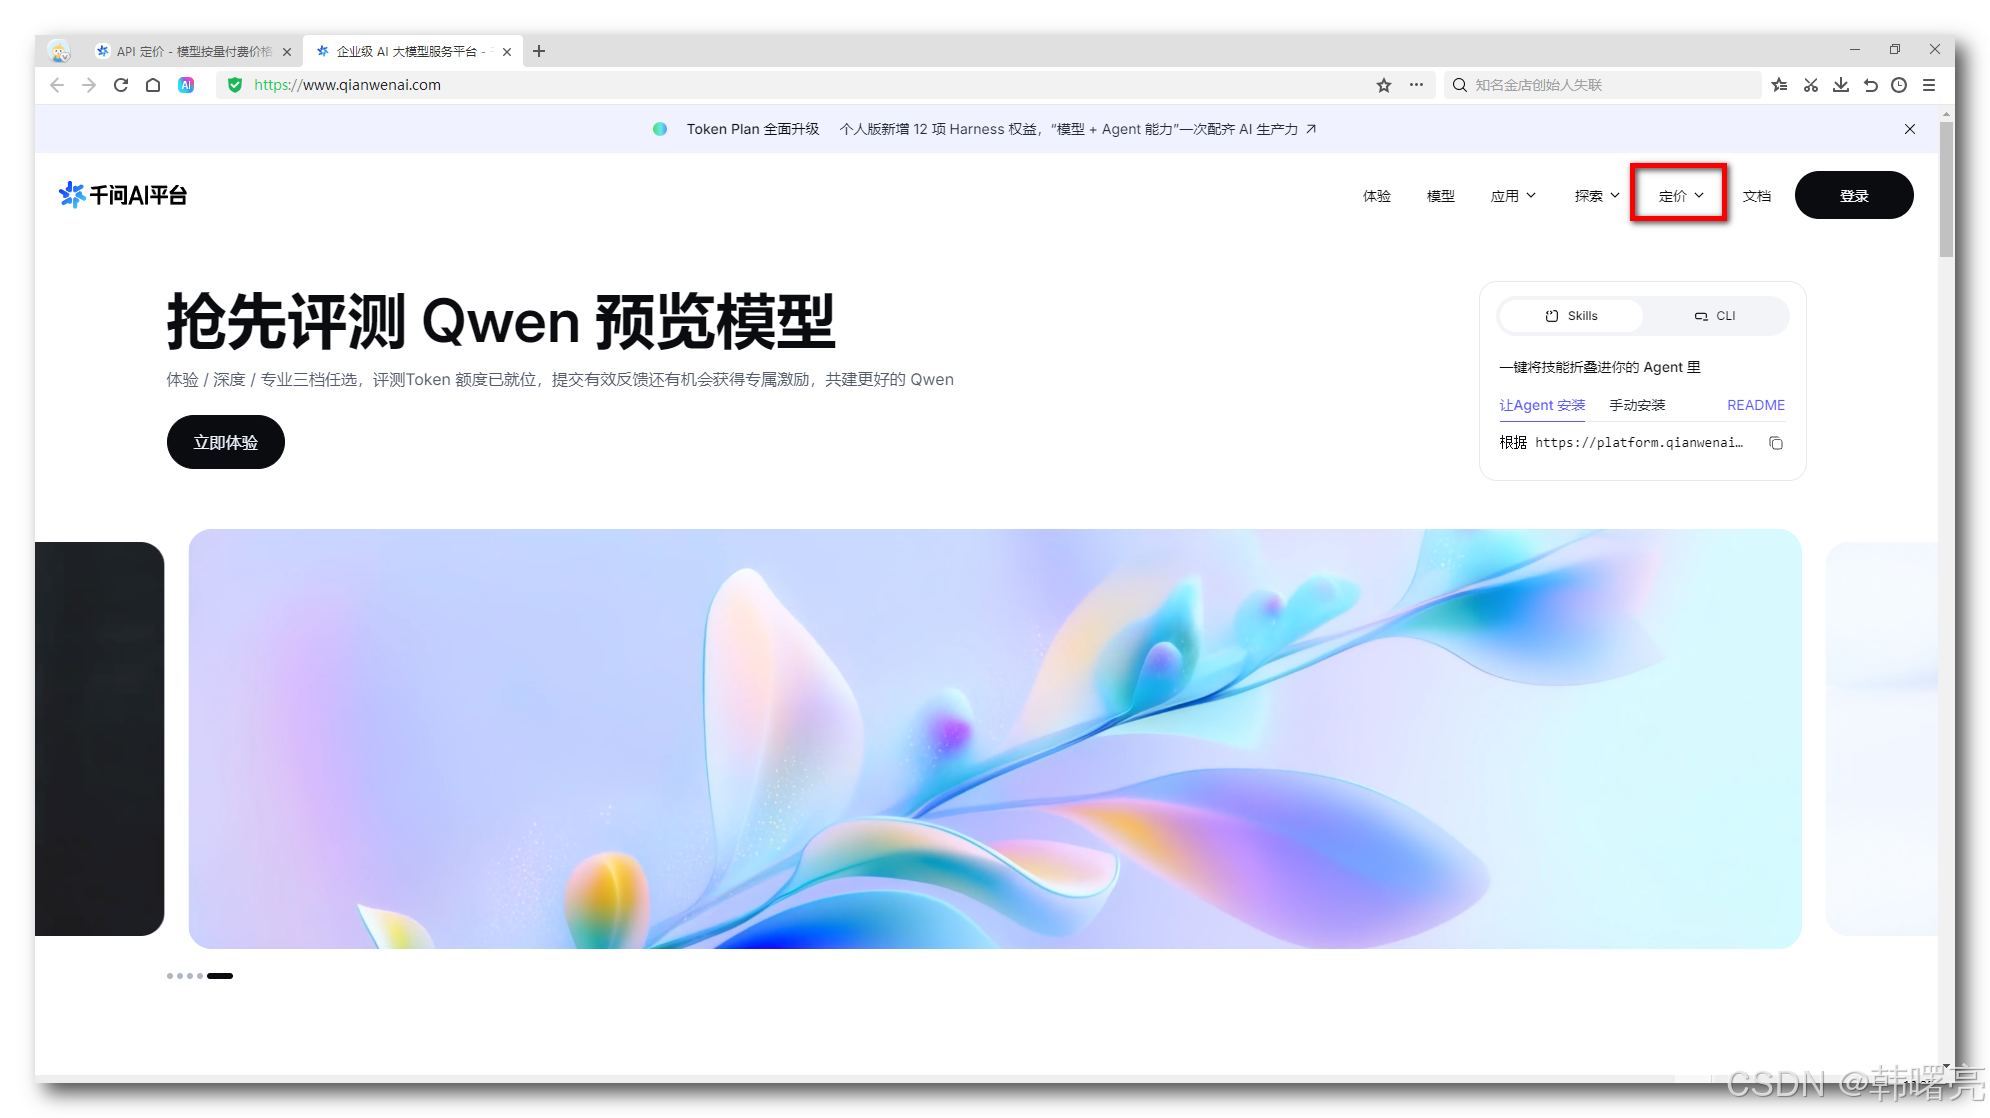
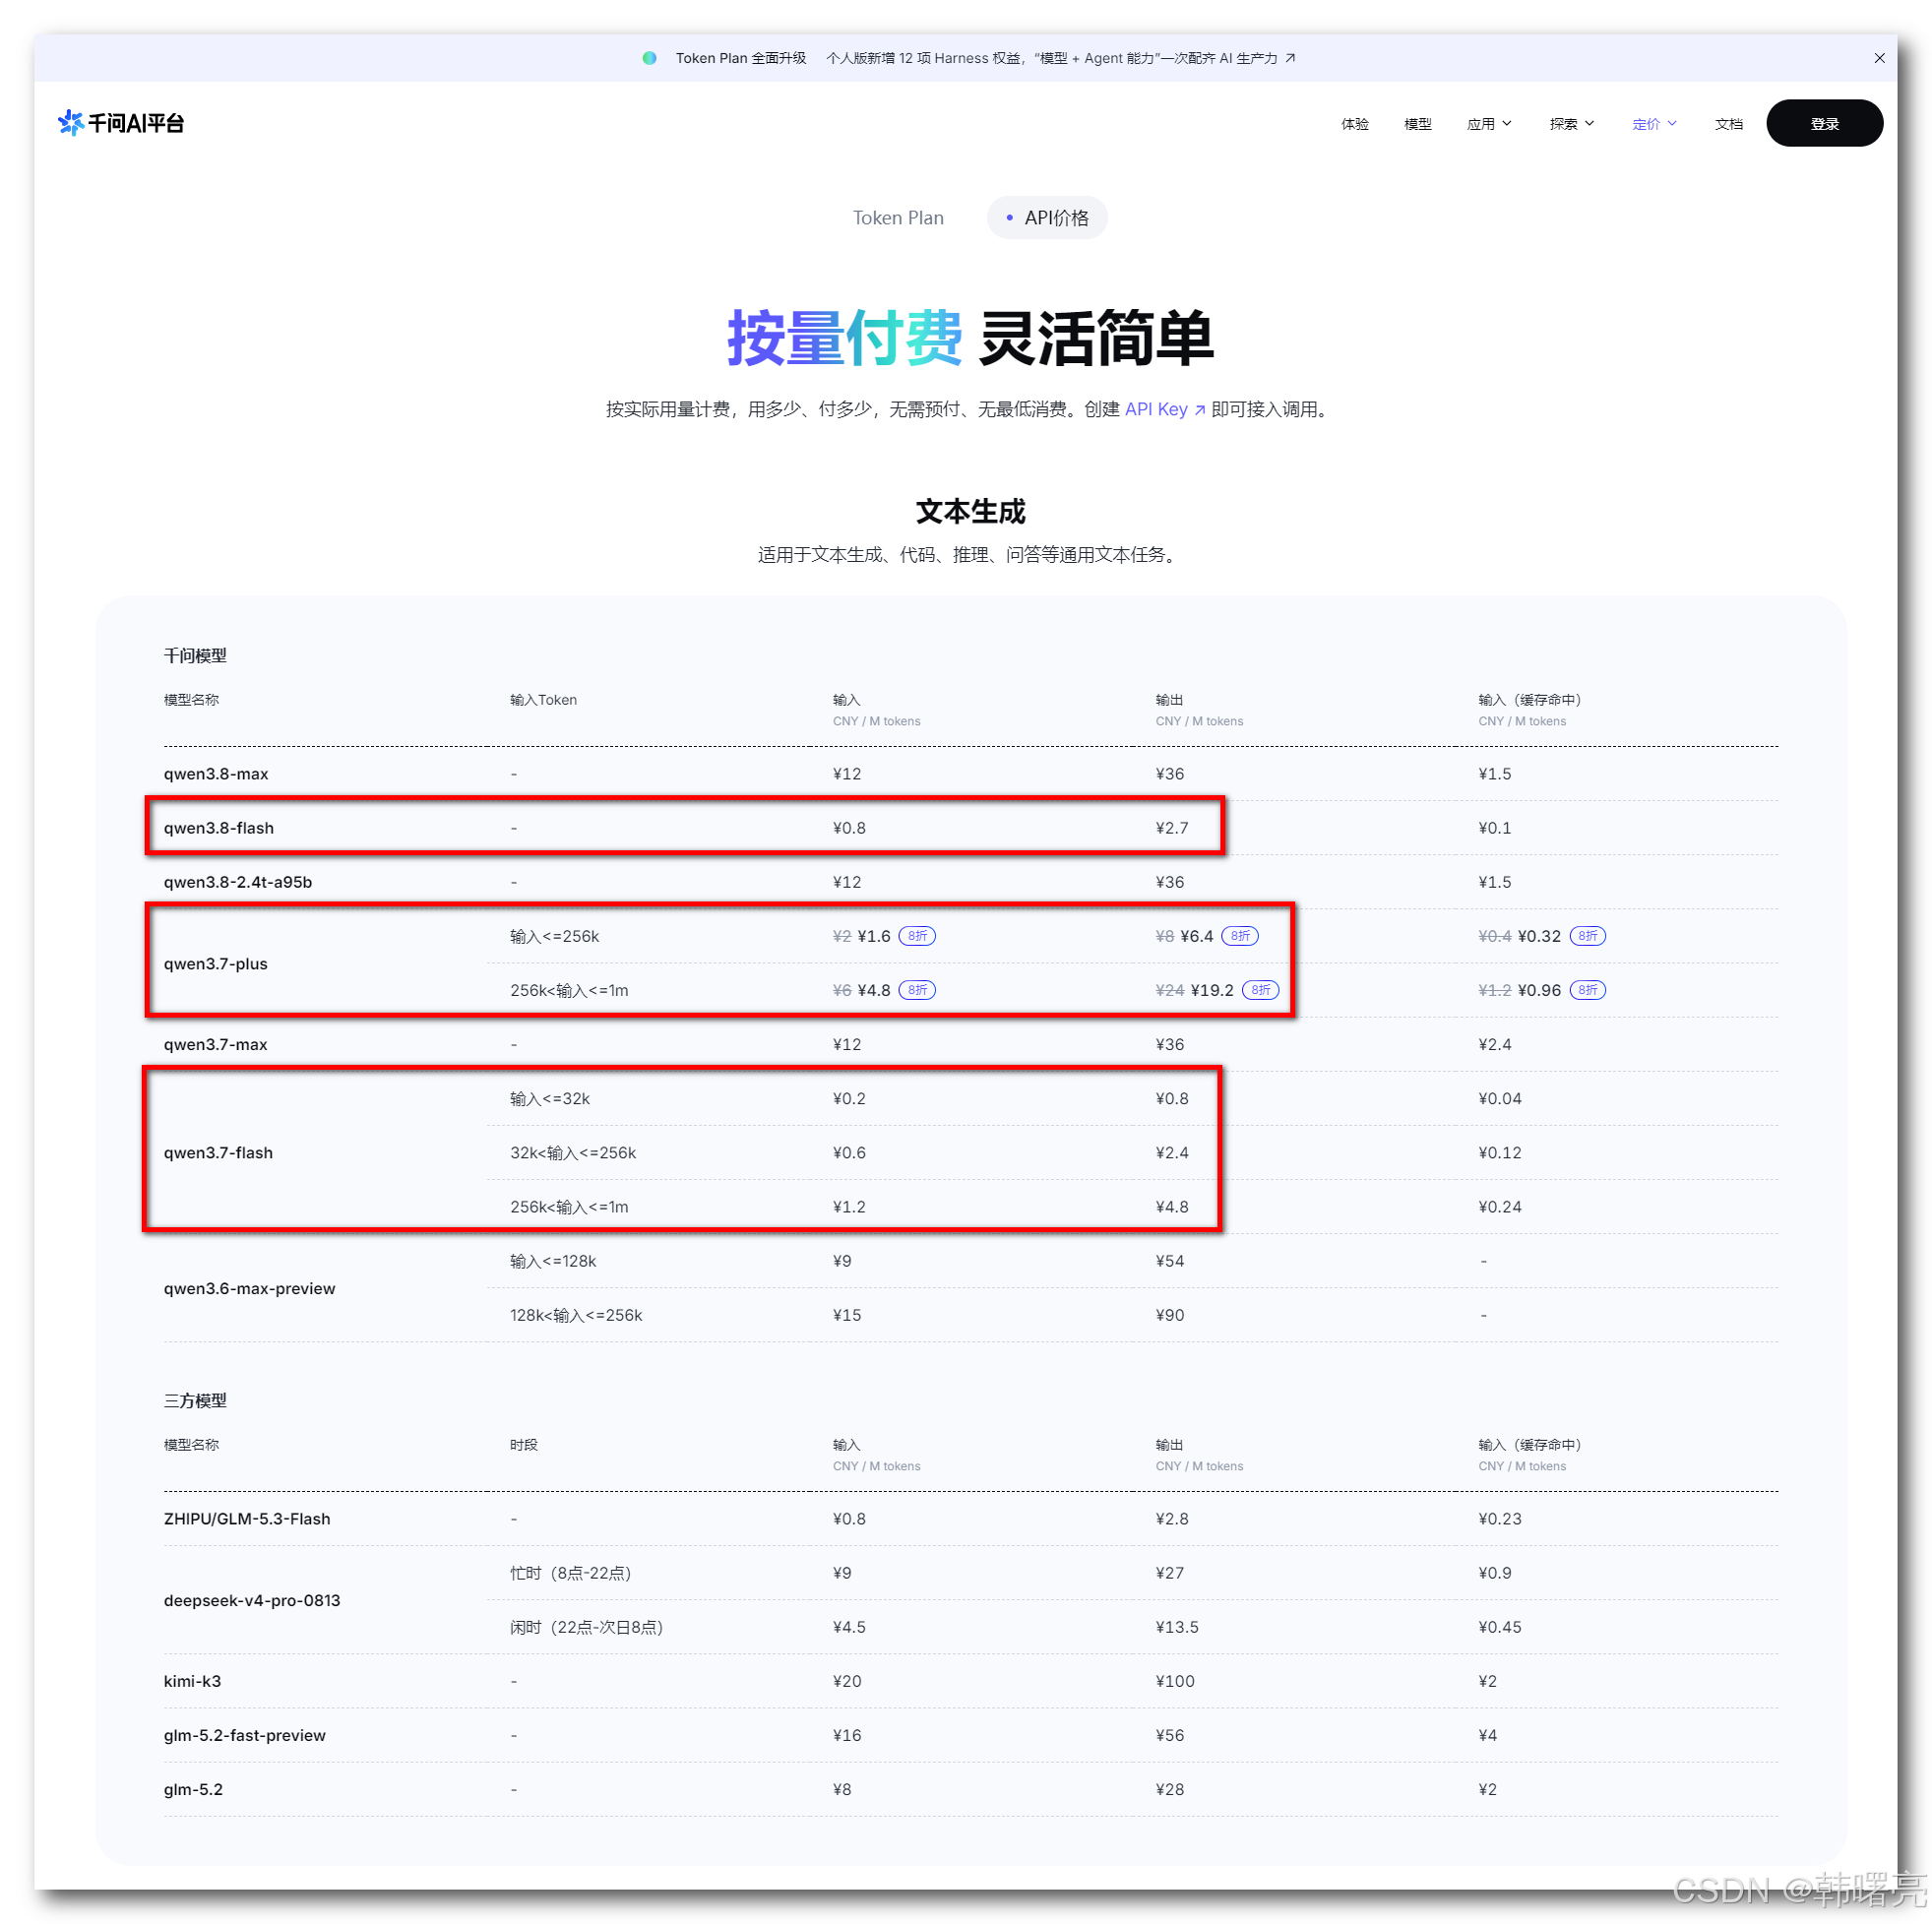
点击 " 定价 " , 查看 各个 千问 大模型 定价价格 : https://platform.qianwenai.com/pricing/api
2、各维度简单对比
| 维度 | Qwen3.8-Max | Qwen3.8-Flash | Qwen3.8-2.4T-A95B | Qwen3.7-Plus | Qwen3.7-Flash | GLM-5.3 | GLM-5.3-Flash | DeepSeek-V4.1-Flash | DeepSeek-V4.1-Pro |
|---|---|---|---|---|---|---|---|---|---|
| 编程能力 | Terminal-Bench 2.1:86.6;长程自动编程突出 | SWE-bench Pro 领先 Opus 4.6 达 9.1 分 | 与 Qwen3.8-Max 共享架构,基准一致 | 通用编程能力,定位均衡型多模态 | 轻量级,弱于 Plus/Max | Terminal-Bench 2.1:88.2;DeepSWE v1.1:66.9 | 原生多模态,可生成可交互代码 | Terminal-Bench 2.1:90.6;DeepSWE v1.1:74.2 | 未发布 |
| Agent 能力 | GDPval:1,739 Elo;AA Agentic 58 | CoWorkBench、Toolathlon Verified 超越 DeepSeek-V4-Flash | 与 Qwen3.8-Max 一致 | 支持工具调用与 Agent 执行 | 支持原生工具调用 | Toolathlon Verified:73.0;ALE-CU 领先 | AutomationBench:46.2 | Automation-Bench:54.8,领先 GLM-5.3 / V4 Pro | 未发布 |
| 定价(每百万 Token,CNY) | 输入 ¥12 / 输出 ¥36 / 缓存命中 ¥1.5 | 输入 ¥0.8 / 输出 ¥2.7 / 缓存命中 ¥0.1 | 输入 ¥12 / 输出 ¥36 / 缓存命中 ¥1.5 | ≤256K:输入 ¥2(8折 ¥1.6)/ 输出 ¥8(8折 ¥6.4)/ 缓存 ¥0.4(8折 ¥0.32) 256K–1M:输入 ¥6(8折 ¥4.8)/ 输出 ¥24(8折 ¥19.2)/ 缓存 ¥1.2(8折 ¥0.96) | ≤32K:¥0.2 / ¥0.8 / ¥0.04 32K–256K:¥0.6 / ¥2.4 / ¥0.12 256K–1M:¥1.2 / ¥4.8 / ¥0.24 | 28元/百万tokens | 2.8元/百万tokens | OpenRouter:输入 $0.15 / 输出 $0.60;国内空闲时段输入 ¥1 / 输出 ¥4 | 未发布 |
| 适用场景 | 全能型 Agent 旗舰,复杂自主任务 | 高性价比 Agent 编程、办公、长程任务 | 开放权重、可自部署旗舰 Agent | 均衡型多模态应用 | 低延迟、高并发轻量交互 | 复杂软件工程、终端、网络安全 | 普惠级原生多模态 | 强执行力 Agent、编程、工具调用 | 未发布 |
| 综合智能指数 | AA Intelligence 58 / AA Agentic 58 | 后训练性能接近 Opus 4.8 | 同 Qwen3.8-Max | 未公布独立指数 | 未公布独立指数 | 多项基准开源第一 | AA Intelligence Index:57 | HLE:36.8;GPQA Diamond:90.9 | 未发布 |
| 注意力设计 | 稀疏 MoE,激活约 95B | QSA + GDN 混合注意力,1M 长上下文提速 8 倍以上 | 同 Qwen3.8-Max | 未公开详细机制 | 未公开详细机制 | 未公开详细机制;MoE 激活 39B | 稀疏注意力 + 线性注意力混合;KV Cache 降低 4.4 倍 | CED 非对称结构:输入激活 8B,输出激活 16B | 未发布 |
| 参数架构 | 总参数 2.4T,激活约 95B | 总参数约 125B,激活 6B | 2.4T / 95B 激活 | 未公开 | 未公开 | 约 743B MoE,激活 39B | 320B MoE,激活 18B | 552B MoE,CED 非对称 | 未发布 |
| 上下文窗口 | 1M 输入 / 约 128K 输出 | 1M | 1M | 1M(最大输入 991K,输出 128K) | 1M(最大输出 65K) | 1M / 128K 输出 | 1M / 128K 输出 | 1,048,576 tokens | 未发布 |
| 是否开源 | 已开源 | 已开源 | 开放权重 | 未开源 | 未开源 | 已开源 | 已开源(MIT) | 已开源 | 未发布 |
| 发布时间 | 2026-08-03 | 2026-08-26 | 2026-08-10 当周 | 2026 年 6 月前后 | 2026 年 7 月前后 | 2026-08-14 | 2026-08-26 | 2026-09-10 | 未发布 |
| 多模态 | 文本、图像、视频 | 原生多模态,图片/视频 | 同 Qwen3.8-Max | 文本、图片、视频 | 原生多模态 | 未突出多模态 | 原生多模态,本地图像处理 | 原生多模态视觉理解 | 未发布 |
| 深度思考 | 非思考 / 思考模式切换 | 支持推理模式 | 同 Qwen3.8-Max | 支持思考模式,最大思维链 256K | 支持推理模式,最大思维链 262K | 支持高档位思考预算 | 未明确强调 | 大规模 RL 后训练,支持工具调用推理 | 未发布 |
重点测试 Qwen3.8-Max 和 Qwen3.8-Flash 版本 ;
3、TraeCode 接入千问模型
TraeCode 接入千问模型 使用如下参数 :
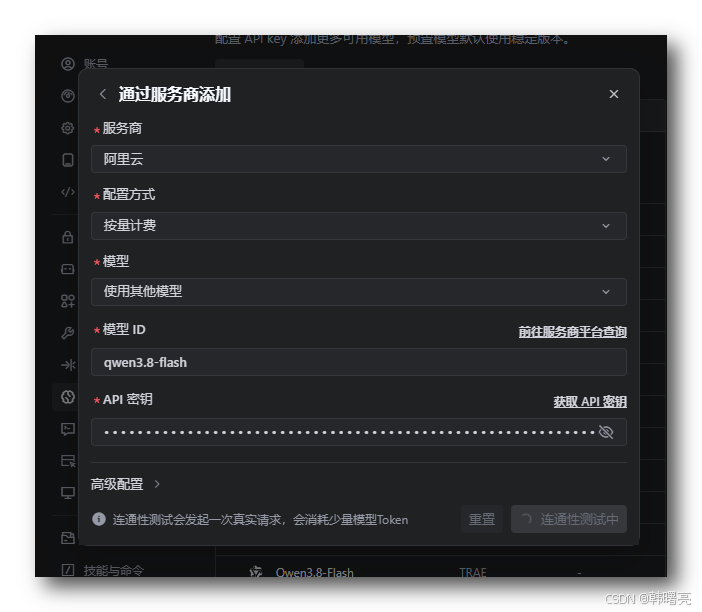
自定义设置 模型 ID , 模型 ID 名称 都是小写字母 , 不要出现大写字母 ;
可设置的 模型 ID : qwen3.8-max、qwen3.8-flash、qwen3.7-plus、qwen3.7-max、qwen3.7-flash ;
AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐


 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)