
第 4 篇:「外围能力三件套」—— 浏览器、搜索与数据可视化管线
第 4 篇:「外围能力三件套」—— 浏览器、搜索与数据可视化管线
系列:OpenManus 源码级深度解读(master @
3309bf4e416fb1c74b008f3e86494439a31bad53)
本篇覆盖:DeepWiki ch5.2(Browser Tool)/ ch5.3(Web Search)/ ch5.5(Data Visualization)
核心源码:app/agent/browser.py(114 行)、app/tool/web_search.py(418 行)、app/tool/crawl4ai.py(269 行)、app/tool/chart_visualization/data_visualization.py(263 行)、app/tool/chart_visualization/chart_prepare.py(38 行)
阅读本文你将了解: 为什么"浏览器能力"其实是一个 MCP 插件而不是内置工具;四引擎搜索的三层重试如何编排;Python 图表为什么要绕道 Node.js 子进程渲染;以及这一篇里埋着的三个真实 bug——包括一个会误导 LLM 传错参数的 schema 错误。
1. 内核之外:能力靠生态补齐
01 篇拆执行引擎时有一条重要发现:Manus 的默认四工具(app/agent/manus.py:57-64)里没有浏览器、没有搜索。这和多数人的直觉相反——一个"通用 Agent",怎么会不自带上网能力?
答案是 OpenManus 的能力哲学:内核只保留最稳定的能力(代码、文件、人机问答),高频变化的外围能力靠动态挂载。浏览器走 MCP 插件(uvx browser-use --cli-mcp,无配置时自动拉起,app/agent/manus.py:83-99),搜索是独立工具类,可视化是独立的双工具管线。这一篇把三件套逐个解剖,重点不在功能演示,而在它们各自解决"内核如何与易变能力解耦"这个同一命题的不同手法。
2. 浏览器:一个披着 Agent 外衣的 MCP 插件
BrowserAgent 的类声明只有 31 行(app/agent/browser.py:83-114),全部秘密在继承链和初始化参数里:
# app/agent/browser.py:95-103
async def initialize(self) -> None:
    await super().initialize(
        connection_type="stdio",
        command="uvx",
        args=["browser-use", "--cli-mcp"],
        server_id="browser_use",
        tool_name_prefix=False,
    )
    self.available_tools.add_tool(Terminate())
它继承自 MCPAgent(05 篇主角),initialize() 做的事是:用 stdio 方式把 uvx browser-use --cli-mcp 当作 MCP 服务器拉起——uvx 会自动从 PyPI 安装并运行 browser-use 的 CLI MCP 模式,BrowserAgent 的全部浏览器能力(导航、点击、截图)都来自这个外部进程暴露的 MCP 工具。tool_name_prefix=False 让远端工具保持原始名字(不加 mcp_browser_use_ 前缀),system_prompt 里教的 browser_exec/browser_screenshot 正是 browser-use CLI 的工具名(app/agent/browser.py:88-93)。
所以"浏览器 Agent"的真实身份是:一个把 browser-use 项目当能力包加载的薄壳。OpenManus 自己不写一行 Playwright 调用。这与 01 篇的发现完全对上:Manus 无浏览器配置时自动 uvx browser-use --cli-mcp(app/agent/manus.py:83-99),BrowserAgent 只是把这个隐式行为做成了显式的独立入口。run() 里的懒初始化(app/agent/browser.py:111-114,sessions 空则补 initialize)延续了"构造与初始化分离"的框架惯例。
有意思的是并存着另一条浏览器路径:BrowserContextHelper(app/agent/browser.py:19-80)面向的是沙箱内的 sandbox_browser 工具(常量定义在 app/agent/browser.py:16)——那是 Docker 沙箱里跑 VNC 浏览器的方案(06 篇展开)。两条路径的存在说明浏览器能力经历过架构迁移:从内置沙箱浏览器迁向 browser-use MCP 插件,BrowserContextHelper 是旧路径的遗迹,现在主要服务于 SandboxAgent。它的截图注入手法仍然值得一看:
# app/agent/browser.py:61-67
if self._current_base64_image:
    image_message = Message.user_message(
        content="Current browser screenshot:",
        base64_image=self._current_base64_image,
    )
    self.agent.memory.add_message(image_message)
    self._current_base64_image = None  # Consume the image after adding
截图作为带 base64 的 user 消息插入 memory,插完立即置 None——"用后即焚"防止同一张截图在后续每一步重复进入上下文(token 灾难)。这个 consume-once 模式是多模态 Agent 管理视觉上下文的通用手法,配合 02 篇讲的 format_messages 把 base64_image 转成 OpenAI image_url content(app/llm.py:304-339),构成完整的截图进 LLM 链路。
3. WebSearch:四引擎回退链的三层重试
WebSearch(app/tool/web_search.py:156-408)的结构是"一个工具门面 + 四个引擎实现 + 一个内容抓取器"。核心韧性设计是引擎回退链:
# app/tool/web_search.py:360-385(节选)
def _get_engine_order(self) -> List[str]:
    preferred = ...  # 配置的主引擎,默认 google
    fallbacks = ...   # 配置的回退列表,默认 DuckDuckGo→Baidu→Bing
    # 主引擎 → 回退引擎 → 剩余引擎
    engine_order = [preferred] if preferred in self._search_engine else []
    ...
    engine_order.extend([e for e in self._search_engine if e not in engine_order])
优先级合成规则:配置主引擎打头,配置回退引擎随后,字典里剩下的引擎兜底(app/tool/web_search.py:383)——即使配置写漏了,四个引擎也都会被尝试。这个"配置优先、全集兜底"的顺序合成是个值得抄的小模式。整条回退链的执行顺序如下图:
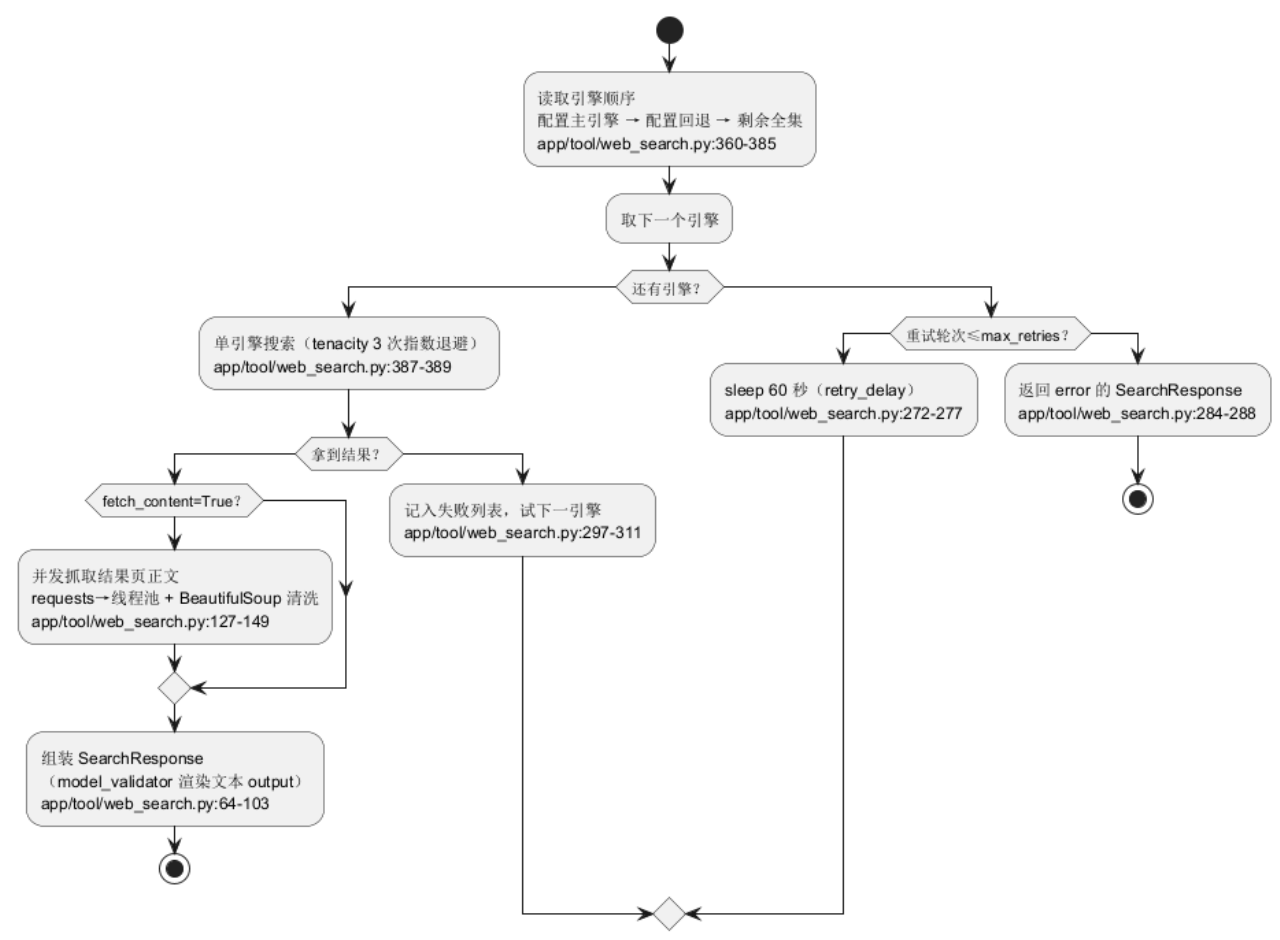
这张流程图把三层重试的时间尺度画在了一条路径上:单引擎框内的 tenacity 循环管秒级抖动,"试下一引擎"的分支管分钟级单点故障,外层的 60 秒休眠管小时级限流。注意失败路径的成本结构——最坏情况(四引擎 × 3 次重试 × 3 轮)会产生 36 次 HTTP 尝试外加 3 分钟休眠,全部发生在一次工具调用的观察值等待里,Agent 的 LLM 请求此时是挂起的;生产部署把这个时间预算显式纳入考量(第 7 节)。
重试分三层,各自语义不同:
- 单引擎内重试:
_perform_search_with_engine挂 tenacity 装饰器,3 次 + 1~10 秒指数退避(app/tool/web_search.py:387-389)——对付单引擎的偶发抖动; - 跨引擎回退:
_try_all_engines按顺序逐个试,某个引擎成功立即返回(app/tool/web_search.py:290-327)——对付单引擎的持续故障(如 Google 被墙); - 全链休眠重试:四个引擎全挂时睡
retry_delay(默认 60 秒)再来一轮,最多max_retries(默认 3)轮(app/tool/web_search.py:252-282)——对付临时限流(两个参数都来自 02 篇讲过的SearchSettings,app/config.py:45-52)。
三层各管一个时间尺度的故障:秒级抖动、分钟级单点故障、小时级区域限流。这个分层值得直接搬进任何多供应商容错设计。
内容补全路径是可选项:fetch_content=True 时对每个结果页并发抓取(asyncio.gather,app/tool/web_search.py:329-350),WebContentFetcher.fetch_content 用 requests 丢进线程池避免阻塞事件循环(app/tool/web_search.py:127-129),BeautifulSoup 剥掉 script/style/header/footer/nav 后取纯文本,截断到 10000 字符(app/tool/web_search.py:138-149)。
结构化响应是本文件的精品:SearchResponse 继承 ToolResult,用 Pydantic model_validator(mode="after") 在校验后自动把结构化结果渲染成给 LLM 看的文本 output(app/tool/web_search.py:64-103)——一份结构化数据、两种视图:模型看文本,代码看字段。但这里有一个幽灵字段:
# app/tool/web_search.py:261-263
return SearchResponse(
    status="success",
    ...
)
SearchResponse 及其父类都没有 status 字段,Pydantic v2 对未声明字段默认 ignore,所以这行不报错但也完全无效——一个想表达"成功状态"却没落地的字段。它无害,却是"改了返回结构忘了改调用方"的典型残留,代码评审时这类静默丢弃最该被 lint 出来。
4. Crawl4aiTool:为 LLM 定制的内容抽取
Crawl4aiTool(app/tool/crawl4ai.py:16-100+)接的是 Crawl4AI 库,卖点是输出干净的 Markdown(相对 WebSearch 里 BeautifulSoup 的纯文本抽取,保留了标题/列表/链接结构,对 LLM 更友好),支持一次多 URL、JS 重站点。实现上是薄封装:URL 校验(_is_valid_url,非法跳过并告警,app/tool/crawl4ai.py:90-99)→ 库调用 → ToolResult 打包,限流参数 timeout 5-120 秒、word_count_threshold 都在 schema 里约束(app/tool/crawl4ai.py:43-60)。
选型上 WebSearch 的 fetch_content(纯文本、快、零浏览器)和 crawl4ai(Markdown、可处理 JS 渲染、慢)是互补而非竞争关系,schema 描述里各自的教学文案也引导模型按需选择——又一次"工具描述即提示词"(03 篇第 9 节)。
execute 内部有几个值得点名的实现细节。延迟导入:from crawl4ai import ... 写在 execute 函数体内而非模块顶(app/tool/crawl4ai.py:102-108)——crawl4ai 拖着 playwright 一大家子依赖,顶层 import 会让不用爬虫的部署直接启动失败,放进函数体把依赖成本转嫁给"真的用到这个工具"的运行时刻,这是重依赖工具的标准手法(对比 03 篇 PythonExecute 的顶层 import,两种选择各有代价)。双配置分离:BrowserConfig 管浏览器(headless chromium、忽略 HTTPS 证书错误、app/tool/crawl4ai.py:111-117),CrawlerRunConfig 管单次爬取(CacheMode 二态、iframe 处理、去浮层、剔除 script/style、wait_until="domcontentloaded",app/tool/crawl4ai.py:120-129)——domcontentloaded 而非 networkidle 意味着宁可早返回也不等长尾请求,与 timeout 上限 120 秒共同构成"快而糙"的取舍。串行而非并发:多 URL 用 for 循环逐个 crawler.arun(app/tool/crawl4ai.py:136-137),每个 URL 独立计时(app/tool/crawl4ai.py:140-145)——没有用 asyncio.gather,N 个 URL 就是 N 倍墙钟时间;对一个自称高性能的爬虫封装来说,这是最容易被吐槽的实现选择,好在共享同一个浏览器实例(AsyncWebCrawler 的上下文管理器在循环外,app/tool/crawl4ai.py:136),省掉的是每 URL 的浏览器冷启动。
5. 数据可视化:两工具接力的跨语言管线
可视化是本篇结构最奇特的部分:它不是"Python 画图",而是 Python 准备数据 → Node.js 渲染图表的两段式管线,由两个工具接力:
第一棒 visualization_preparation(app/tool/chart_visualization/chart_prepare.py:4-38):继承自 NormalPythonExecute(PythonExecute 的变体),让 LLM 写 Python 代码完成数据清洗,把每个待画图的数据集存成 csv,并生成一份 json 清单(格式 {"csvFilePath": ..., "chartTitle": ...})。代码怎么清洗数据由模型自由发挥,唯一的硬约束是 json 的落盘格式——写在 38 行的 code 参数描述里(app/tool/chart_visualization/chart_prepare.py:20-34),又一份巨型提示词型 schema。
第二棒 data_visualization(app/tool/chart_visualization/data_visualization.py):读 json 清单 → pandas 读 csv 转记录集(app/tool/chart_visualization/data_visualization.py:97-113)→ 并发调用 invoke_vmind → 输出 png/html 图表。核心在 invoke_vmind:
# app/tool/chart_visualization/data_visualization.py:244-255(节选)
process = await asyncio.create_subprocess_exec(
    "npx", "ts-node", "src/chartVisualize.ts",
    stdin=asyncio.subprocess.PIPE, stdout=...,
    cwd=os.path.dirname(__file__),
)
input_json = json.dumps(vmind_params, ensure_ascii=False).encode("utf-8")
stdout, stderr = await process.communicate(input_json)
每张图起一个 Node 子进程,参数从 stdin 灌 JSON,结果从 stdout 读 JSON(app/tool/chart_visualization/data_visualization.py:244-261)。chartVisualize.ts 内部用的是 VMind——字节跳动 VisActor 生态的智能可视化库。为什么要绕道 Node?因为 VMind 只有 JS 实现,而它的"数据→图表配置"智能推荐能力没有对等替代品。为了借用一个 JS 生态的库,付出的代价是:部署端多出 Node.js + ts-node 依赖、每图一个进程的启动开销、跨进程序列化的调试成本——这是一个明确意识到代价仍然选择的功能性妥协,理由写在了架构上:图表质量优先于部署简单。两棒接力的完整管线如下图:
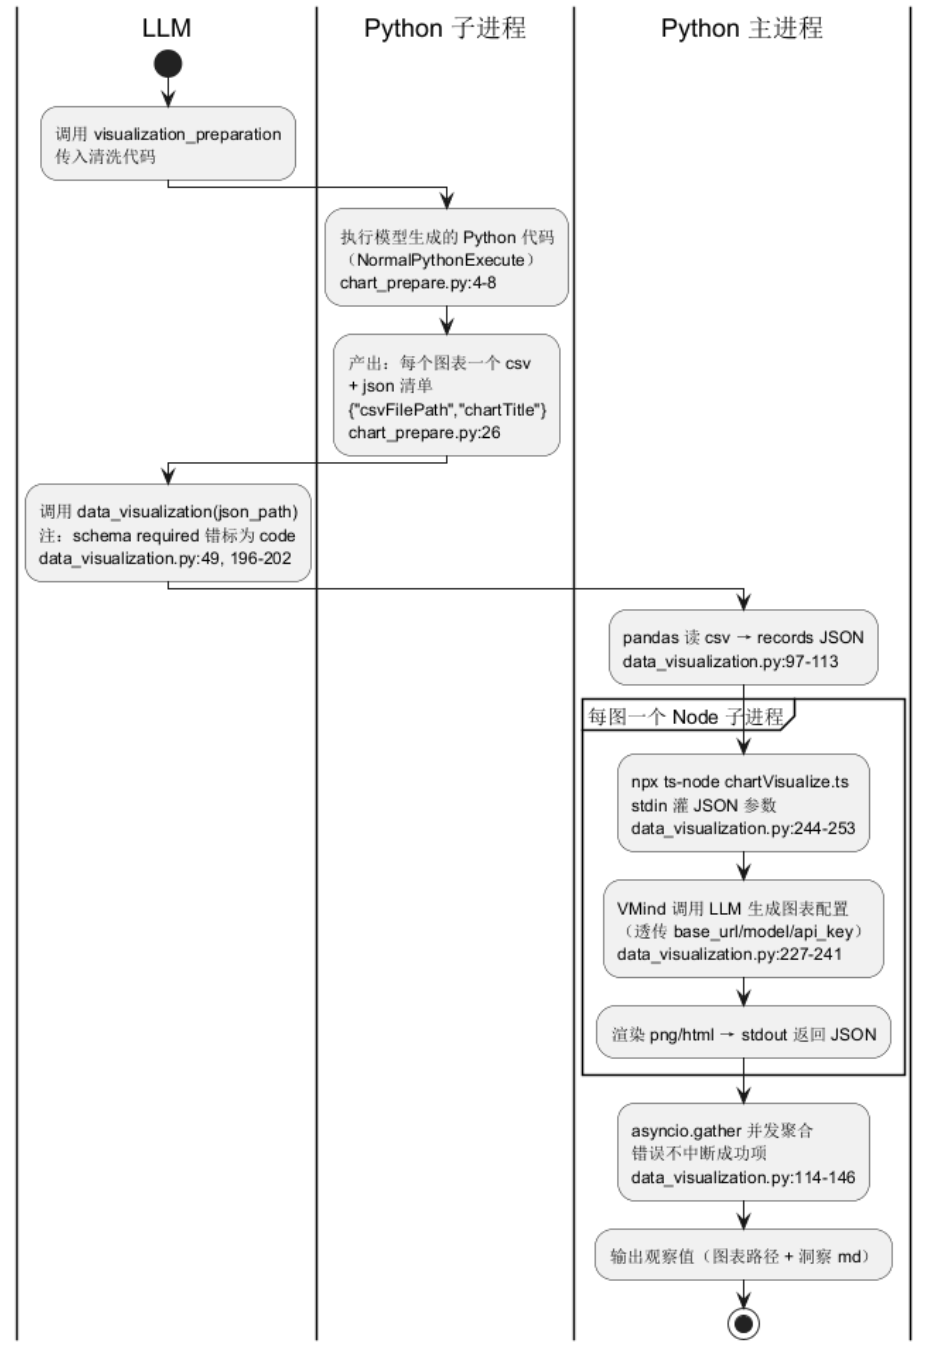
泳道图里有两个部署敏感点:一是管线横跨 Python 主进程、模型生成的任意代码、Node 子进程三个执行域,只有中间的 csv/json 文件契约是稳定接口——任何一端的实现都可以独立替换,这是两段式设计的真正收益;二是 partition 内部的 VMind 环节自带一次 LLM 调用(配置透传),意味着这条管线对 LLM API 的依赖是两处(Python 侧写清洗代码 + Node 侧生成图表配置),故障排查时要先分清是哪一端的 LLM 出了问题。
另一个值得注意的细节:VMind 本身需要 LLM 生成图表配置,所以 invoke_vmind 把 Python 侧的 LLM 配置(base_url/model/api_key)透传给 Node 侧(app/tool/chart_visualization/data_visualization.py:227-231)——一次数据可视化实际消耗两次 LLM 调用(Python 侧写清洗代码、Node 侧生成图表配置),计费和延迟都翻倍,部署文档若不明说,用户很容易对"画张图怎么这么慢"感到困惑。
6. 一个会误导 LLM 的 schema 错误
本篇最重要的 bug 在 data_visualization 的参数 schema 里:
# app/tool/chart_visualization/data_visualization.py:23-49(节选)
parameters: dict = {
    "type": "object",
    "properties": {
        "json_path": {...}, "output_type": {...},
        "tool_type": {...}, "language": {...},
    },
    "required": ["code"],   # ← execute 的签名里根本没有 code
}
properties 声明的是 json_path 等四个参数,required 却写着 ["code"]——而 execute() 的真实签名是 execute(json_path, output_type, tool_type, language)(app/tool/chart_visualization/data_visualization.py:196-202)。LLM 读到 schema 会认为必须传一个 code 字符串参数,json_path 反而看起来是可选的。最可能的实际后果是模型同时传 code(被忽略)和 json_path,或者只传 code 然后工具报错"缺少 json_path"——错误信息又不会指出 schema 本身错了,模型会反复重试传参。手写 JSON Schema 模式(03 篇第 2 节)的维护风险在这里兑现了:schema 与函数签名之间没有任何机制保证一致,全靠人肉对齐。同文件还有个小彩蛋:方法名 add_insighs 拼写错误(app/tool/chart_visualization/data_visualization.py:148)。
7. 生产视角与小结
三件套的生产注意事项汇总:浏览器路径首选 browser-use MCP 插件(BrowserContextHelper 是旧架构遗迹,新代码不要基于它扩展);搜索的 60 秒全链休眠发生在工具调用的观察值等待里——Agent 一轮 step 可能因此挂一分钟以上,生产上应把 retry_delay 调小、把重试轮数交给上层 Agent 循环消化(app/tool/web_search.py:223-232);可视化管线部署前必须显式检查 npx ts-node 可用,否则工具只会在运行时报 Node.js Error(app/tool/chart_visualization/data_visualization.py:261),并尽快修掉 required: ["code"](app/tool/chart_visualization/data_visualization.py:49)。
回到本篇的母题——内核与易变能力的解耦。三个模块给出了三种答案:浏览器把整块能力外包给 MCP 插件(连进程都是外部的);搜索用"配置 + 回退链 + 全集兜底"把供应商不确定性关进工具内部;可视化用子进程把语言生态差异关在管线边界上。三种手法共同的底层逻辑:主进程只认稳定契约(MCP 协议 / 引擎接口 / stdin-stdout JSON),不稳定的东西留在边界之外。
下一篇解剖让浏览器插件成为可能的机制本身:MCP。OpenManus 既是 MCP 客户端(消费 browser-use、文件系统等外部工具),又是 MCP 服务端(把自己的 bash/editor 暴露给 Claude Desktop 等外部 Agent),run_mcp.py 甚至同时扮演两者——一条自举回路。
关键源码事实:
# 事实 位置 1 BrowserAgent 继承 MCPAgent,浏览器能力 = uvx 拉起的 browser-use CLI MCP 插件 app/agent/browser.py:95-1032 BrowserAgent.run() 懒初始化(sessions 空则补连接) app/agent/browser.py:111-1143 截图注入 memory 后立即置 None(consume-once 防重复计费) app/agent/browser.py:61-674 BrowserContextHelper 面向沙箱浏览器(旧路径遗迹),依赖 sandbox_browser 工具 app/agent/browser.py:16-195 引擎顺序 = 配置主引擎 → 配置回退 → 字典剩余全集兜底 app/tool/web_search.py:360-3856 三层重试:单引擎 tenacity×3 / 跨引擎顺序回退 / 全链 sleep 60s × 3 轮 app/tool/web_search.py:387-389, 290-327, 252-2827 fetch_content 用 requests 丢线程池 + BeautifulSoup 清洗 + 10000 字符截断 app/tool/web_search.py:127-1498 SearchResponse 用 model_validator 把结构化结果渲染成文本 output(一份数据两种视图) app/tool/web_search.py:64-1039 status="success"是幽灵字段:未声明、Pydantic v2 静默忽略app/tool/web_search.py:261-26310 可视化两工具接力:Python 清洗出 csv+json → Node npx ts-node 渲染(VMind) app/tool/chart_visualization/chart_prepare.py:4-38(对照data_visualization.py:244-261)11 LLM 配置透传给 Node 子进程:一次可视化消耗两次 LLM 调用 app/tool/chart_visualization/data_visualization.py:227-23112 schema required: ["code"]与 execute 签名(json_path)不符,误导 LLM 传参app/tool/chart_visualization/data_visualization.py:49, 196-20213 方法名拼写错误 add_insighs app/tool/chart_visualization/data_visualization.py:14814 多图并发 asyncio.gather,错误聚合不中断成功项 app/tool/chart_visualization/data_visualization.py:114-146

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 7
 0
- 0


 已为社区贡献8条内容

所有评论(0)