
第 2 篇:「一个 toml 走天下」—— 配置系统与多供应商 LLM 封装
第 2 篇:「一个 toml 走天下」—— 配置系统与多供应商 LLM 封装
系列:OpenManus 源码级深度解读(master @
3309bf4e416fb1c74b008f3e86494439a31bad53)
本篇覆盖:DeepWiki ch2(Configuration)+ ch4(LLM Integration)
核心源码:app/config.py(372 行)、app/llm.py(766 行)、app/bedrock.py(334 行)、config/config.example.toml(113 行)
阅读本文你将了解: 一个 toml 文件如何驱动七个子系统;Config双检锁单例与 example 回退的利弊;LLM按 config_name 的单例路由如何实现"主模型 + vision 模型"双通道;token 预算控制为何被 tenacity 白白重试 6 次;Bedrock 适配层用 334 行解决什么问题、又留下什么隐患。
1. 为什么值得解剖配置层与 LLM 层
Agent 框架的"配置 + LLM 封装"看起来是最没有技术含量的部分——读文件、发 HTTP 请求。但 OpenManus 这两层藏着不少值得玩味的工程决策:
其一,它是多供应商兼容的最小实现。不引入 litellm 这类统一网关,而是用"OpenAI SDK 为骨架 + Azure/AWS 手工适配"的方式,用不到 1100 行代码接入了 OpenAI 协议、Azure OpenAI、AWS Bedrock、Ollama 四种后端(config/config.example.toml:1-45 的四段注释模板)。这是理解"协议适配层该多薄"的很好参照。
其二,它有两个互相独立的单例:Config 是进程级单例(app/config.py:197-215),LLM 是按 config_name 的命名单例(app/llm.py:174-184)。后者让 Manus(用 default 模型)和浏览器 Agent(用 vision 模型)可以在同一个进程里走不同的 API 端点,这个模式在多模型 Agent 系统里非常实用。
其三,它的 token 预算控制有一个注释与实现背离的真实缺陷(app/llm.py:637-643),是所有用 tenacity 做 LLM 重试的团队都该看一眼的反面教材。
2. Config:双检锁单例与 example 回退
Config 类用标准的双检锁实现线程安全单例:
# app/config.py:197-215
class Config:
    _instance = None
    _lock = threading.Lock()
    _initialized = False

    def __new__(cls):
        if cls._instance is None:
            with cls._lock:
                if cls._instance is None:
                    cls._instance = super().__new__(cls)
        return cls._instance
有意思的是状态标记的分工:_instance 防止对象重复创建,_initialized(类变量)防止 __init__ 重复加载配置——因为 Python 的 __init__ 在单例模式下会被多次调用。config = Config()(app/config.py:372)在模块导入时就完成实例化,这意味着任何 import 到 config 的模块都会触发 toml 解析,配置错误会在启动的第一时间暴露,这算是隐式 import 副作用被正向利用的例子。
配置文件查找逻辑有一个静默回退:
# app/config.py:217-226
@staticmethod
def _get_config_path() -> Path:
    root = PROJECT_ROOT
    config_path = root / "config" / "config.toml"
    if config_path.exists():
        return config_path
    example_path = root / "config" / "config.example.toml"
    if example_path.exists():
        return example_path
    raise FileNotFoundError("No configuration file found in config directory")
零配置可跑是这份设计的善意:新用户 clone 下来不建 config.toml 也能 python main.py 起来。但它同时是一颗生产地雷——config.example.toml 里写着 api_key = "YOUR_API_KEY"(config/config.example.toml:4),忘配 key 的用户会一路跑到 LLM 调用才收到 401,而且日志里看到的是"Authentication failed"而不是"你没写配置文件"。错误被推迟到了最远端才爆炸,这是"静默回退"类设计的典型代价。
3. LLM 多段配置:default + 命名覆盖的合并算法
[llm] 表的解析是整个配置层最精巧的一段。toml 里允许这样写:
# config/config.example.toml:1-7 与 42-45
[llm]
model = "claude-3-7-sonnet-20250219"

[llm.vision]
model = "claude-3-7-sonnet-20250219"
base_url = "https://api.anthropic.com/v1/"
_load_initial_config 把 [llm] 下的标量键收集为 default 设置,把子表(如 [llm.vision])收集为命名覆盖,然后做一层浅合并:
# app/config.py:313-320
config_dict = {
    "llm": {
        "default": default_settings,
        **{
            name: {**default_settings, **override_config}
            for name, override_config in llm_overrides.items()
        },
    },
    ...
}
{**default, **override} 意味着 [llm.vision] 只需写差异字段(比如只换 model 和 base_url),api_key、temperature 等自动继承主配置。消费端只需要一句 config.llm.get(config_name, config.llm["default"])(app/llm.py:191)就能完成路由——配置继承在加载期一次性做完,运行期零开销。
值得对比的是 MCP 配置走了另一条路:mcp 段在 toml 里几乎为空,真正的服务器列表从独立的 config/mcp.json 加载(app/config.py:299-306 调用 MCPSettings.load_server_config(),实现在 app/config.py:148-171)。原因是 MCP server 配置格式要和业界通用的 mcpServers JSON 约定对齐(Claude Desktop 等工具的同一格式),兼容生态格式比统一配置格式更重要——这是个值得记住的取舍。
4. 七类配置段全景
AppConfig(app/config.py:174-194)聚合了七个配置段,各段的关键默认值如下表(均为实测源码值):
| 配置段 | 数据类 | 关键默认值 | 位置 |
|---|---|---|---|
| llm | LLMSettings | max_tokens=4096,temperature=1.0 | app/config.py:19-30 |
| browser | BrowserSettings | disable_security=True,headless=False | app/config.py:69-91 |
| search | SearchSettings | 主引擎 Google,回退 DuckDuckGo→Baidu→Bing | app/config.py:39-60 |
| sandbox | SandboxSettings | python:3.12-slim / 512m / 1.0 CPU / 网络关闭 | app/config.py:94-105 |
| daytona | DaytonaSettings | 云沙箱镜像 whitezxj/sandbox:0.1.0,VNC 密码硬编码 “123456” | app/config.py:108-124 |
| mcp | MCPSettings | servers 从 config/mcp.json 加载 | app/config.py:138-171 |
| runflow | RunflowSettings | use_data_analysis_agent=False | app/config.py:63-66 |
三个默认值值得点名:
temperature=1.0(app/config.py:28)。example toml 里写的是 temperature = 0.0(config/config.example.toml:6),所以实际跑起来是 0——但 Pydantic 层的默认是 1.0。两处默认不一致,意味着"手动构造 LLMSettings 不走 toml"的测试代码会和生产行为不一致。Agent 场景 temperature=1.0 明显偏高(代码生成容易漂移),这个默认值的选择值得商榷。
disable_security=True(app/config.py:71-73)。browser-use 默认关掉浏览器的安全特性(同源策略等),为了让 Agent 能跨域操作页面。这是能力优先于安全的取舍,放在 04 篇浏览器主题里再展开。
Daytona VNC 密码硬编码 “123456”(app/config.py:122-124)。写在 Pydantic Field default 里的密码,几乎不会被用户改掉。云沙箱 + 弱密码的组合在生产环境是不可接受的,06 篇会回头看这个问题。
5. LLM 门面:命名单例与三分支客户端
LLM 类的单例方式和 Config 不同——它按 config_name 维护一个实例字典:
# app/llm.py:174-184
class LLM:
    _instances: Dict[str, "LLM"] = {}

    def __new__(cls, config_name: str = "default", llm_config=None):
        if config_name not in cls._instances:
            instance = super().__new__(cls)
            instance.__init__(config_name, llm_config)
            cls._instances[config_name] = instance
        return cls._instances[config_name]
注意这里直接调用了 instance.__init__()——绕过了 Python 正常的构造协议。配套地,__init__ 里用 if not hasattr(self, "client") 防止重复初始化(app/llm.py:189)。这种"手动 orchestration"写法比 Config 的双检锁更紧凑,但代价是初始化逻辑不经过 __init__ 的正常调用链,子类化和调试断点都更别扭。两种单例写法并存于同一个代码库,本身就是一个有意思的对照实验。
构造函数的核心是客户端三分支(app/llm.py:216-225):
api_type == "azure"→AsyncAzureOpenAI(多带一个 api_version)api_type == "aws"→BedrockClient()(本地实现,见第 8 节)- 其他一律 →
AsyncOpenAI(api_key, base_url)
第三条分支是整个多供应商策略的基石:只要供应商兼容 OpenAI Chat Completions 协议(DeepSeek、Qwen、GLM、Ollama、vLLM……),零适配代码直接接入。api_type 甚至不做校验——example toml 里的 jiekou.ai 段没有写 api_type,走的就是这条默认分支。这个设计的含义是:适配成本被压到了"写四行 toml",换来的是新供应商接入零代码。
LLM(config_name="vision") 的第二个实例就是这么来的:浏览器 Agent 等需要看图的组件用 vision 配置段,主 Agent 用 default 段,两个实例各自维护独立的 client、tokenizer 和 token 计数器,互不干扰。命名单例在此处不是炫技,是多模型 Agent 的刚需。
tokenizer 初始化有一个降级(app/llm.py:209-214):tiktoken.encoding_for_model(self.model) 查不到预设(Claude、国产模型必然查不到)时回退 cl100k_base。对 GPT 系模型计数精确,对其他模型只是估算——token 预算控制在非 OpenAI 模型上天然带 5-15% 的误差,后面第 7 节的预算机制全部建立在这个估算之上。
先把这两层的关系画出来:Config 单例持有 AppConfig 聚合根,七个配置段里只有 llm 是必填的字典结构(支持多命名实例),其余六段全部 Optional;LLM 命名单例从 Config.lll 字典里按名字取配置,运行期只依赖选定的 client 外壳——AsyncOpenAI / AsyncAzureOpenAI / BedrockClient 三选一,对上层暴露同一套 chat.completions.create 属性链:
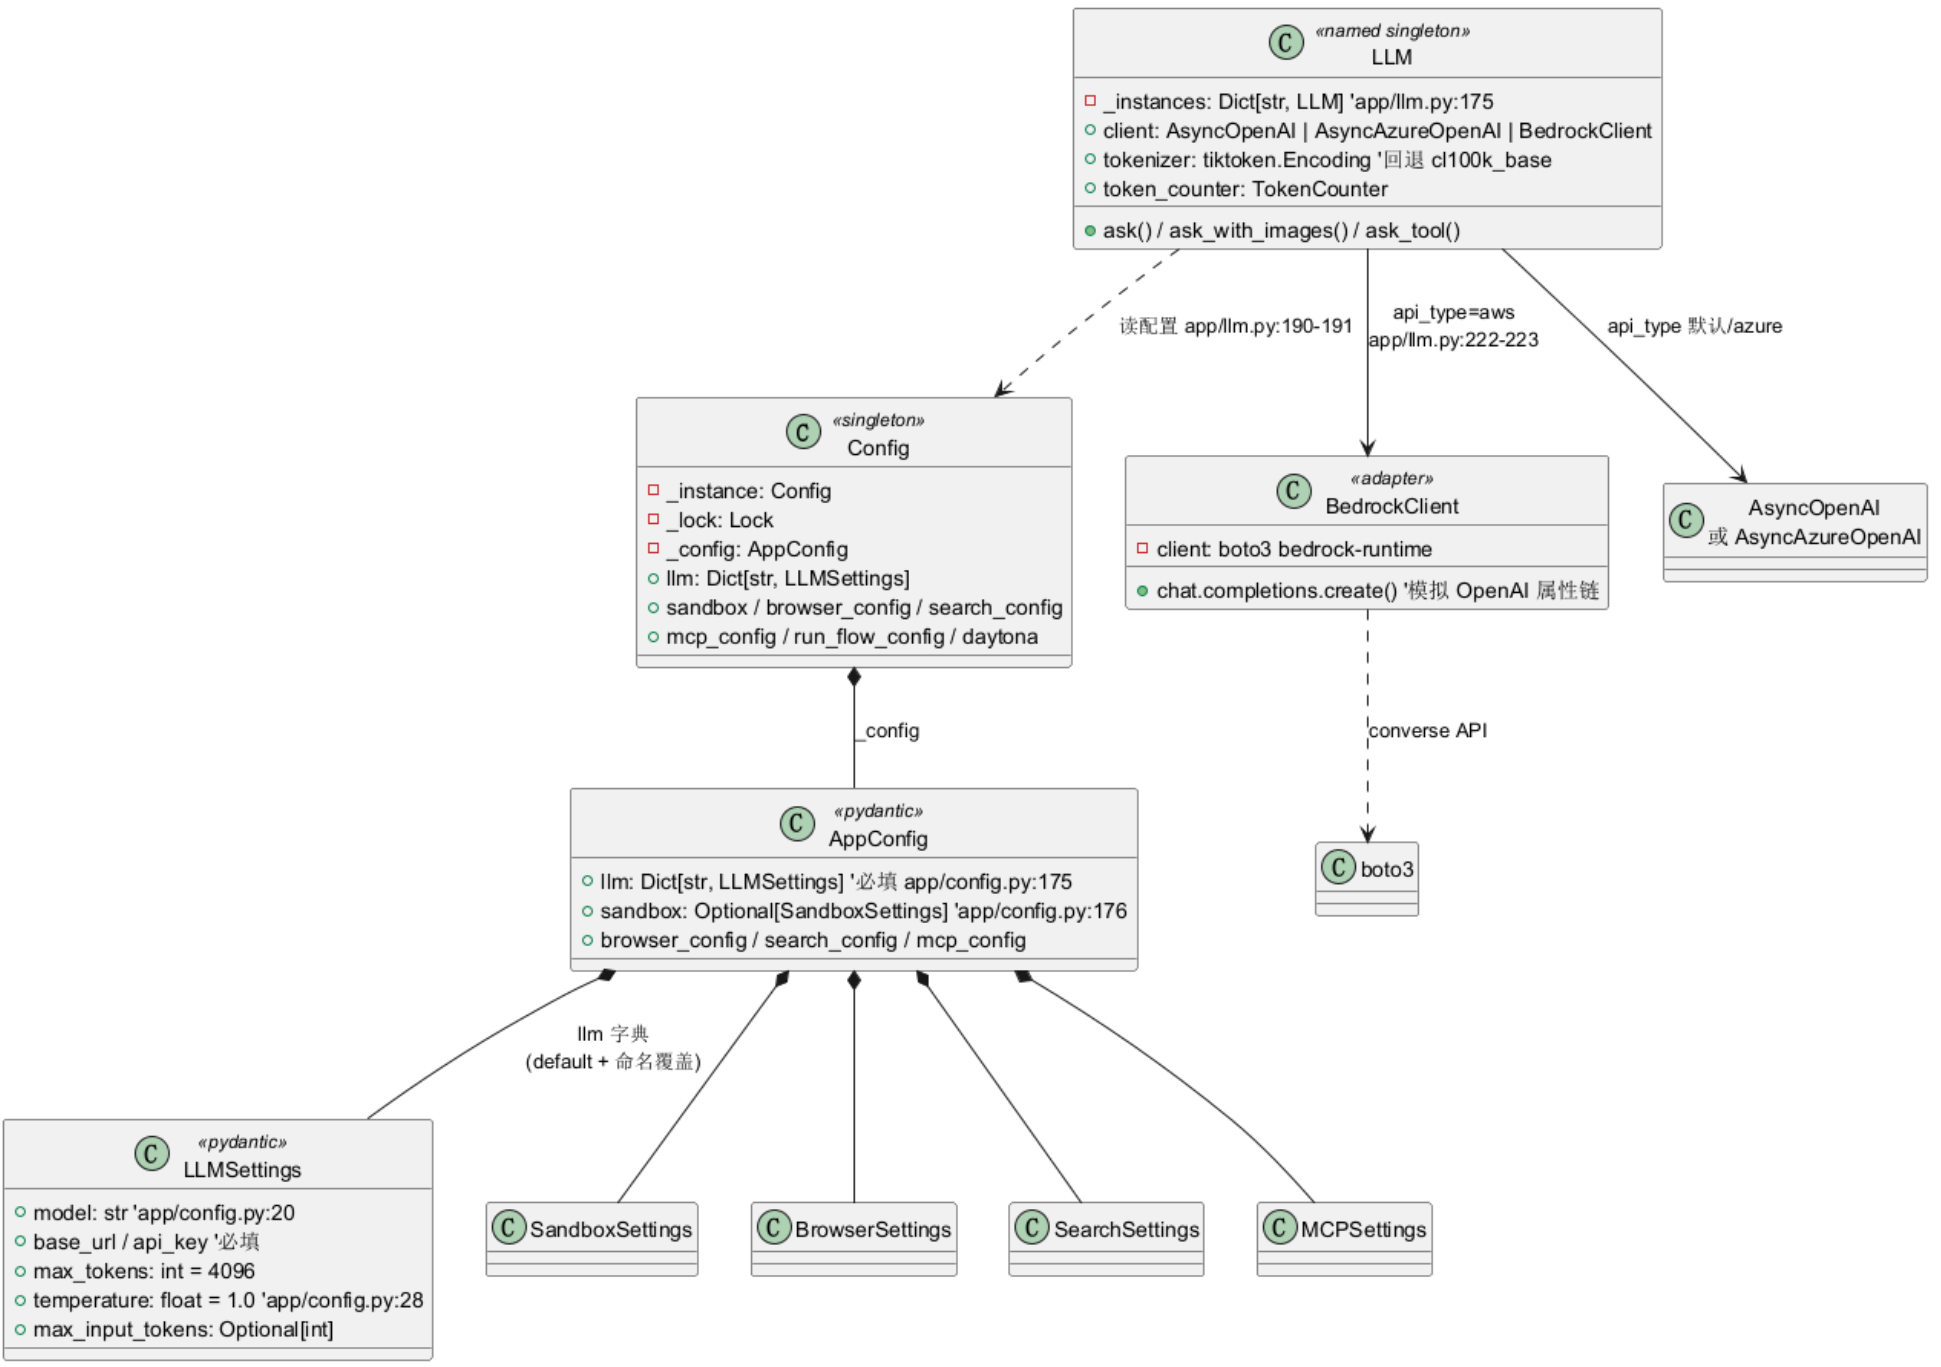
图上有两处结构信息值得停留:一是 AppConfig 里只有 llm 字段是必填的字典,其余段全部 Optional——配置系统的权重分布一目了然,LLM 配置是唯一"配错就起不来"的段;二是 LLM 到 client 的三条依赖线不是继承而是组合,三个 client 外壳没有共同基类,全靠鸭子类型约束接口一致,这正是 Bedrock 适配能"不改 LLM 主层"的结构前提,也是它没有编译期保障的风险来源。
6. TokenCounter:消息与图片的 token 估算
TokenCounter(app/llm.py:45-171)把 OpenAI 的计费规则翻译成了本地估算器,三块逻辑:
文本:每条消息 4 个基础 token + 2 个格式 token + role/正文/tool_call 参数逐段 encode(app/llm.py:147-171)。这个"每条消息固定开销"的模型和 OpenAI 官方文档的计费说明一致。
图片:low detail 固定 85 token;high detail 按"缩到 2048 内 → 短边缩到 768 → 数 512px tile(每块 170)→ +85"计算(app/llm.py:64-116)。这是对 OpenAI vision 计费公式的忠实复刻,注释里连公式步骤都写全了(app/llm.py:68-74)。
工具 schema:不算在 TokenCounter 里,而是 ask_tool 里直接对工具定义做字符串计数(app/llm.py:694-699):
# app/llm.py:694-699(节选)
tools_tokens = 0
if tools:
    for tool in tools:
        tools_tokens += self.count_tokens(str(tool))
input_tokens += tools_tokens
str(tool) 把整个工具 JSON schema 序列化后数 token——粗糙(schema 的 JSON 语法符号也计费了),但在"工具描述占掉几千 token"的 Agent 场景里,这个方向的误差是保守的(多算不少算),对预算控制反而是安全的。
7. token 预算与重试:一处注释与实现背离的缺陷
预算控制的调用链是:请求前估算 input_tokens → check_token_limit(app/llm.py:249-254,max_input_tokens 未配置时永远通过)→ 超限抛 TokenLimitExceeded(app/exceptions.py:12-14,继承自 Exception)→ 期望它不被重试直接击穿。
问题出在 tenacity 装饰器上:
# app/llm.py:637-643(ask_tool 的装饰器,ask/ask_with_images 同型)
@retry(
    wait=wait_random_exponential(min=1, max=60),
    stop=stop_after_attempt(6),
    retry=retry_if_exception_type(
        (OpenAIError, Exception, ValueError)
    ),  # Don't retry TokenLimitExceeded
)
注释写着 “Don’t retry TokenLimitExceeded”,但 retry_if_exception_type 的语义是**“命中列表中的类型才重试”**,列表里的 Exception 是几乎所有异常的基类——TokenLimitExceeded 继承自 Exception,必然命中,照样重试满 6 次,每次还要经历最长 60 秒的指数退避等待。也就是说一次明确的"预算超限"失败要等上几十秒到几分钟才能被上层感知。
上层确实为这个场景做了补丁:ToolCallAgent.think() 捕获 RetryError 后检查 __cause__ 是否为 TokenLimitExceeded,是则置 FINISHED 优雅停车(app/agent/toolcall.py:60-73,01 篇第 7 节已分析)。补丁能兜底,但"超限→重试 6 次→RetryError→再识别"这条链路白白消耗了几分钟。
正确的写法应该是反向条件:retry=retry_if_not_exception_type(TokenLimitExceeded)。这个 bug 的教学价值在于:tenacity 的 retry 条件列表里放宽基类时,注释声明的意图已经不重要了,类型关系决定一切。事实上 ValueError 在列表里也是冗余的——它同样是 Exception 的子类。
把 ask_tool 一次调用的完整控制流画出来,预算检查和重试的咬合关系会更直观:
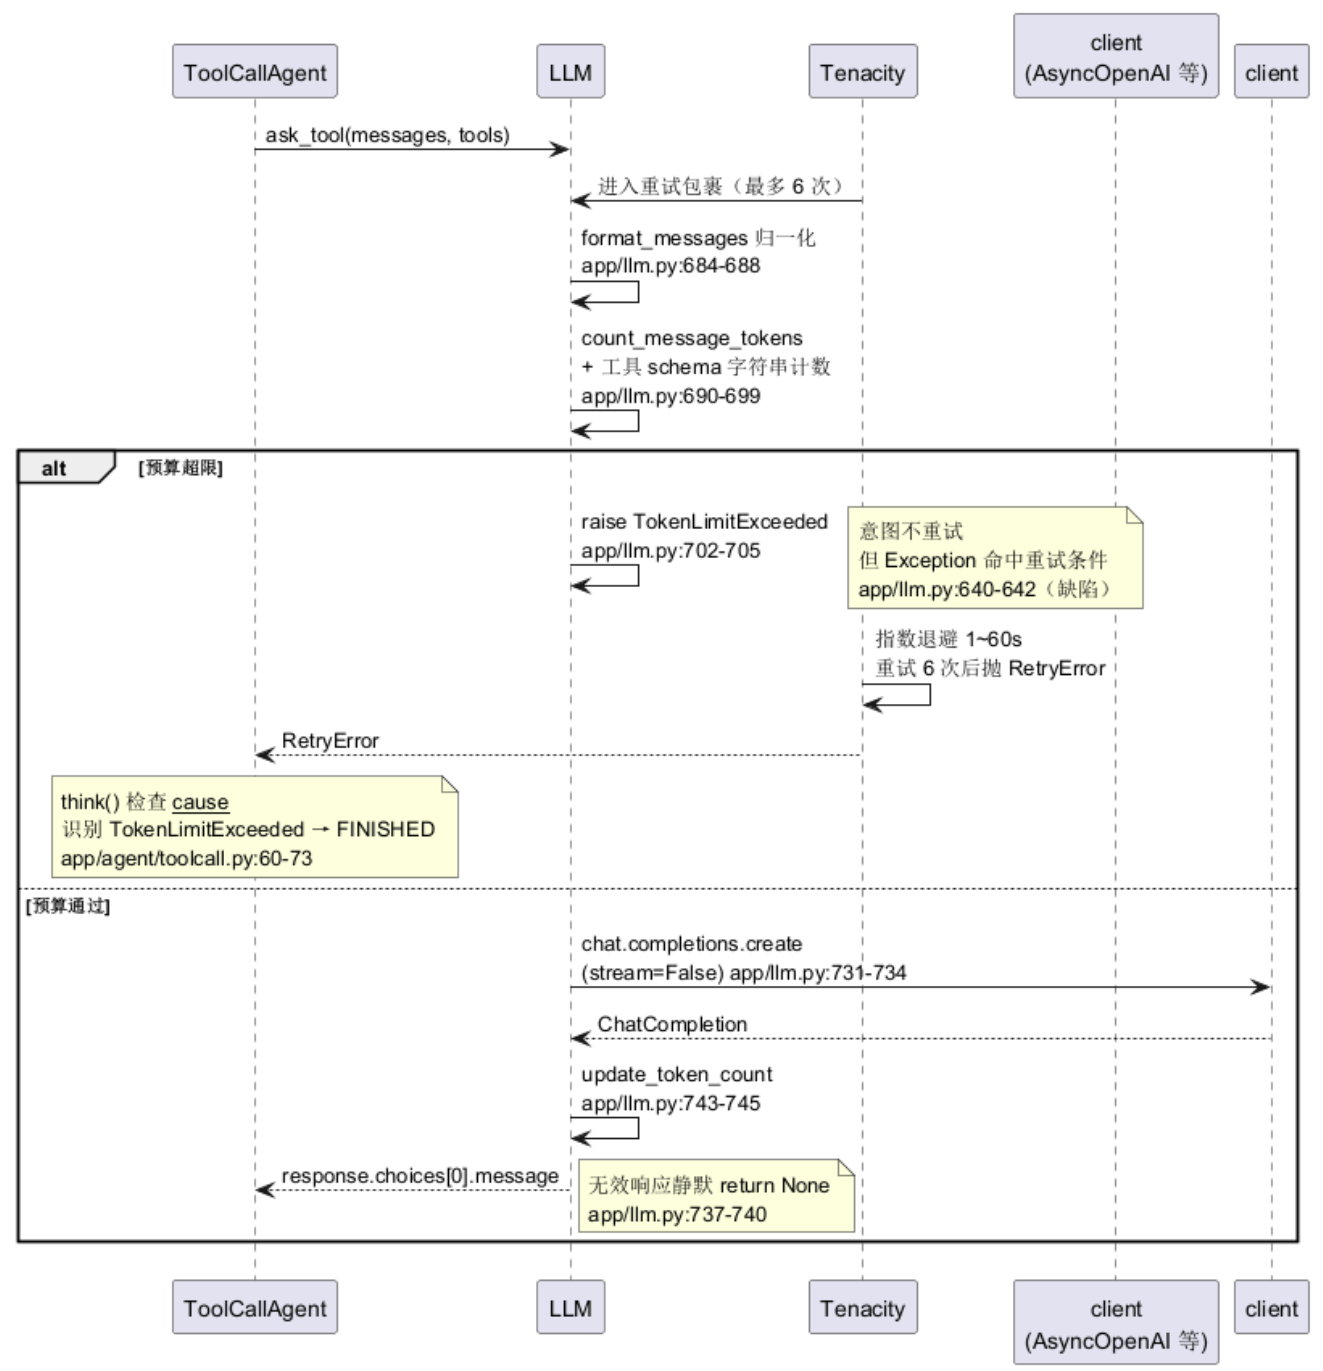
这张时序图把本篇最重要的两个缺陷串在了同一条链路上:预算超限路径(左分支)里,TokenLimitExceeded 本该直达上层,却被 tenacity 的重试条件拦下重跑 6 次,最后以 RetryError 的包装形态到达 ToolCallAgent,迫使上层再做一次 __cause__ 解包;正常路径(右分支)里,无效响应的静默 return None 则让"LLM 响应损坏"和"模型决定不调工具"在调用方看来毫无区别。预算机制设计是对的,错误传播路径是漏的——这是对这套 LLM 门面最准确的一句概括。
8. 三个 ask:一套门面、三种协议形态
LLM 对外暴露三个入口,差异用一张表说清:
| 方法 | 协议形态 | 流式 | 图片 | 重试 | 关键位置 |
|---|---|---|---|---|---|
ask | 纯文本 chat | 默认 True | 自动识别 | 6 次 | app/llm.py:354-479 |
ask_with_images | 多模态 content 数组 | 默认 False | 显式传入 | 6 次 | app/llm.py:481-635 |
ask_tool | function calling | 强制 False | 自动识别 | 6 次 | app/llm.py:637-766 |
三个方法共享同一套前置逻辑:format_messages 归一化(含 base64_image 到 OpenAI image_url content 的转换,app/llm.py:304-339,不支持图片的模型则静默丢弃图片字段)、token 估算、预算检查。差异点在后半段。
ask 的流式直打 stdout。ask 默认 stream=True,chunk 用 print(chunk_message, end="", flush=True) 直接打到标准输出(app/llm.py:446)。Demo 里这是"实时看到 Agent 思考"的爽点;生产里这是日志污染源——流式内容和 logging 的输出会交错在同一控制台。流式路径的 completion token 是事后估算的(app/llm.py:453-458,因为流式响应没有 usage 字段)。
ask_with_images 有一个硬编码模型清单。多模态判定靠 MULTIMODAL_MODELS 列表(app/llm.py:35-42),清单里是 gpt-4o 和 claude-3 早期型号。这意味着 claude-3.7-sonnet(example toml 的默认模型)不在清单里,ask_with_images 会直接抛 “does not support images”(app/llm.py:518-521)。这是硬编码清单模式的典型腐化:模型迭代速度远超清单维护速度。相比之下 ask/ask_tool 的 supports_images = self.model in MULTIMODAL_MODELS(app/llm.py:388,681)只是决定要不要内嵌 base64 图片,判定失误的后果轻得多。
ask_tool 强制非流式(app/llm.py:731 的 params["stream"] = False),因为 function calling 需要完整解析 tool_calls 结构。它还有一个值得警惕的分支:
# app/llm.py:737-740
if not response.choices or not response.choices[0].message:
    print(response)
    # raise ValueError("Invalid or empty response from LLM")
    return None
无效响应静默返回 None,raise 被注释掉,print(response) 是调试残留。调用方 ToolCallAgent.think() 对 None 的处理是当"无工具调用"走文本分支——LLM 响应损坏时 Agent 不会报错,而是把这轮当成"模型决定只说话"。错误被降级成了行为怪异,排查时非常隐蔽。
reasoning 模型分支:REASONING_MODELS = ["o1", "o3-mini"](app/llm.py:34)命中时参数换成 max_completion_tokens 且不带 temperature(app/llm.py:723-729,o1 系不接受 temperature)。清单式判定在这里问题不大(o1 系参数约定稳定),但和 MULTIMODAL_MODELS 一样属于"代码追着模型清单跑"的模式。
9. Bedrock 适配:334 行换一层协议
app/bedrock.py 解决一个具体问题:AWS Bedrock 的 Converse API 与 OpenAI SDK 的接口形态不同,但 LLM 的代码按 OpenAI SDK 的 self.client.chat.completions.create(...) 调用。适配策略是给 BedrockClient 造一个同构的接口外壳:
# app/bedrock.py:37-46(节选)与 app/llm.py:222-223
class BedrockClient:
    def __init__(self):
        self.client = boto3.client("bedrock-runtime")
        self.chat = Chat(self.client)

# LLM 侧无缝挂载
elif self.api_type == "aws":
    self.client = BedrockClient()
BedrockClient.chat.completions.create() 这个调用链完全模仿 OpenAI SDK 的属性路径(app/bedrock.py:/1-58),内部做三件事:OpenAI 消息 → Bedrock Converse 格式的转换(app/bedrock.py:/1)、OpenAI tools → Bedrock toolSpec 转换(app/bedrock.py:/1-84)、调 client.converse / converse_stream(app/bedrock.py:/1-218, 220-240)。响应侧用 OpenAIResponse 把 Bedrock 返回的 dict 动态包装成属性访问对象(app/bedrock.py:/1-34),让 response.choices[0].message.content 这类链式取值成立。
这个"鸭子类型协议适配"的取舍很清晰:不改 LLM 主层一行代码,把协议差异全部关进 334 行的适配文件。但实现质量明显是"能跑"级别:
- 初始化失败直接
sys.exit(1)(app/bedrock.py:/1-46)——一个库模块在 import 链里杀进程,单元测试都无法隔离。 CURRENT_TOOLUSE_ID = None模块级全局变量跨请求传递 tool use ID(app/bedrock.py:/1-13),注释自己承认 “Tmp solution”——并发场景下必然串号。- 认证完全依赖 AWS 环境变量(boto3 默认链),
api_key配置项形同虚设(example toml 里注释了 “Required but not used for Bedrock”,config/config.example.toml:15)。
对读源码的人来说,这个文件是"适配层应该多薄"的反面参照:同构外壳的思路是对的,但用全局变量传状态、用 sys.exit 处理错误,说明它还没经历过生产打磨。
10. 生产视角:上生产前要改的四件事
结合第 3-9 节的源码事实,如果你要基于这层做生产系统,按优先级:
第一,修 token 重试。把三个 retry 装饰器的条件改为 retry_if_not_exception_type(TokenLimitExceeded)(app/llm.py:354-360, 481-487, 637-643 三处)。一行改动,省掉每次预算超限的数分钟等待。
第二,配置回退加告警。_get_config_path 回退 example 时至少打一条 WARNING(app/config.py:223-225),或者干脆在生产构建里禁掉回退。同时把 temperature 的 Pydantic 默认从 1.0 降到 0.x,与 example 对齐(app/config.py:28)。
第三,堵 ask_tool 的 None 分支。return None 改回 raise,或者在 ToolCallAgent 层对 None 显式计数告警(app/llm.py:737-740)。静默吞错误的代价会在最难排查的时刻显现。
第四,token 计数器分实例监控。update_token_count 只打日志不落指标(app/llm.py:238-247),生产上要把 total_input_tokens/total_completion_tokens 接到 metrics 系统——它已经按 LLM 实例天然分好了维度(default/vision 各自独立计数),接线上几乎是现成的。
11. 进阶视角:扩展点与同类对比
加一个新供应商:兼容 OpenAI 协议的(绝大多数国产大模型)只需一段 toml(api_type 留空走默认分支);不兼容的(Bedrock 型)参照 app/bedrock.py 写同构外壳,在 app/llm.py:216-225 加一个分支。不要去改三个 ask 方法——协议差异应该全部被 client 外壳吸收。
加一个配置段:照 SearchSettings 的模式做四步——定义 Pydantic 模型(app/config.py:39-60)、挂到 AppConfig(app/config.py:174-194)、_load_initial_config 里读段并兜底默认(app/config.py:284-312)、加 property(app/config.py:331-359)。注意 MCP 段的 JSON 双文件模式只在需要兼容外部生态格式时才值得。
与同类对比:MetaGPT 用 YAML + 更重的配置继承体系,LangChain 的多供应商靠 partner package 各自实现,litellm 用统一网关 + router。OpenManus 的"OpenAI 骨架 + 少量手工适配"处在轻量端——代价是 Bedrock 这类协议差异大的后端适配质量粗糙(第 9 节),收益是依赖极少(只依赖 openai + boto3)、代码可全部读完。对"要读懂每一行"的学习场景,这个取舍是对的;对要多供应商负载均衡的生产场景,应该换 litellm 或自建 router。
另一个值得吸收的模式是命名单例做模型路由(第 5 节)。在多 Agent 系统里,"主 Agent 用便宜模型、浏览器用 vision 模型、planner 用强推理模型"是普遍需求,LLM._instances 字典 + 配置继承(第 3 节)用 30 行代码把这个需求做完了,比引入模型路由框架轻得多。
12. 小结与承上启下
这篇的两个单例(Config 进程级、LLM 命名级)、一个合并算法(default+override)、一个协议外壳(Bedrock 同构适配),构成了 OpenManus "一个 toml 走天下"的全部骨架。它的设计哲学和 01 篇的执行引擎一脉相承:用最少的抽象层解决问题,把复杂度留给最值得的地方——所以你会看到它宁可手写 334 行 Bedrock 适配也不引入 litellm,宁可 toml 浅合并也不上配置继承框架。
代价也如实记录在本篇:重试条件背离(app/llm.py:637-643)、ask_tool 静默 None(app/llm.py:737-740)、MULTIMODAL 清单腐化(app/llm.py:35-42)。这些不是"开源项目难免的瑕疵",而是最小抽象策略的固有成本:抽象层薄了,漏出来的毛边就直接暴露在调用方。
下一篇我们下沉到工具生态:BaseTool 如何用 Pydantic 元数据自动生成 OpenAI function calling 的 schema,ToolCollection 如何管理 20+ 工具的生命周期,以及 PythonExecute 为什么宁可起子进程也要 5 秒超时。
关键源码事实:
# 事实 位置 1 Config 双检锁单例,_initialized 防重复加载 app/config.py:197-2152 config.toml 缺失静默回退 config.example.toml app/config.py:217-2263 LLM 配置 default + 命名覆盖浅合并 app/config.py:313-3204 MCP servers 单独从 config/mcp.json 加载 app/config.py:148-171, 299-3065 LLM 按 config_name 命名单例(_instances 字典) app/llm.py:174-1846 客户端三分支:azure/aws/默认 AsyncOpenAI app/llm.py:216-2257 tiktoken 无预设回退 cl100k_base(非 OpenAI 模型计数为估算) app/llm.py:209-2148 图片 token:low=85,high=512px tile × 170 + 85 app/llm.py:45-1169 重试条件含 Exception,TokenLimitExceeded 实际被重试 6 次(与注释意图相反) app/llm.py:637-64310 ask_tool 强制 stream=False;无效响应静默 return None(raise 被注释) app/llm.py:731, 737-74011 MULTIMODAL_MODELS 硬编码到 claude-3 早期型号,example 默认模型不在列 app/llm.py:35-4212 Bedrock 用同构外壳模拟 OpenAI SDK 属性链,converse 换协议 app/bedrock.py:37-58, 195-21813 Bedrock 适配用模块级全局变量传 tool use ID(自注 Tmp solution);init 失败 sys.exit(1) app/bedrock.py:11-13, 44-4614 Daytona VNC 密码默认硬编码 “123456”;browser 默认 disable_security=True app/config.py:122-124, 71-73

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 13
 0
- 0


 已为社区贡献8条内容

所有评论(0)