
第 1 篇:「三小时原型」的执行引擎—— think-act 循环全景解剖
第 1 篇:「三小时原型」的执行引擎—— think-act 循环全景解剖
系列:OpenManus 源码级深度解读(master @
3309bf4e416fb1c74b008f3e86494439a31bad53)
本篇覆盖:DeepWiki ch1(Introduction / Getting Started / System Architecture / Execution Modes)+ ch3.1(BaseAgent and ToolCallAgent)
核心源码:app/agent/base.py(197 行)、app/agent/react.py(39 行)、app/agent/toolcall.py(259 行)、app/agent/manus.py(204 行)
阅读本文你将了解: 一条用户指令从main.py进入后,如何在 197 行的BaseAgent.run()主循环里变成一连串 LLM 调用与工具执行;状态机如何保证可重入;卡死检测如何工作;Terminate终止协议如何让子类工具反向控制父类循环。
1. 为什么值得解剖 OpenManus 的执行引擎
OpenManus 的 Agent 执行引擎全部加起来不到 700 行 Python,却完整实现了 ReAct 范式的工业级落地:状态机、内存管理、卡死检测、工具路由、终止协议、资源清理一应俱全。它没有引入任何 Agent 框架依赖(没有 LangChain、没有 LlamaIndex),只靠 Pydantic + openai SDK 就把 think-act 循环写成了一个可以被继承扩展的微型内核。
这个内核的类继承链只有三层,但每层职责切得非常干净:
BaseAgent(抽象:状态机 + run 主循环 + 内存)
  └── ReActAgent(抽象:think / act 二分)
        └── ToolCallAgent(实现:LLM 工具调用 + 结果回填)
              ├── Manus(通用主力:Python 执行 / 文件编辑 / 人工追问 / MCP 动态工具)
              ├── MCPAgent / BrowserAgent / DataAnalysis / SandboxAgent / SWEAgent(垂直特化)
先给结论:OpenManus 的执行引擎本质是一个"带内存的有限状态机 + 每步一次 LLM 决策 + 决策产物(tool_calls)的同步执行器"。下面逐层验证。
2. 三条入口,一个内核
仓库提供四个入口文件,但最终都汇入同一个 run() 循环。
main.py 是最短的一条:17 行创建 Agent,26 行跑循环,32 行兜底清理:
# main.py:17-32
agent = await Manus.create()
try:
    prompt = args.prompt if args.prompt else input("Enter your prompt: ")
    if not prompt.strip():
        logger.warning("Empty prompt provided.")
        return
    logger.warning("Processing your request...")
    await agent.run(prompt)
    logger.info("Request processing completed.")
except KeyboardInterrupt:
    logger.warning("Operation interrupted.")
finally:
    # Ensure agent resources are cleaned up before exiting
    await agent.cleanup()
注意两个细节。其一,Manus.create() 是异步工厂方法(app/agent/manus.py:75-81),而不是普通构造函数——因为创建时要同步完成 MCP 服务器的连接(后续文章展开)。其二,cleanup() 放在 finally 而不是 except 之后,保证 Ctrl+C 也会释放 MCP 连接。
run_flow.py 是多 Agent 编排入口:它在 12-16 行组装 agent 字典,然后通过工厂创建 PlanningFlow 并以 3600 秒总超时执行(run_flow.py:32-35)——值得留意的是 run_flow.py:13 直接写 Manus() 而没走 create(),MCP 初始化被延迟到首次 think() 时懒加载兜底(app/agent/manus.py:197-203),这是理解该框架"构造与初始化分离"设计的关键线索。
run_mcp.py 和 sandbox_main.py 分别服务 MCP 工具动态加载与沙箱模式,本篇先按下不表。
3. Agent 继承体系:每一层只做一件事
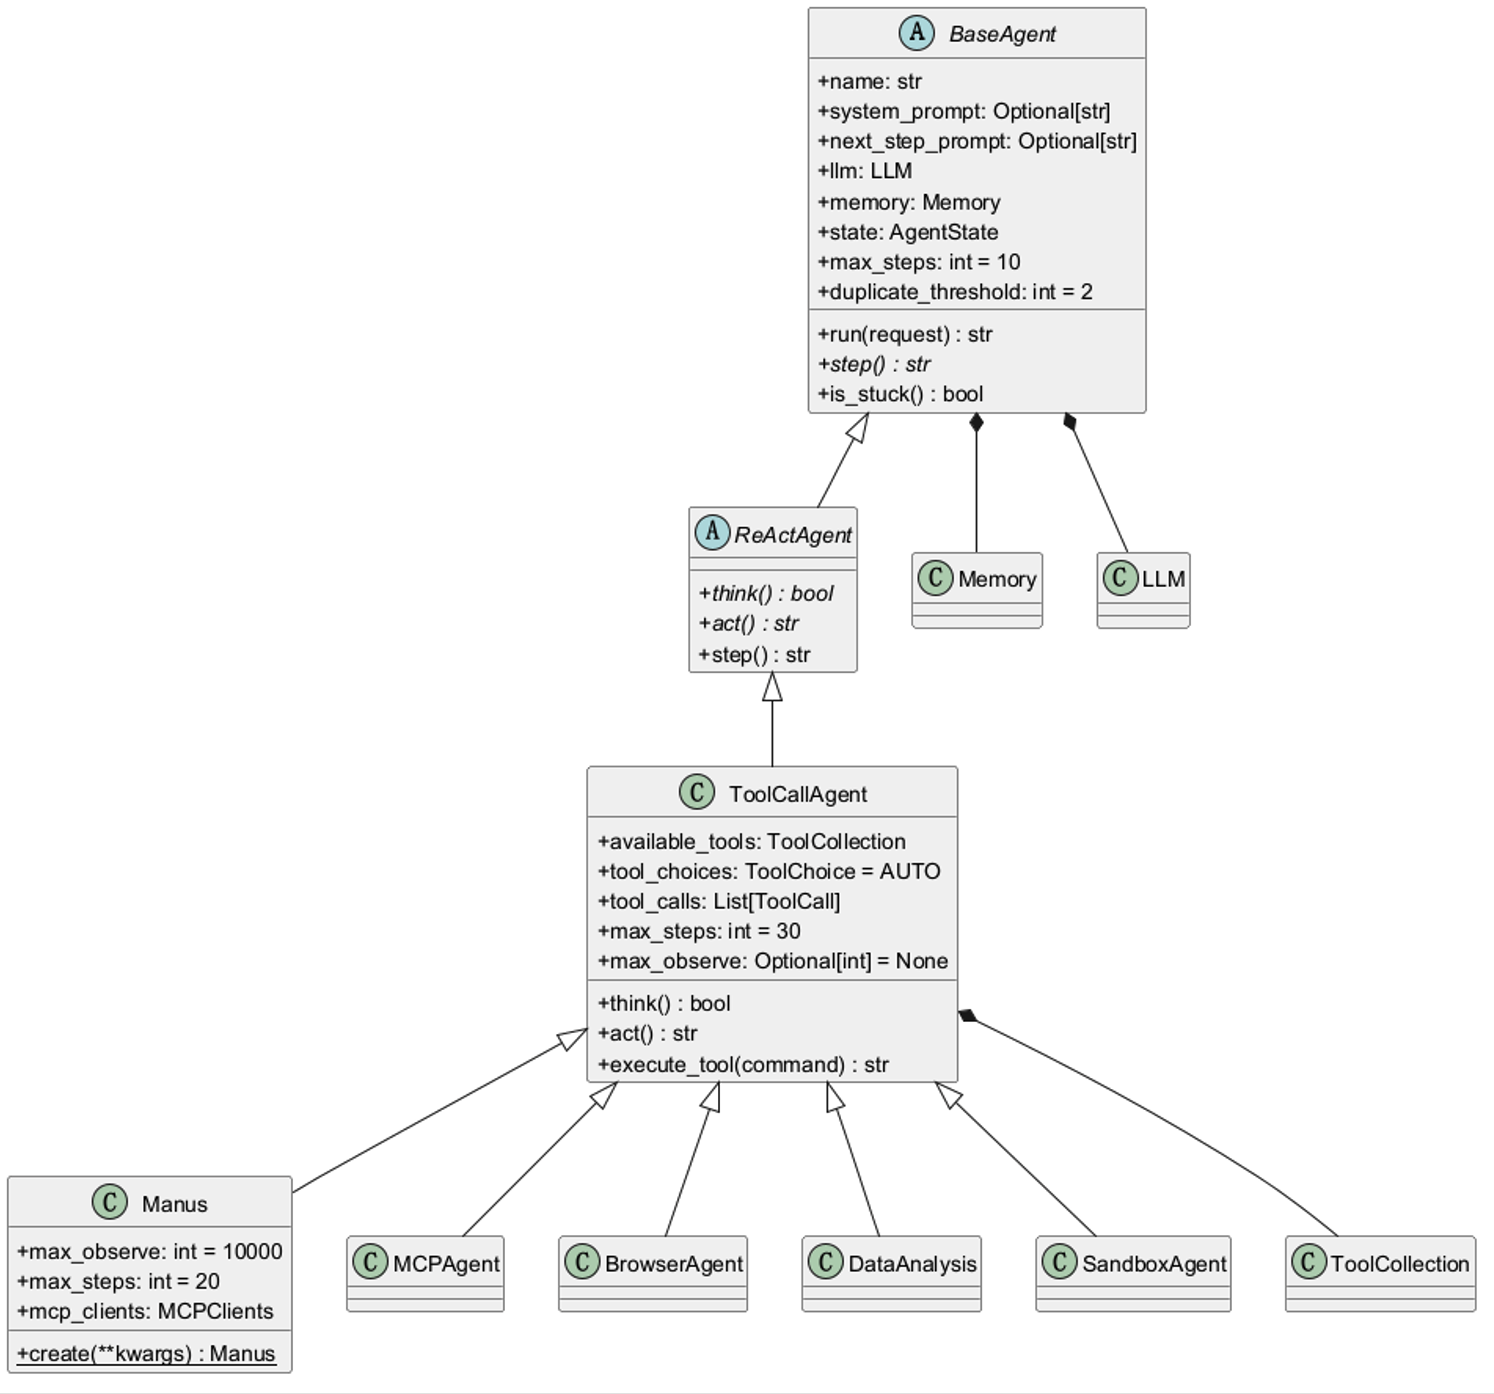
这张类图回答的问题是:700 行内核如何在保持 open-closed 的同时衍生出六个垂直 Agent。BaseAgent(app/agent/base.py:13)只管"怎么跑"(状态机 + 循环 + 内存),ReActAgent(app/agent/react.py:11)只管"跑一步是什么"(think/act 二分),ToolCallAgent(app/agent/toolcall.py:18)只管"think 和 act 怎么落到工具调用上"。六个子类(Manus/MCPAgent/BrowserAgent/DataAnalysis/SandboxAgent/SWEAgent)全部只做一件事:装配不同的 available_tools、system_prompt 与超参,不碰循环逻辑。如图所示,ToolCollection 与 Memory 是组合关系而非继承——工具集可以运行时增删(MCP 场景),这是后续 MCP 篇的伏笔。
一个容易被忽略的细节:BaseAgent 继承自 BaseModel(Pydantic),Agent 本身就是一个可校验、可序列化的数据模型(app/agent/base.py:13)。llm 和 memory 用 Field(default_factory=...) 声明(app/agent/base.py:33-34),避免 Pydantic 可变默认值共享的坑;而 initialize_agent 这个 model_validator(mode="after")(app/agent/base.py:49-56)在模型构造完成后按 agent 名字小写去配置里找对应的 LLM 配置段(self.llm = LLM(config_name=self.name.lower()))——这就是"每个 Agent 可以用不同模型"的实现机制。
4. BaseAgent.run():主循环与状态机的咬合
run() 是整个框架唯一的主循环,197 行的 base.py 里它占 39 行(116-154):
# app/agent/base.py:116-154
async def run(self, request: Optional[str] = None) -> str:
    if self.state != AgentState.IDLE:
        raise RuntimeError(f"Cannot run agent from state: {self.state}")

    if request:
        self.update_memory("user", request)

    results: List[str] = []
    async with self.state_context(AgentState.RUNNING):
        while (
            self.current_step < self.max_steps and self.state != AgentState.FINISHED
        ):
            self.current_step += 1
            logger.info(f"Executing step {self.current_step}/{self.max_steps}")
            step_result = await self.step()

            # Check for stuck state
            if self.is_stuck():
                self.handle_stuck_state()

            results.append(f"Step {self.current_step}: {step_result}")

        if self.current_step >= self.max_steps:
            self.current_step = 0
            self.state = AgentState.IDLE
            results.append(f"Terminated: Reached max steps ({self.max_steps})")
    await SANDBOX_CLIENT.cleanup()
    return "\n".join(results) if results else "No steps executed"
四个设计点值得逐个拆。
第一,重入保护。128-129 行要求只有 IDLE 状态才能起跑,否则抛 RuntimeError。这把"并发跑同一个 Agent"这类事故挡在了入口。
第二,state_context 的异常安全语义。app/agent/base.py:58-82 的上下文管理器做三件事:进入时切换状态、异常时置 ERROR 再重新抛出、finally 时回滚到进入前的状态:
# app/agent/base.py:58-82(节选)
async def state_context(self, new_state: AgentState):
    if not isinstance(new_state, AgentState):
        raise ValueError(f"Invalid state: {new_state}")
    previous_state = self.state
    self.state = new_state
    try:
        yield
    except Exception as e:
        self.state = AgentState.ERROR  # Transition to ERROR on failure
        raise e
    finally:
        self.state = previous_state  # Revert to previous state
最后这行 finally 产生一个反直觉但合理的行为:在 step 内部被置为 FINISHED 的状态,在 run() 返回后会被回滚成 IDLE。也就是说 AgentState.FINISHED 只是循环的退出信号(app/agent/base.py:137 的 while 条件),不是终态——Agent 跑完一轮后自动"复位",可以接下一个任务。这是用最小代码实现 Agent 可重入的典型手法。
第三,卡死检测内嵌在循环里。每一步之后立刻检查 is_stuck()(app/agent/base.py:144-145)。它的判定逻辑在 app/agent/base.py:170-186:取内存中最后一条 assistant 消息,倒序数它与历史 assistant 消息内容完全相同的次数,达到 duplicate_threshold(默认 2,app/agent/base.py:43)即判定卡死。卡死后 handle_stuck_state()(app/agent/base.py:163-168)把一段"Observed duplicate responses. Consider new strategies…"的前缀插到 next_step_prompt 头部——注意是前缀插入而非替换,每卡死一次就叠一层,这个设计在长会话里会让 next_step_prompt 越来越长,属于可观察到的工程取舍(见第 9 节 FAQ)。
第四,循环体外的资源清理。app/agent/base.py:153 的 await SANDBOX_CLIENT.cleanup() 在 state_context 结束后执行,无论正常结束还是异常都会释放沙箱连接——这是全局单例沙箱客户端的统一出口,与 ToolCallAgent.run() 里逐工具的 cleanup()(app/agent/toolcall.py:253-258)形成两级清理。
5. AgentState 状态图
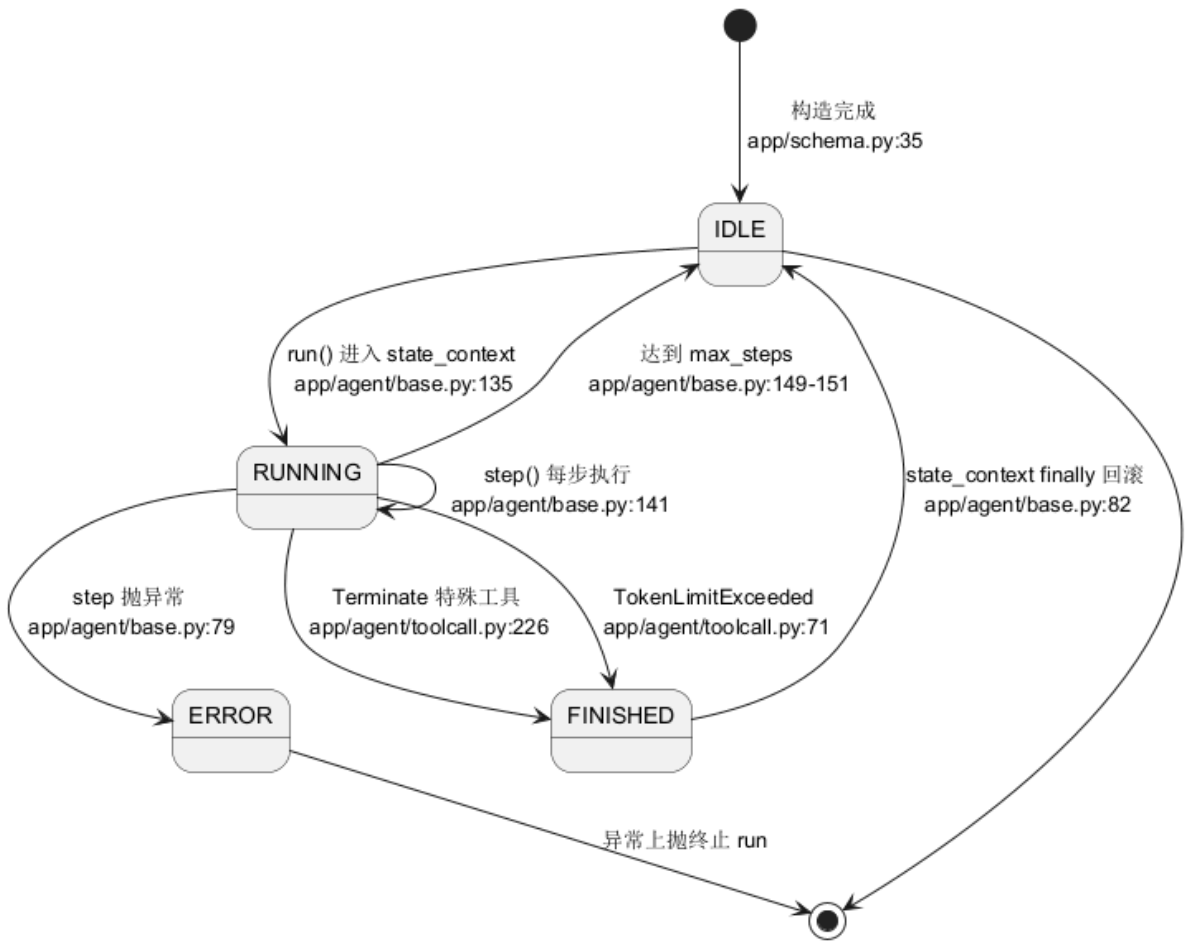
这张状态图的核心信息是:FINISHED 和 ERROR 的生命周期完全不同。FINISHED 是循环内的瞬时信号,被 state_context 的 finally 回滚为 IDLE(所以图中 FINISHED → IDLE 这条边存在);ERROR 则发生在 state_context 内部 yield 抛异常时,置完 ERROR 后异常继续上抛,run() 直接终止,状态停在 ERROR(下次再 run() 会被 128 行的重入保护拒绝)。理解这一点才能解释为什么崩溃后的 Agent 无法原地复活——没有代码把 ERROR 拉回 IDLE,这是框架刻意留给你在业务层处理的决策点。
6. ToolCallAgent.think():一次 LLM 决策的完整解剖
think() 是框架的心脏,app/agent/toolcall.py:39-129 共 91 行。它回答一个问题:这一步该干什么。流程分四段。
第一段:注入下一步提示(39-43 行)。next_step_prompt 每一步都作为 user 消息追加进内存——意味着内存里的对话序列是 user(任务) → user(next_step) → assistant → tool → user(next_step) → ... 的重复模式。
第二段:调用 LLM(47-56 行):
# app/agent/toolcall.py:45-56
try:
    # Get response with tool options
    response = await self.llm.ask_tool(
        messages=self.messages,
        system_msgs=(
            [Message.system_message(self.system_prompt)]
            if self.system_prompt
            else None
        ),
        tools=self.available_tools.to_params(),
        tool_choice=self.tool_choices,
    )
注意 system_prompt 不是常驻内存的,而是每次请求时临时拼在 system_msgs 里发出去——内存里永远不存 system 消息(MCP server instructions 是唯一例外,见 app/agent/manus.py:166-170),这个设计让内存截断逻辑不用关心 system 消息的保护问题。
第三段:Token 超限的错误传播链(57-73 行)。这里有一条跨层协作:LLM.ask_tool 在请求前用 TokenCounter 预估输入 token 并对照 max_input_tokens(app/llm.py:690-705),超限抛 TokenLimitExceeded;异常穿透 tenacity 重试层被包成 RetryError 后,think() 通过检查 e.__cause__ 识别出它(app/agent/toolcall.py:60-72),往内存写一条 assistant 消息说明原因并把状态置为 FINISHED——用状态机而不是异常来优雅停车,避免用户看到 traceback。
第四段:按 tool_choices 三分支消化响应(96-121 行):
NONE模式:模型硬要调工具时只打 warning(97-100 行),有文本就当纯文本返回True;REQUIRED模式:没有 tool_calls 也返回True(114-115 行),注释写明"Will be handled in act()"——把校验延迟到 act 抛ValueError(app/agent/toolcall.py:133-135);AUTO模式:没有 tool_calls 时return bool(content)(118-119 行),有内容也算"想清楚了"。
无论哪个分支,assistant 消息(含 tool_calls)都会在 107-112 行入内存——决策与决策产物必须同时持久化,这是后续 tool 消息能用 tool_call_id 配对的前提。
7. act() 与 execute_tool():结果回填与错误兜底
act()(app/agent/toolcall.py:131-172)遍历 self.tool_calls 逐个执行,每个结果包装成 Message.tool_message(带 tool_call_id 和工具名)回填内存。三个值得注意的机制:
观察截断:max_observe 非 None 时结果被硬切片 result[: self.max_observe](app/agent/toolcall.py:148-149)。ToolCallAgent 默认不截断(37 行),Manus 设为 10000 字符(app/agent/manus.py:50)——防止浏览器抓取、文件读取这类工具把上下文撑爆。
图片旁路:工具结果里的 base64_image 不走 tool_message(OpenAI 协议的 tool 消息不支持图片),而是攒进 image_messages,在所有工具执行完后以 user 消息身份批量入内存(app/agent/toolcall.py:162-171)。截图类工具(browser/sandbox vision)靠这个旁路把画面喂给多模态模型。
执行器兜底:execute_tool()(app/agent/toolcall.py:174-216)把所有异常都吞成字符串错误消息——JSON 解析失败返回 “Error parsing arguments…”(207-212 行),其他异常返回 “Error: ⚠️ Tool … encountered a problem”(213-216 行)。工具永远不让 Agent 崩溃,错误本身就是喂给 LLM 的观察,模型下一轮会看到错误文本并自行调整——这是 ReAct 自愈能力的实现基础。
8. 终止协议与 Terminate 工具
框架的终止不是外部条件判断,而是一个反向控制协议:工具执行完成后回调 Agent 的状态机。
# app/agent/toolcall.py:218-235
async def _handle_special_tool(self, name: str, result: Any, **kwargs):
    """Handle special tool execution and state changes"""
    if not self._is_special_tool(name):
        return
    if self._should_finish_execution(name=name, result=result, **kwargs):
        # Set agent state to finished
        logger.info(f"🏁 Special tool '{name}' has completed the task!")
        self.state = AgentState.FINISHED

@staticmethod
def _should_finish_execution(**kwargs) -> bool:
    """Determine if tool execution should finish the agent"""
    return True
Terminate 工具本身极简(app/tool/terminate.py:23-25 只返回一句确认文本),真正的终止动作发生在 _handle_special_tool。special_tool_names 默认只含 terminate(app/agent/toolcall.py:31),子类可以注册更多特殊工具;_should_finish_execution 是留给子类的钩子——比如某些工具希望"只在特定结果时终止",覆写它即可,不用碰循环。
与 Terminate 配套的还有 AskHuman(app/tool/ask_human.py:20-21,直接 input() 阻塞等用户输入)和 CreateChatCompletion(app/tool/create_chat_completion.py:8-30,用工具调用协议强制模型按指定类型输出结构化结果——它是 ToolCallAgent 默认工具集的两个成员之一,见 app/agent/toolcall.py:27-29)。
9. Manus:装配层的教科书示例
app/agent/manus.py:41-73 展示了"特化一个 Agent 只需要改装配":
# app/agent/manus.py:47-66(节选)
class Manus(ToolCallAgent):
    name: str = "Manus"
    description: str = "A versatile agent that can solve various tasks using multiple tools including MCP-based tools"

    system_prompt: str = SYSTEM_PROMPT.format(directory=config.workspace_root)
    next_step_prompt: str = NEXT_STEP_PROMPT

    max_observe: int = 10000
    max_steps: int = 20

    # MCP clients for remote tool access
    mcp_clients: MCPClients = Field(default_factory=MCPClients)

    # Add general-purpose tools to the tool collection
    available_tools: ToolCollection = Field(
        default_factory=lambda: ToolCollection(
            PythonExecute(),
            StrReplaceEditor(),
            AskHuman(),
            Terminate(),
        )
    )
三处对比很有信息量。max_steps 从 30 降到 20(对照 app/agent/toolcall.py:36)——通用助手任务比裸工具调用场景更收敛。默认工具集只有 4 个:Python 执行、文件编辑(str_replace_editor)、人工追问、终止;浏览器能力不放在本地工具里,而是在 initialize_mcp_servers()(app/agent/manus.py:83-99)里检测到未配置 browser_use MCP server 时自动用 uvx browser-use --cli-mcp 拉起一个 stdio MCP 进程接入——浏览器是插件不是内核。system_prompt 注入 workspace_root(47 行),把"初始目录"写死进人设,让文件操作类工具有统一的工作区语义。
MCP 服务器返回的 instructions 会被转成 system 消息插入内存并去重(app/agent/manus.py:158-171,用 mcp_instruction_servers 集合防重复注入)——这是内存里唯一会出现 system 消息的路径。
10. Memory 与 Message:上下文的数据契约
app/schema.py 定义了整个引擎的数据底座。Memory(app/schema.py:159-187)是一个带截断的消息列表:
# app/schema.py:159-175
class Memory(BaseModel):
    messages: List[Message] = Field(default_factory=list)
    max_messages: int = Field(default=100)

    def add_message(self, message: Message) -> None:
        """Add a message to memory"""
        self.messages.append(message)
        # Optional: Implement message limit
        if len(self.messages) > self.max_messages:
            self.messages = self.messages[-self.max_messages :]
按条数而非按 token 截断(app/schema.py:167-168)——这是最朴素的上下文管理。它与第 6 节的 token 预算形成互补:max_messages 管"内存条数上限",max_input_tokens 管"单次请求的 token 上限"。两者的缝隙在长会话场景会暴露:截断按条数切,可能把 assistant 的 tool_calls 切掉却留下配对的 tool 消息(或反之),OpenAI 协议会直接 400;max_input_tokens 触发时 TokenLimitExceeded 直接停车而不是做摘要压缩。生产上跑长任务需要自己加滑动窗口或摘要层(本系列收尾篇展开)。
Message(app/schema.py:54-156)重载了 __add__/__radd__,让 self.messages += [user_msg] 这种表达式在 think() 里直接成立(app/agent/toolcall.py:42-43)——小语法糖,但让"消息操作"读起来像原生的列表运算。
11. LLM 门面:token 预算与重试策略
app/llm.py 的 LLM 类是按 config_name 的单例(app/llm.py:174-184,__new__ + _instances 字典),Agent 层用 LLM(config_name=self.name.lower()) 取各自的模型配置。ask_tool()(app/llm.py:644-766)是 think 链路的落点,四个关键行为:
- 请求前 token 预算:输入消息逐条计数(文本用 tiktoken,图片按 OpenAI 的 85/170 token 分块公式,
app/llm.py:64-116),加上工具 schema 的 token(app/llm.py:694-699把每个工具的 JSON schemastr()后计数),超限抛TokenLimitExceeded(702-705 行)——在花钱的 API 调用之前拦截。 - tenacity 重试:三个入口方法都挂
wait_random_exponential(min=1, max=60)+stop_after_attempt(6)(app/llm.py:637-643)。 - 推理模型分支:
REASONING_MODELS = ["o1", "o3-mini"](app/llm.py:34)命中时改用max_completion_tokens且不带 temperature(app/llm.py:723-729)。 - 工具调用永远非流式:
params["stream"] = False(app/llm.py:731)——流式与 tool_calls 解析不兼容的务实选择。
一个值得记录的注释与行为不一致:重试装饰器的注释写着 “Don’t retry TokenLimitExceeded”(app/llm.py:642),但 retry_if_exception_type((OpenAIError, Exception, ValueError)) 中的 Exception 会命中一切异常——包括 TokenLimitExceeded(它继承自 Exception,见 app/exceptions.py:12-14)。app/agent/toolcall.py:60-73 对 RetryError.__cause__ 的检查恰好佐证了这一点:只有经历了完整 6 次重试被 tenacity 包成 RetryError 的异常才会走到那个分支。也就是说 token 超限会白白重试 6 次(每次都必然失败),这是一个真实的性能小瑕疵,改进方式是把重试条件改成显式排除 TokenLimitExceeded。
12. 生产视角:跑长任务前必须知道的四件事
- 温度默认 1.0(
app/config.py:28、app/llm.py:28同默认)——Agent 场景偏高,配合工具调用容易产生参数幻觉,建议生产配置降到 0.3-0.7(config.toml 的[llm]段覆盖)。 - 配置文件有静默回退:
config/config.toml不存在时自动读config.example.toml(app/config.py:217-226)——忘建配置不会报错,而是拿着占位符 API key 跑到认证失败,排查时先看这里。 max_observe是唯一的观察值闸门:不配置时浏览器抓取/文件读取的完整输出会原样进内存,配合max_messages=100的条数截断,上下文成本可能失控。- 卡死检测的提示词叠加(第 4 节):重复卡死会让
next_step_prompt线性膨胀,长会话里放大 token 消耗;需要时覆写handle_stuck_state()改为一次性注入。
13. 进阶视角:扩展点与同类对比
扩展一个新 Agent 的最小改动面:继承 ToolCallAgent,覆写四个类属性(name / system_prompt / available_tools / max_observe)即可——DataAnalysis(app/agent/data_analysis.py)就是这么做的。需要自定义终止条件的,覆写 _should_finish_execution;需要每步前置逻辑的,覆写 think() 并调用 super()(Manus 用这个技巧做 MCP 懒加载,app/agent/manus.py:197-203)。
与同类框架的定位差异(设计取向对比,非性能断言):LangChain 把 ReAct 循环藏在 AgentExecutor 里,扩展要理解回调体系;AutoGPT 把循环、记忆、规划耦合在一起。OpenManus 反着走:循环 39 行可见、可覆写(step() 是唯一抽象方法,app/agent/base.py:156-161),没有回调、没有事件总线、没有隐式控制流——这让它成为读源码学 Harness 的理想标本,代价是缺少生产级的可观测性与持久化(无 checkpoint、无 trace、无 Human-in-the-loop 审批流),这些在收尾篇的系统化对比中展开。
14. 小结与承上启下
本篇打穿了执行引擎的主链路:main.py → Manus.create() → BaseAgent.run() 状态机循环 → ReActAgent.step() 的 think/act 二分 → ToolCallAgent 的 LLM 决策与工具执行 → 终止协议回环。记住三个锚点:FINISHED 是可回滚的信号而非终态(app/agent/base.py:82)、工具错误是喂给 LLM 的观察而非异常(app/agent/toolcall.py:213-216)、token 预算在 API 调用前拦截(app/llm.py:702-705)。
下一篇进入第 2 层:app/config.py 的配置单例与 app/llm.py 的多供应商封装——回答"一套代码怎么同时伺候 OpenAI/Azure/Bedrock/Ollama"。
关键源码事实:
# 事实 出处 1 Agent 是 Pydantic 模型,构造后按 name 小写选 LLM 配置段 app/agent/base.py:13,49-56 2 run() 仅允许 IDLE 起跑,重入抛 RuntimeError app/agent/base.py:128-129 3 state_context 异常置 ERROR、finally 回滚旧状态 app/agent/base.py:74-82 4 卡死判定 = 最后一条 assistant 内容重复 ≥2 次 app/agent/base.py:43,170-186 5 卡死处理是前缀叠加 next_step_prompt app/agent/base.py:163-168 6 system_prompt 请求时临时拼接,不常驻内存 app/agent/toolcall.py:47-53 7 TokenLimitExceeded 经 RetryError.cause 识别后优雅停车 app/agent/toolcall.py:60-73 8 max_observe 硬切片工具观察值,Manus 默认 10000 app/agent/toolcall.py:148-149; app/agent/manus.py:50 9 base64_image 走 user 消息旁路而非 tool 消息 app/agent/toolcall.py:162-171 10 工具异常全部吞成字符串观察值喂回模型 app/agent/toolcall.py:207-216 11 Terminate 经 special_tool_names 反向置 FINISHED app/agent/toolcall.py:218-226 12 Manus 默认 4 工具,浏览器经 uvx browser-use MCP 接入 app/agent/manus.py:57-64,83-99 13 MCP instructions 注入 system 消息并集合去重 app/agent/manus.py:158-171 14 Memory 按条数截断(默认 100 条)而非 token app/schema.py:161,167-168 15 LLM 按 config_name 单例,ask_tool 强制非流式 app/llm.py:174-184,731 16 重试装饰器注释与 Exception 匹配行为不一致,token 超限仍会重试 6 次 app/llm.py:637-643; app/exceptions.py:12-14
FAQ
- Q:为什么
run_flow.py里Manus()不调create()也不会坏? A:think()首次执行时检测_initialized标志懒加载 MCP(app/agent/manus.py:197-203),构造与初始化分离有兜底。 - Q:
FINISHED之后还能继续run()吗? A:能。state_context 回滚后状态是 IDLE(app/agent/base.py:82),直接再 run 即可。 - Q:为什么工具报错不抛异常? A:错误文本会作为观察值进入下一轮 think,让模型自愈;抛异常等于放弃 ReAct 的自愈机会(app/agent/toolcall.py:213-216)。

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 17
 0
- 0


 已为社区贡献8条内容

所有评论(0)