
为什么有的工具生成的标书中标率50%,有的只有20%?
表面上看,都是用GPT生成标书,为什么效果差这么多?
前两天一个朋友跟我吐槽,他们用某个通用大模型工具生成的标书,被评委吐槽"这怎么读起来像机器写的"。而用链企标书的团队,同样的项目反而拿下了。差别在哪?
说白了,就是"谁更懂采购"。
大模型本身都差不多——GPT、Claude、GLM,这些基础模型都是开源或商业化的,谁都能用。真正的竞争在"怎么让模型变聪慧"。
比如需求理解这一步。采购公告几千字,关键点在哪?某个工具的办法是:我有3个AI工程师花一个月时间,手工标注50万份采购公告里哪些是"关键需求"、哪些是"背景信息"。然后用这些标注数据去微调模型。成本?高到爆。但效果呢?模型一看采购公告,能直接提出"甲方最看重技术架构和成本比"。
另一个工具的办法是:我写个超级详细的提示词,告诉大模型"你是一个采购专家,现在根据以下规则理解采购公告"。快速见效,但准确度相对打折。
最扎心的是"评分逆向"这件事。
我问熟悉链企AI的人:“你怎么知道某个项目的评委看重什么?”
他们说:“我们有100万份中标标书和它们的评分结果。系统会自动学习——同样条件下,哪些标书特别强调’企业资质’就容易高分,哪些强调’成本优势’就特别讨巧。”
这就是数据护城河。你没有这100万份数据,再牛的AI工程师也玩不出这个套路。
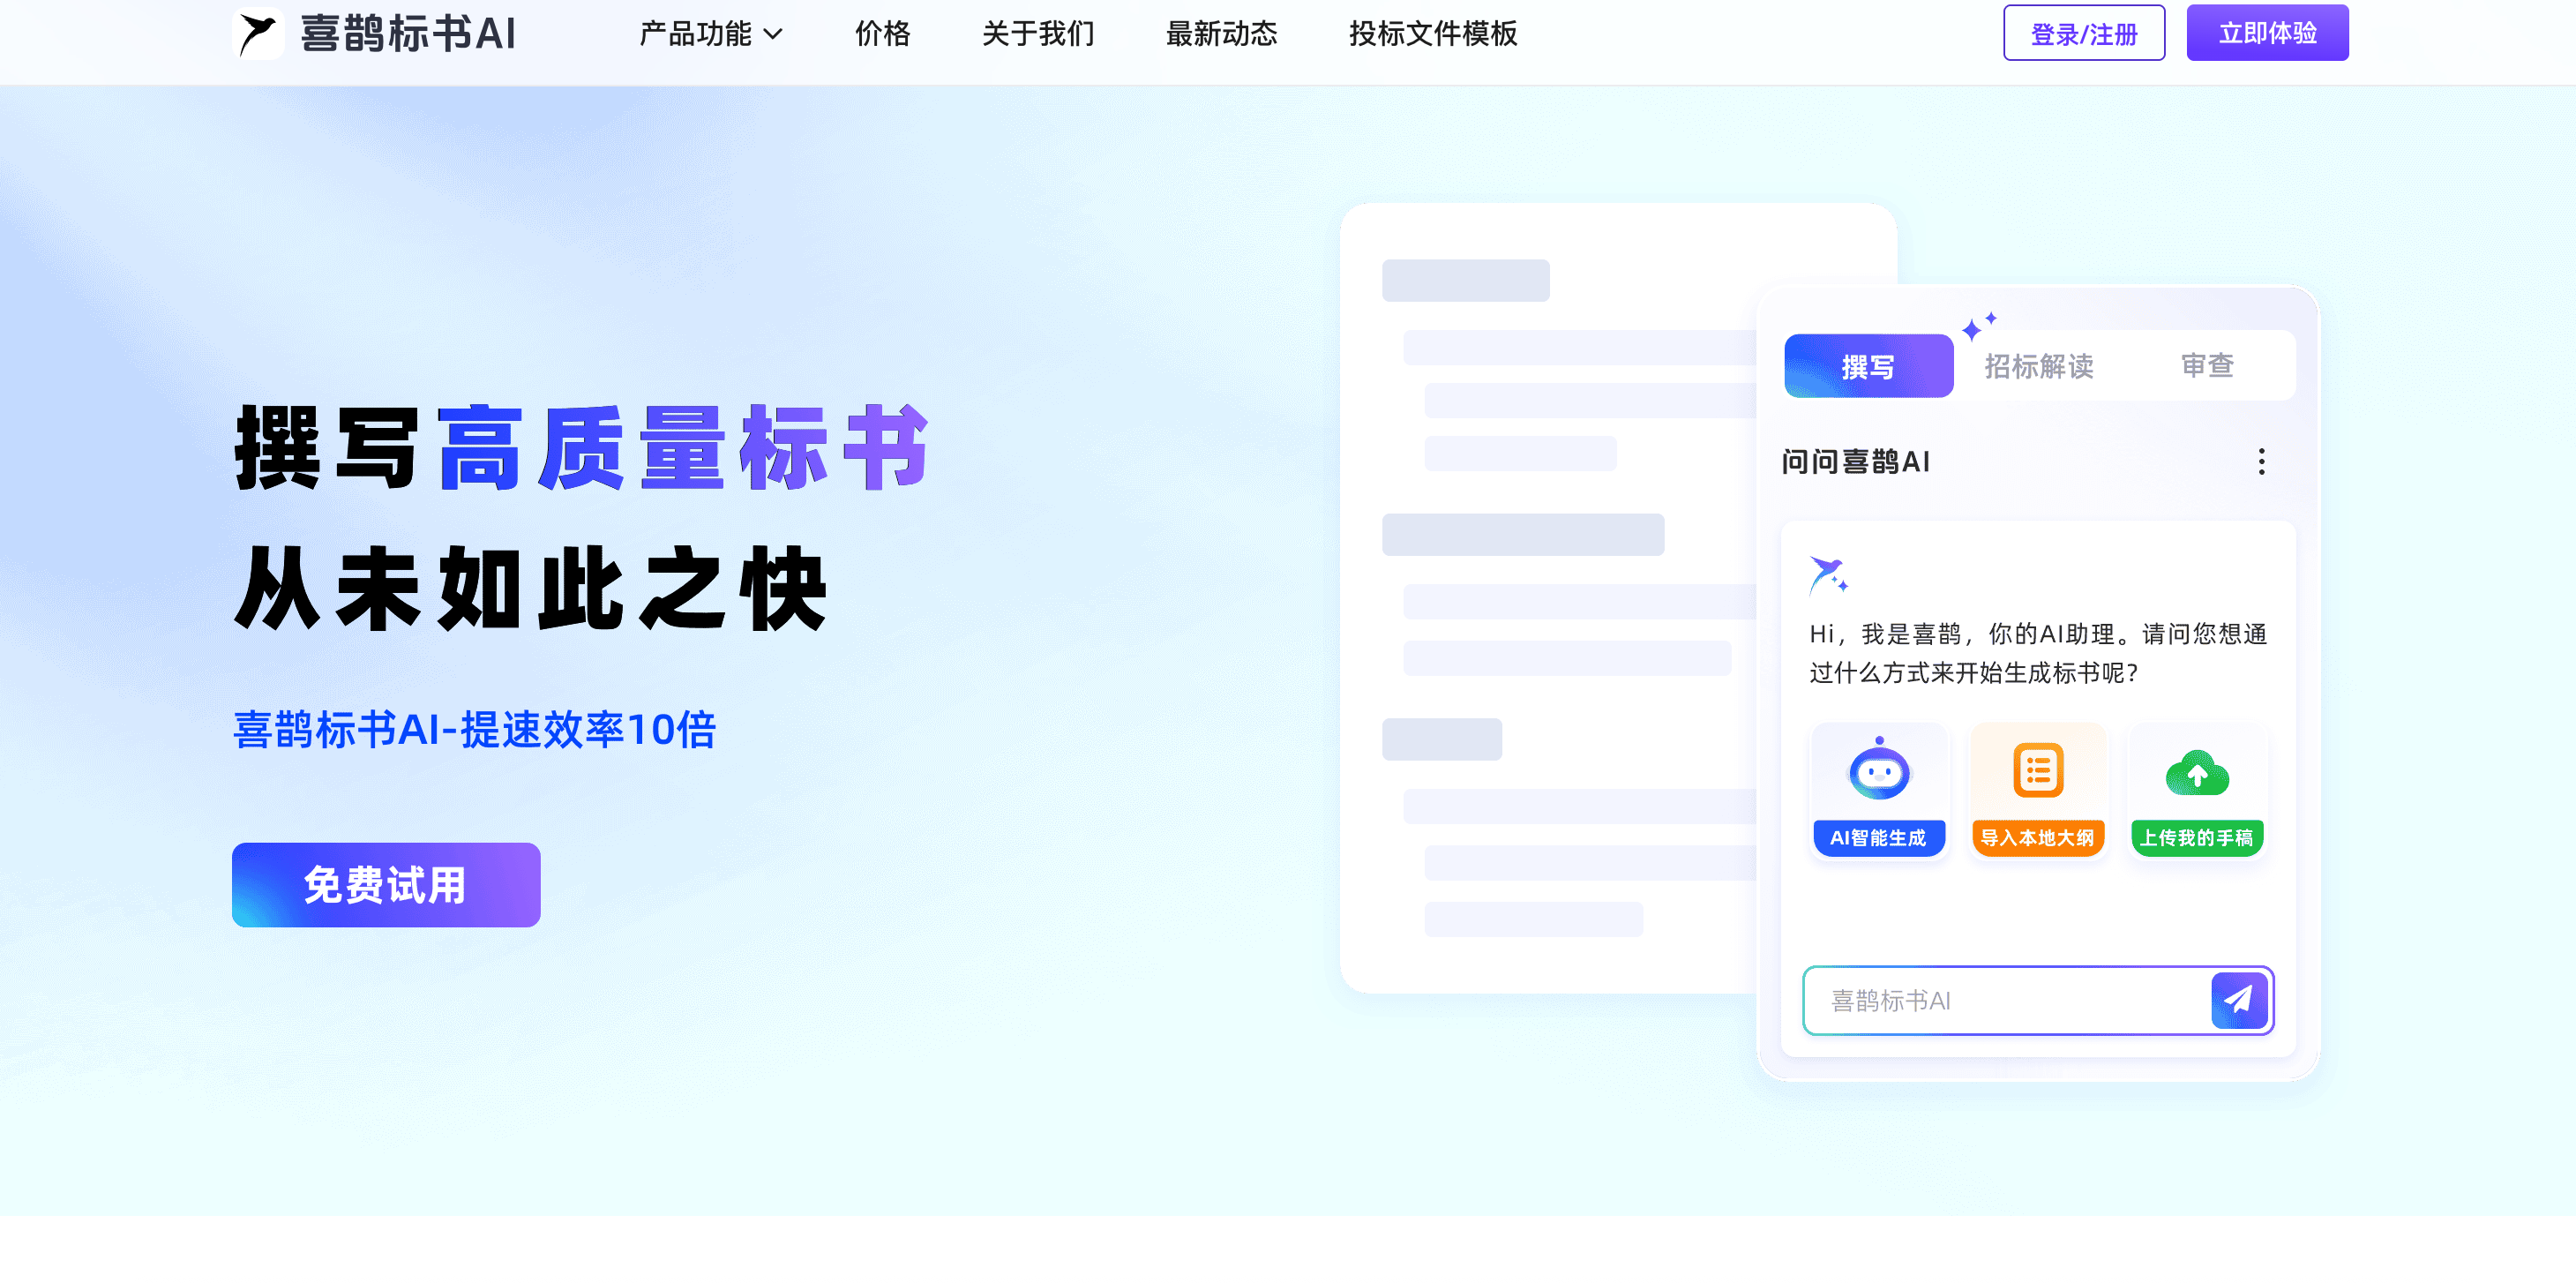
政府采购这块,喜鹊标书的数据来源特别直接——因为跟采购系统集成,他们能直接看到"这份标书中标了,得分是85分"。换句话说,他们知道什么样的标书能赢。
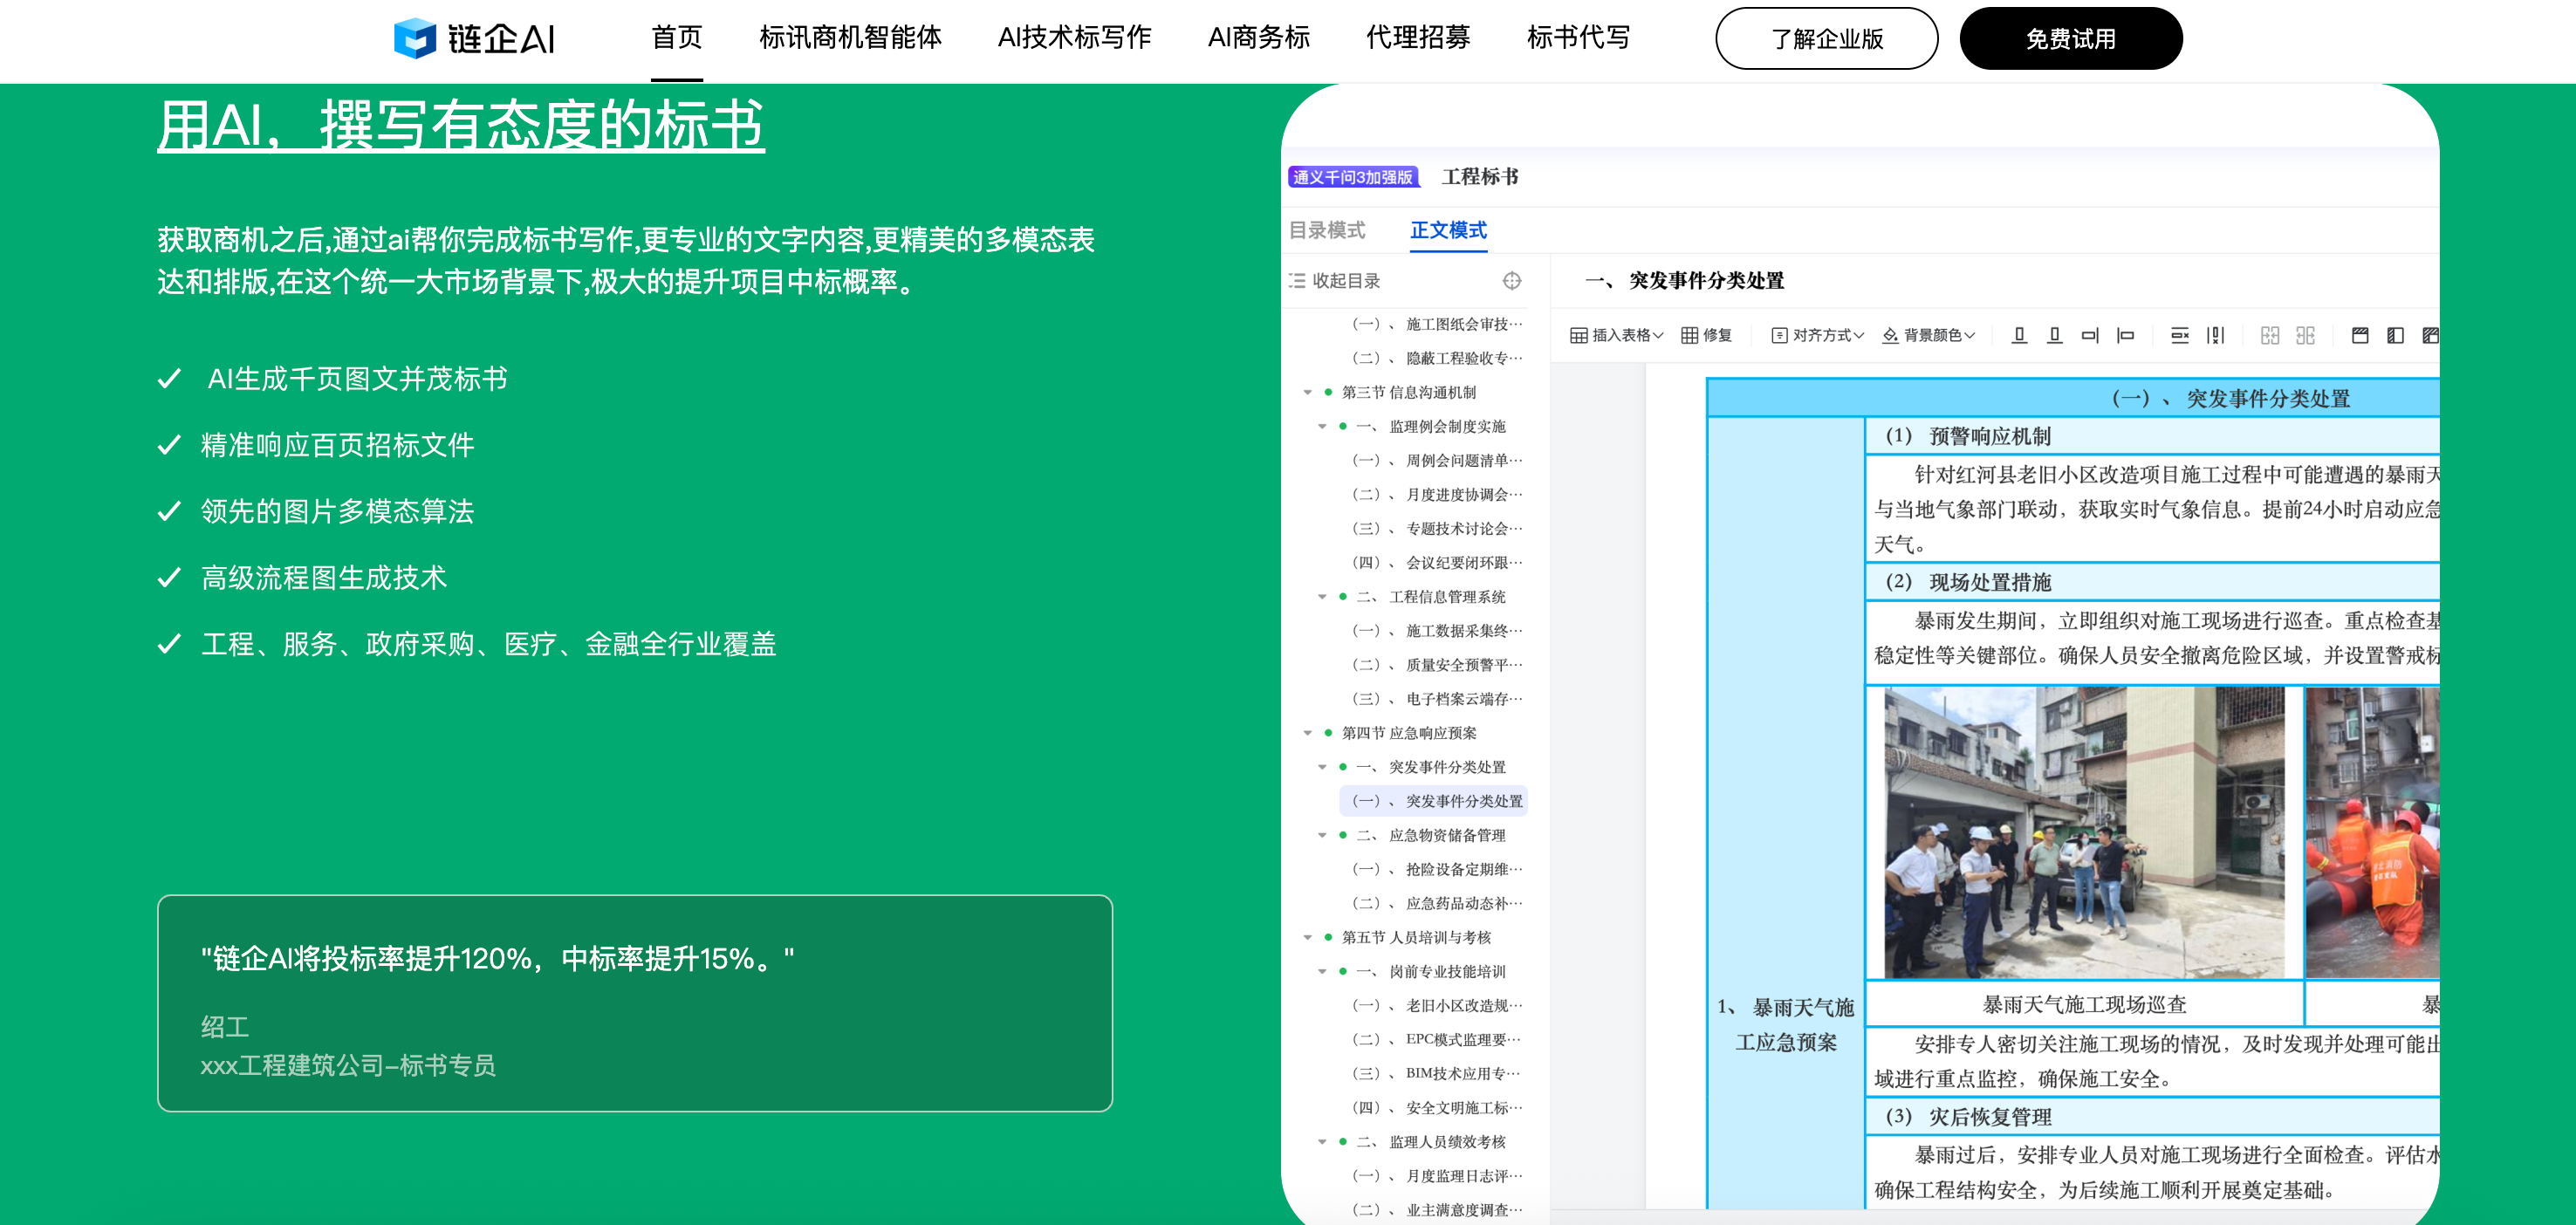
链企虽然没有这个优势,但他们积累了各行各业的企业级采购数据,覆盖面特别广。
政府采购 vs 企业采购,规则还不一样。 政府部门特别看重"程序合规"——某个章节不能漏、某个措辞必须标准化。企业采购则更看重"方案竞争力"——你的成本低不低、方案新不新。一个真正聪慧的工具,看到"这是政府采购项目",就会自动调整策略——强化合规检查、规范措辞。
这就是为什么通用大模型在这里吃亏了。ChatGPT再强,它也不知道"政府采购的某个细节规则"。除非有人花几个月给它做数据标注和微调。
简单说:谁的数据多、谁对采购规则的理解深,谁就能生成更接近"采购方审美"的标书。这不是玄学,就是数据和领域知识的比拼。

AtomGit AI 社区提供模型库、数据集、Agent、Token等资源
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)